GPT-6.2 発表:PPTを再現でき、評価モデルを構築し、3Dモデリングが可能ですが、幻覚率は依然として59%に達しています。
 核心的な視点

 OpenAIはGPT-6.2 AstraとSolを発表しました:AstraはArtificial Analysisで62点に上昇し、世界で2位にランクイン、APIの入力出力が20%値下げされ、PPTを再現し、財務モデリングやBlender 3Dモデリングが可能です。しかし、AA-Omniscienceの幻覚率は59%で、プログラミングインテリジェンス指数は前世代と同じであり、安全性はネットワーク攻撃の「重要な閾値」に達しています。
文|晓静
編集|徐青陽
アメリカ現地時間11月17日、OpenAIは正式にGPT-6.2 AstraとGPT-6.2 Solを発表しました。
この発表は外部の予想よりも遅れて行われました。10月末には、ユーザーがChatGPTの使用記録からGPT-6.2の灰色テストの痕跡を発見しており、その後、モデルの識別子やテストのスクリーンショットが次々と流出しました。以前のメディアは新モデルが最速で11月6日に発表されると予測していましたが、最終的な発表日はこの予想よりも11日遅れました。
OpenAIは今回、AIが専門的な仕事を引き受ける能力を強調しました。
PPTのスクリーンショットから完全なプレゼンテーションを再現することから、財務データの抽出、評価モデルの構築、Blenderを操作して自動車の3Dモデルを生成し、車両のサスペンションの物理運動をシミュレーションすること、さらにはCADを利用して機械部品を設計し、組み立て関係を検証することまで、GPT-6.2は過去に専門家が複雑なソフトウェアを使用して行っていた作業に深く入り込んでいます。
OpenAIは特に、新モデルが無駄な出力や繰り返しの修正を減らし、AIが提供する結果が専門的な仕事の基準により近づくことを強調しています。
過去2ヶ月以上にわたり、OpenAIはGPT-6 Astra、Sol、Luna、そしてGPT-6.1 Sol、Terraなどのモデルを次々と発表しました。最近発表されたGPT-6.2 Astraは、9月のGPT-6 Astraに続くフラッグシップモデルのアップグレードであり、複雑な専門タスクの処理能力を重点的に向上させています。GPT-6.2 Solは、主に日常業務、プログラミング、そして多段階のインテリジェントタスクの効率を強化しています。
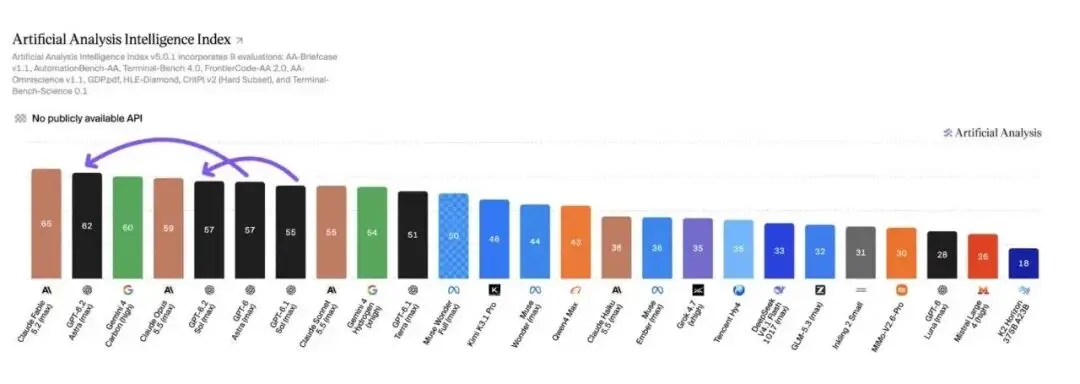
Artificial Analysisの最新ランキングによると、Astraは62点で世界第2位に上昇し、前の世代よりも5点向上しました。Solは57点に達しました。価格面では、AstraのAPIの入力、出力単価はそれぞれ20%引き下げられ、キャッシュ入力価格は60%減少しました。Solは元の価格を維持していますが、一部のタスクを完了するための総コストはさらに低下しました。
注目すべきは、GPT-6.2 AstraがOpenAI初のAI自主改善能力「High」能力の閾値に達した公開モデルであることです。
しかし、素晴らしいデモとスコアは異なる評価を引き起こしました。発表当日、数週間前から新モデルを試用していた開発者たちが失望を公に表明し、Astraが長時間のソフトウェア開発タスクで依然として早期に停止する可能性があること、あまりにも簡潔な出力が時には必要な情報を見逃すことがあると指摘しました。
同時に、ますます真実の専門的な仕事に近づく中で、モデルの能力の限界と安全管理も今回の発表の重要な注目点となりました。
OpenAIのCEOサム・アルトマン。画像はAI生成によるものです。
01 性能とコスト
GPT-6.2 AstraのAPI価格は、100万入力トークンあたり8ドル、出力トークンあたり40ドル、キャッシュ入力は0.40ドルです。前の世代と比較して、入力と出力の価格はそれぞれ20%減少し、キャッシュ入力は1ドルから0.40ドルに減少し、60%の減少となりました。GPT-6.2 Solは、100万入力トークンあたり2ドル、出力トークンあたり10ドルの価格を維持しています。
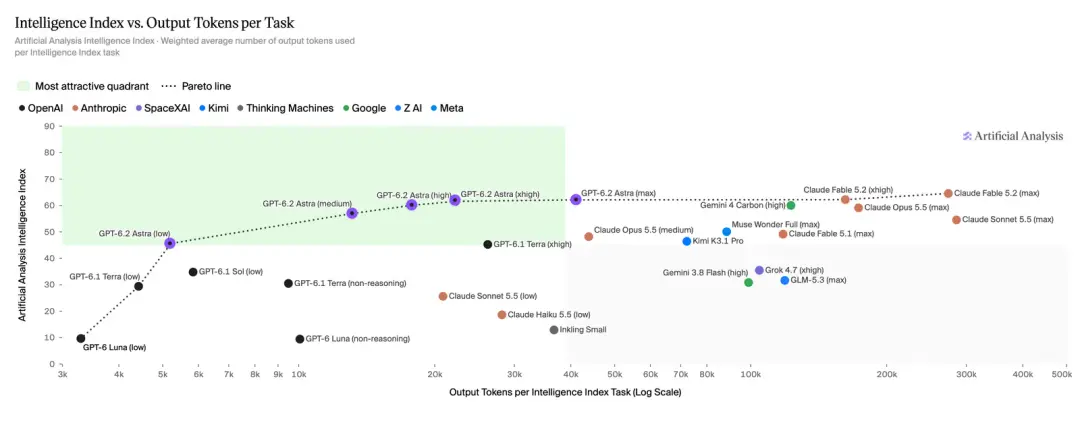
多段階のインテリジェントエージェントにとって、APIの単価は実際の支出を完全には反映しません。モデルがタスクを実行する際には、ツールを何度も呼び出したり、ファイルを読み取ったり、エラーを処理して再試行する必要がある場合があります。単価が変わらなくても、タスクを完了するために必要なトークンが少なければ、最終的な請求書も減少します。
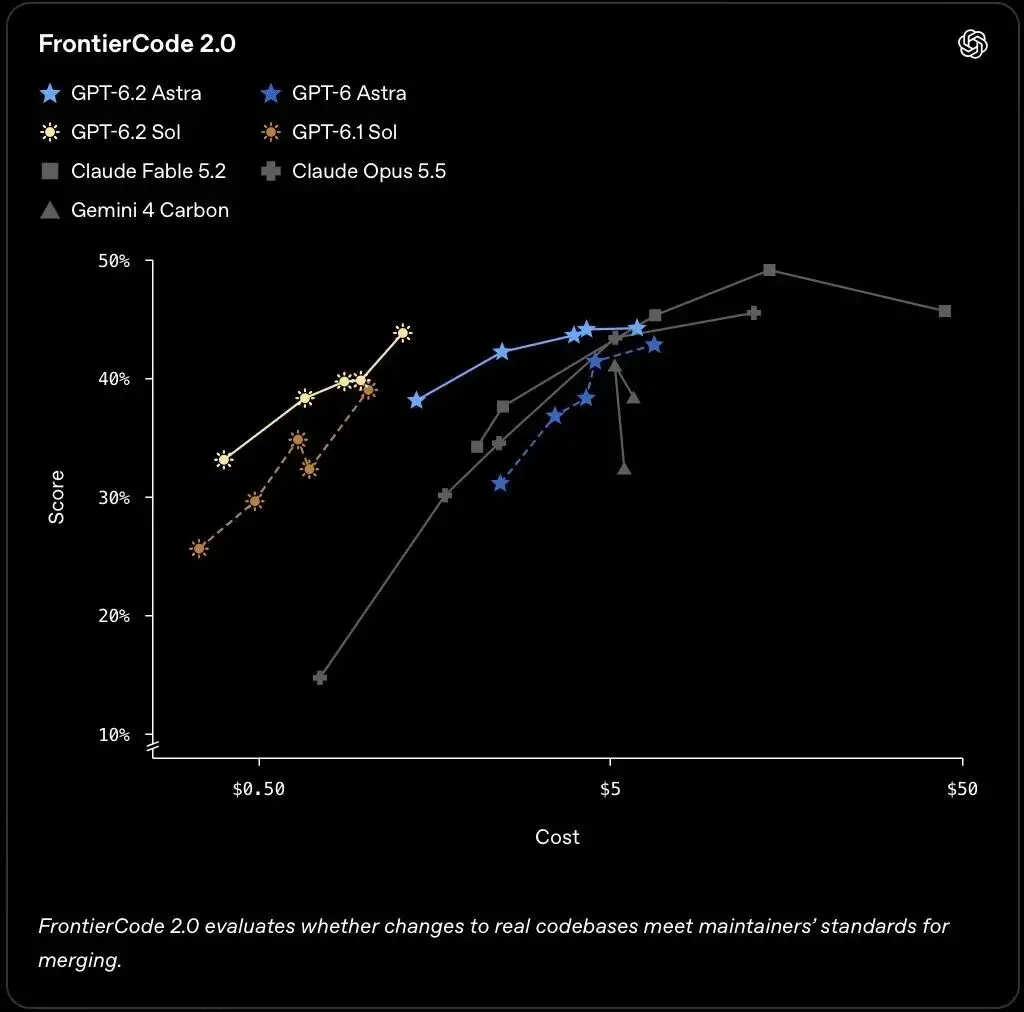
CognitionのFrontierCode 2.0プログラミングテストでは、GPT-6.2 SolのスコアはAstraよりも0.5点低いだけで、コストは後者の約5分の1でした。日常の複雑な業務を対象としたLifeVal評価では、Solのスコアは前の世代のフラッグシップGPT-6 Astraを上回り、単一タスクのコストは後者の約7分の1でした。
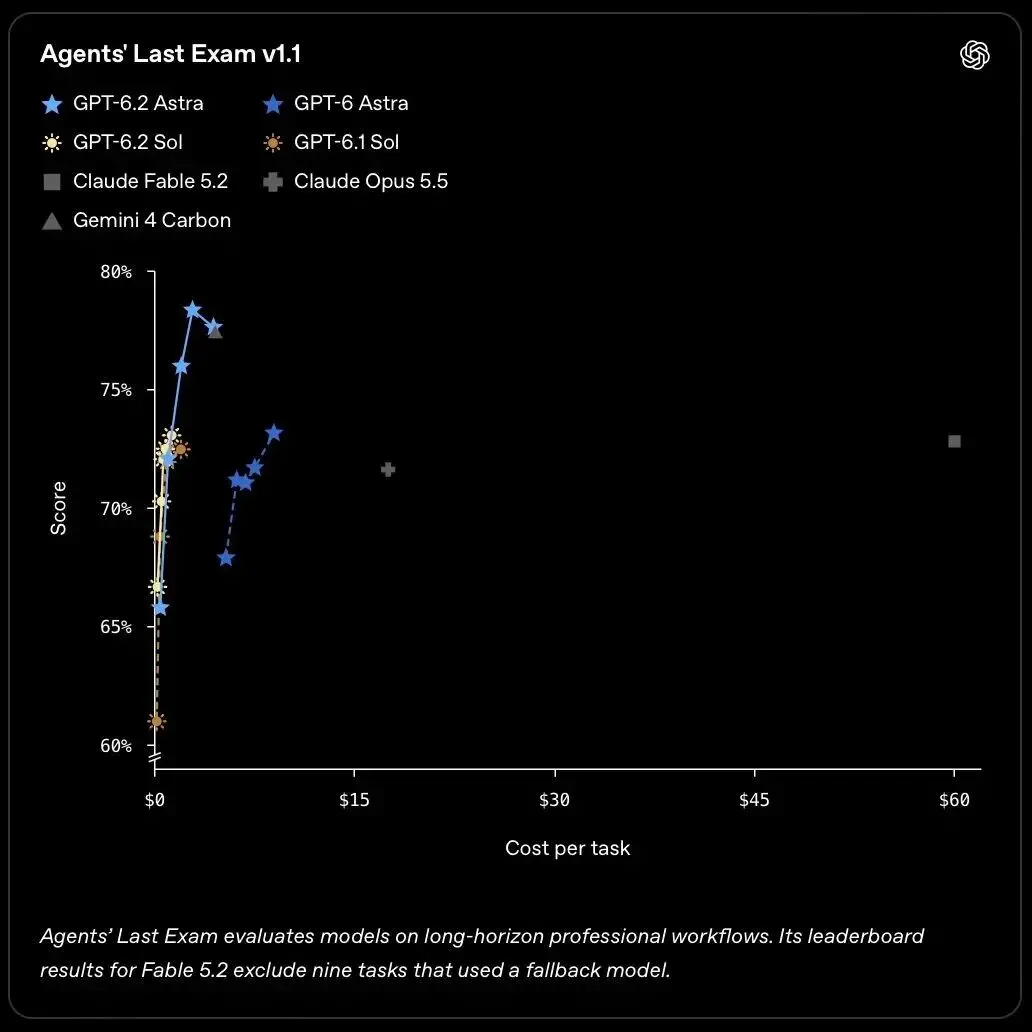
Astraは高難度のタスクにおいてもパフォーマンスが向上しました。Agents' Last Exam評価では、GPT-6 Astraよりも5.2点向上し、タスクを完了するコストは前の世代の3分の1未満でした。Claude Fable 5.2と比較して、Astraは5.5点高く、単一タスクのコストは後者の約5%でした。
02 専門的な仕事の提供
財務、法律、コンサルティングなどの専門的な仕事は、AIが大量の原資料を処理し、データを照合し、業界標準に従って納品可能な成果を形成することを求めます。OpenAIは、GPT-6.2 Astraがこのようなタスクにおいてパフォーマンスが向上し、財務モデリング、M&A分析、法律検索、データサイエンス分析などの作業を完了できることを示しています。
OpenAI内部のGDPval v2テストは、コンサルティング、金融、デザインなどの分野をカバーしており、Astraのスコアは前の世代よりも6.2ポイント向上し、出力トークンは22%減少しました。
法律検索に関しては、実際の法律事務所のタスクをシミュレーションしたHarvey LAB-AA v1.1テストで、Astraの合格率はClaude Fable 5.2の1倍を超え、単一タスクのコストは後者の約6分の1でした。
OpenAI内部のGDPval v2は、コンサルティング、金融、デザインなどの仕事をカバーしています。テスト結果は、Astraのスコアが前の世代よりも6.2ポイント向上し、出力トークンが22%減少したことを示しています。
03 3D世界への進出
GPT-6.2 Astraが今回展示したもう一つの能力は、3Dモデリングとエンジニアリングデザインに直接参加することです。モデルはもはやモデリングコードの一部を生成するだけでなく、専門ソフトウェアを操作し、部品を処理し、構造を調整し、計算結果を視覚化コンテンツとして作成することができます。
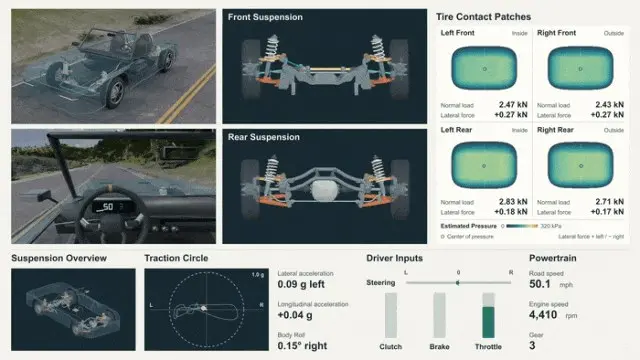
GPT-6.2 Astraによる山道運転とシャシー力学のシミュレーション
山道運転のシミュレーションケースでは、Astraはまずスポーツカーの3Dモデルを構築し、次にPython物理ソルバーを作成して、タイヤの接地力とサスペンションシステムの動的変化を計算し、最後に計算結果をBlenderにインポートして車両の走行アニメーションを生成しました。シミュレーションを通じて、エンジニアは実際の試作車を製造する前に、車両が複雑な路面を通過する際の荷重移動の状況を観察できます。
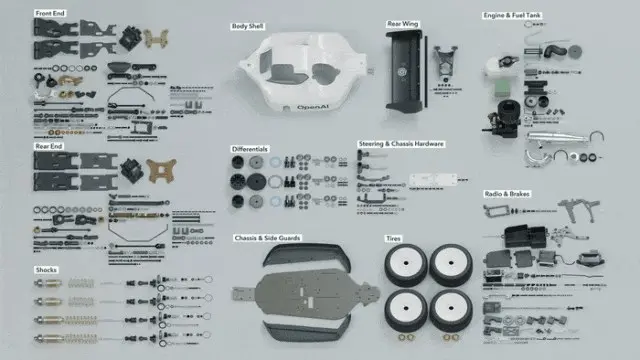
機械モデリングケースの入力資料ははるかにシンプルでした。OpenAIは1:8スケールのラジコンオフロードカーと直列6気筒エンジンの公開写真および組み立てマニュアルを提供しました。Astraはこれに基づいて各機械部品の3Dモデルを構築し、段階的な組み立てアニメーションと図解付きの部品カタログを生成しました。
さらに、CAD設計と実際の製作を結びつけるテストも行われました。OpenAIチームはシカゴのランドマーク建物Marina Cityの扇形バルコニーの写真を提供し、モデルがその構造を参考にして設計を行いました。何度も調整を重ねた結果、Astraは最終的に印刷可能で折りたたみ式の紙製テーブルランプを制作し、ユーザーがオンラインでパラメータを調整し、カスタム図面を生成できるLamp Builderというウェブページを作成しました。
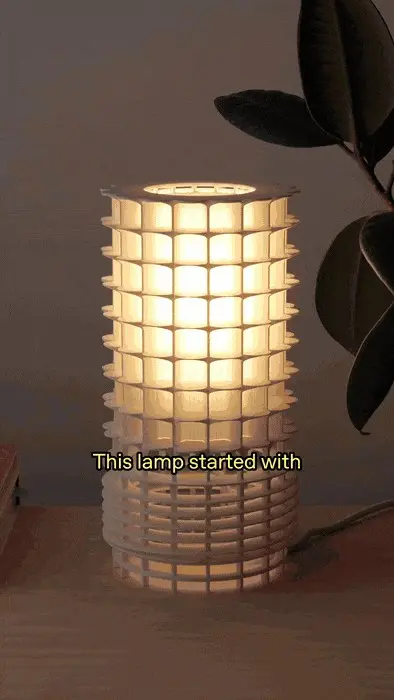
GPT-6.2 Astraによるラジコンオフロードカーとエンジンの機械モデリング
ウェブ開発では、Astraがキャンピングカーのインタラクティブなコンフィギュレーターを制作しました。ユーザーは車体の色を切り替えたり、ルーフテントを追加したりすると、ページの見積もりもリアルタイムで更新されます。また、テキストの説明に基づいて遊べるピンボール台、ローマのコロッセオの復元モデル、そして「Meridian Sound Racing」という未来都市のレーシングゲームを生成しました。
シカゴのMarina City建物から紙製テーブルランプまで
Artificial AnalysisのAA-3D人間評価盲テストもモデルの3D生成能力を比較しました。GPT-6.2 Astraは1318のEloスコアを獲得し、1位にランクインしました。Claude Fable 5.2は1271点、GPT-6.2 Solは1259点でした。
GPT-6.2 Astraが生成したキャンピングカーのインタラクティブなコンフィギュレーター
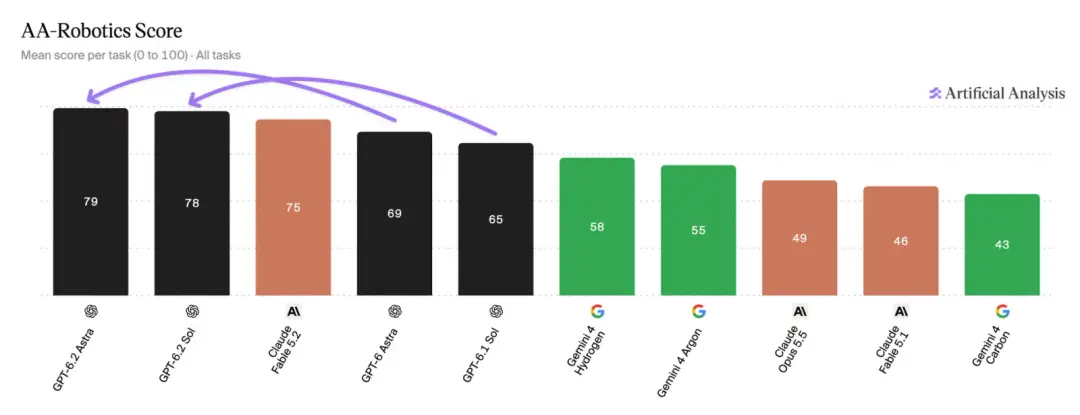
物理世界の理解と行動計画能力をテストするAA-Robotics v0.1プレビュー版では、AstraとSolはそれぞれ79点と78点を獲得し、Claude Fable 5.2の75点を上回りました。しかし、評価チームは、現在のトップモデルは初期テストの大多数の基本タスクを完了できるようになっており、より難易度の高い問題を追加していると述べています。
04 科学的推論と短所
科学研究もOpenAIが今回展示した重点項目です。
Terminal-Bench-Science 0.1テストでは、GPT-6.2 Astraは前の世代よりも9ポイント向上し、1位にランクインしました。このテストは、モデルが端末環境で科学研究のワークフローを完了する能力を主に評価します。モデルが実際の生物データを解釈し、実験を設計し、システムメカニズムを推論することを要求するVals Science Indexでも、Astraは新記録を樹立しました。
他のいくつかのテストの結果はClaude Fable 5.2に若干劣ります。物理推論ベンチマークCritPt v2の高難易度サブセット、事実知識評価AA-Omniscience v1.1、推論ベンチマークHLE-Diamondにおいて、Astraはすべて2位にランクインしました。
モデルに残っている問題の一つは、不確実な事実に直面した際に誤った答えを出す可能性があることです。
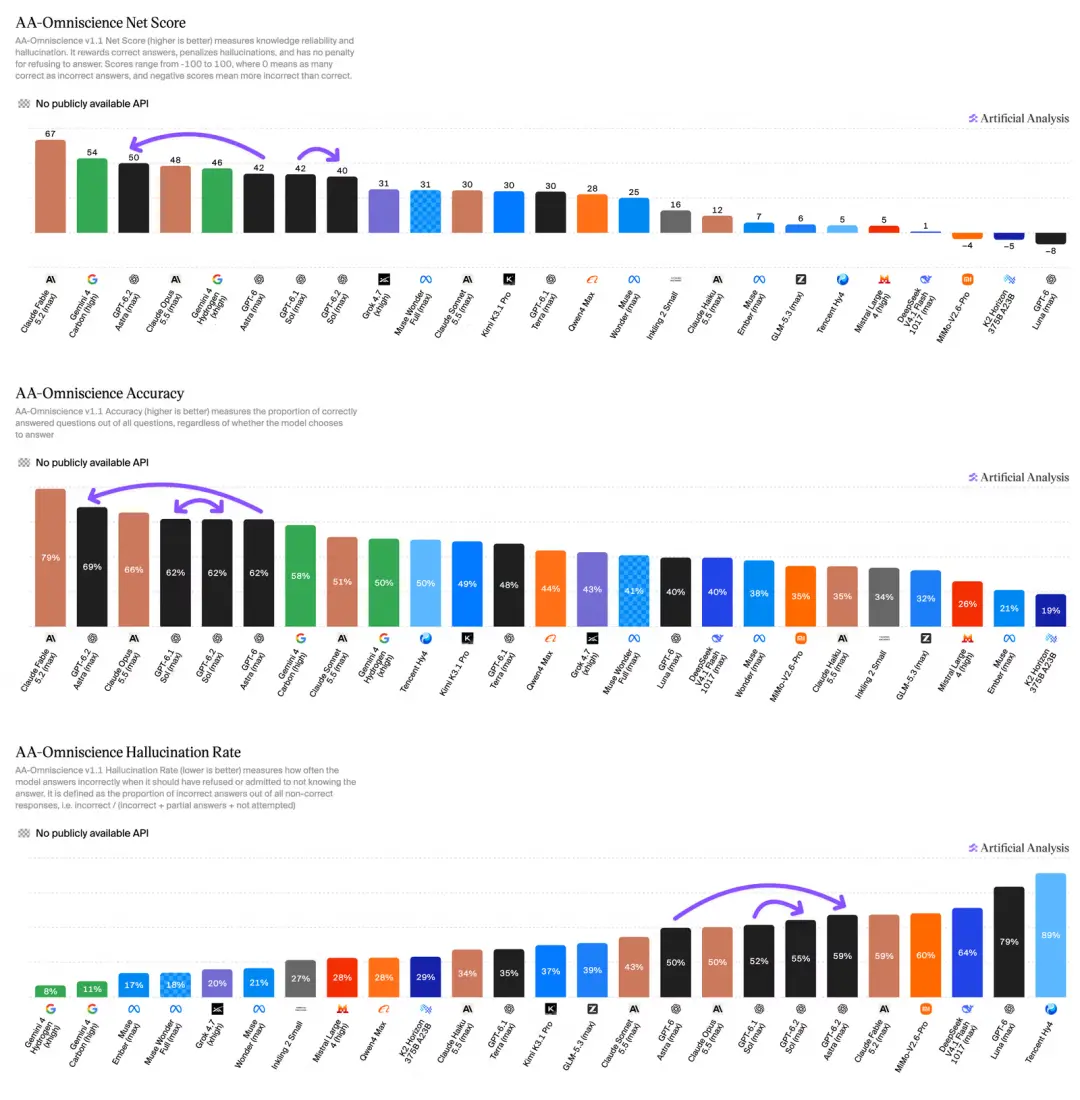
Artificial AnalysisのAA-Omniscience幻覚率テストでは、最高の推論強度の下で、GPT-6.2 AstraとSolの幻覚率はそれぞれ59%と55%であることが示されています。このテストは、モデルが自ら答えを把握していない可能性のある事実問題に直面した際に、依然として推測して回答する傾向があるかどうかを主に調査します。これはモデルの一般的な問答における誤り率を示すものではありませんが、財務監査や法律の引用などのシーンでは、依然として人間による確認が必要です。
プログラミングテストでも全体的な向上は見られませんでした。Artificial Analysisプログラミングインテリジェンス指数において、GPT-6.2 Astraのスコアは前世代と同じで、GPT-6.2 SolはGPT-6.1 Solよりも3点低下しました。
項目結果は、Solの失点が主にSWE-Atlas-QnA-AAから来ており、成績は14点低下しました。このテストは、モデルの複雑なコードベースに対する理解と問答能力を調査します。テスト結果は、Solがコードベースに関連する質問に回答する際、前世代よりも重要な事実を見落としやすいことを示しています。
これは、大規模な既存コードベースを扱う開発者にとって注意が必要な点です。モデルがコードを書くことができるからといって、プロジェクトの歴史、依存関係、具体的な制約を正確に把握しているとは限りません。
05 セキュリティ境界
モデルが端末を操作し、コードを審査し、専門ソフトウェアを呼び出すことができるようになると、ネットワークセキュリティリスクも増加します。
OpenAIは、GPT-6.2 AstraとSolがともに会社の「防范框架」(Preparedness Framework)で設定されたネットワークセキュリティの「重要閾値」(Critical threshold)に達したことを明らかにしました。これらのモデルは、ソフトウェアの脆弱性をより効率的に発見し、利用することができ、より安全な基盤コードを作成し、元のビジネスロジックをできるだけ保持した修正パッチを生成することができます。
これは、同じ能力が脆弱性の調査にも使用される可能性があることを意味します。OpenAIはそのため、公開バージョンに対して高リスクのネットワークセキュリティタスクに対する制限を強化しました。
脆弱性テストを行う必要があるセキュリティ研究者にとって、制限は一部の通常の作業にも影響を与えます。OpenAIは現在、Daybreakプロジェクトを通じて関連能力を段階的に開放しています:防御担当者はDaybreak Blueを通じて拒否率が低いGPT-6 Solを使用でき、高度な権限を持つレッドチームのテスト担当者は、Daybreak RedでGPT-6 Astraアルファ版およびGPT-6 Cyberを呼び出すことができます。OpenAIは、今後GPT-6.2シリーズもこの体系に導入する予定であると述べています。
さらに、OpenAIはトレーニング段階に防御指向のトレーニング信号を追加しました。以前、AIはPHP2Shellなどの高危険脆弱性を発見するために使用されていました。GPT-6.2シリーズは、開発の源からセキュリティ欠陥を識別する能力をさらに強化し、安全性と機能の完全性を兼ね備えた修正パッチを生成することを学びました。
 リスク警告
ChainCatcherは、広大な読者の皆様に対し、ブロックチェーンを理性的に見るよう呼びかけ、リスク意識を向上させ、各種仮想トークンの発行や投機に注意することを提唱します。当サイト内の全てのコンテンツは市場情報や関係者の見解であり、何らかの投資助言として扱われるものではありません。万が一不適切な内容が含まれていた場合はすることができます。私たちは迅速に対処いたします。