








GPT-6.2 phát hành: có thể sao chép PPT, xây dựng mô hình định giá, làm mô hình 3D, nhưng tỷ lệ ảo giác vẫn cao tới 59%
 Quan điểm cốt lõi

 OpenAI phát hành GPT-6.2 Astra và Sol: Astra trong Artificial Analysis đạt 62 điểm, đứng thứ hai toàn cầu, giá API đầu vào và đầu ra giảm 20%, có thể sao chép PPT, làm mô hình tài chính và mô hình 3D với Blender; nhưng tỷ lệ ảo giác của AA-Omniscience là 59%, chỉ số trí tuệ lập trình giữ nguyên so với thế hệ trước, an toàn đã chạm đến "ngưỡng quan trọng" của các cuộc tấn công mạng.
Tác giả|Tiểu Tĩnh
Biên tập|Từ Thanh Dương
Vào lúc 11 giờ ngày 17 tháng 11 theo giờ địa phương Mỹ, OpenAI chính thức ra mắt GPT-6.2 Astra và GPT-6.2 Sol.
Sự kiện ra mắt này đến muộn hơn so với dự đoán của giới bên ngoài. Từ cuối tháng 10, đã có người dùng phát hiện dấu vết thử nghiệm của GPT-6.2 từ các ghi chép sử dụng ChatGPT, sau đó các dấu hiệu mô hình và ảnh chụp thử nghiệm liên tục bị rò rỉ. Trước đó, các phương tiện truyền thông đã dự đoán mô hình mới sẽ được phát hành sớm nhất vào ngày 6 tháng 11, nhưng ngày phát hành cuối cùng đã muộn hơn 11 ngày so với dự đoán này.
OpenAI lần này nhấn mạnh khả năng của AI trong việc đảm nhận công việc chuyên môn.
Từ việc sao chép một bản trình bày hoàn chỉnh từ một ảnh chụp màn hình PPT, đến việc trích xuất dữ liệu tài chính, xây dựng mô hình định giá, cho đến việc điều khiển Blender để tạo ra mô hình 3D của ô tô, mô phỏng chuyển động vật lý của hệ thống treo, thậm chí sử dụng CAD để thiết kế các bộ phận cơ khí và xác minh mối quan hệ lắp ráp, GPT-6.2 bắt đầu đi sâu vào những công việc trước đây cần đến chuyên gia sử dụng phần mềm phức tạp.
OpenAI đặc biệt nhấn mạnh rằng mô hình mới có thể giảm thiểu đầu ra không hiệu quả và việc chỉnh sửa lặp đi lặp lại, giúp kết quả do AI cung cấp gần hơn với tiêu chuẩn công việc chuyên môn.
Trong hơn hai tháng qua, OpenAI đã lần lượt ra mắt các mô hình GPT-6 Astra, Sol và Luna, cũng như GPT-6.1 Sol, Terra, v.v. GPT-6.2 Astra vừa được phát hành là bản nâng cấp của mô hình flagship sau GPT-6 Astra vào tháng 9, tập trung nâng cao khả năng xử lý các nhiệm vụ chuyên môn phức tạp; GPT-6.2 Sol chủ yếu tăng cường hiệu quả cho công việc hàng ngày, lập trình và các nhiệm vụ tác nhân đa bước.
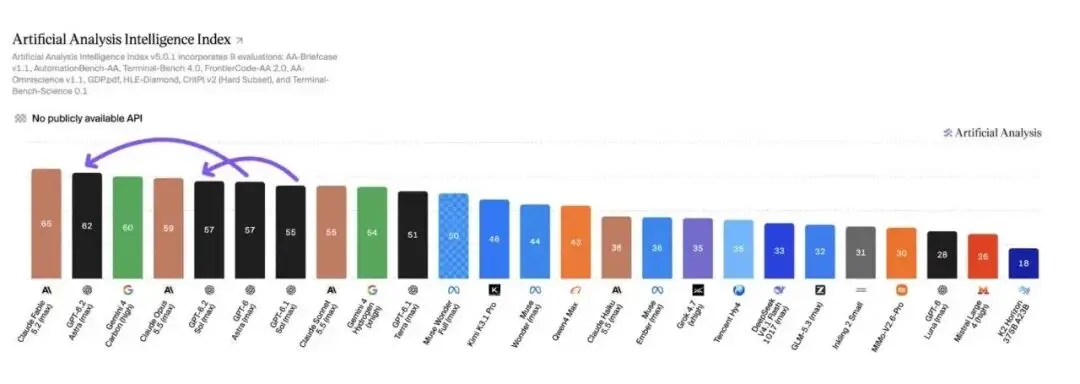
Theo bảng xếp hạng mới nhất của Artificial Analysis, Astra đã tăng lên vị trí thứ hai toàn cầu với 62 điểm, tăng 5 điểm so với thế hệ trước; Sol đạt 57 điểm. Về giá cả, giá API đầu vào và đầu ra của Astra đều giảm 20%, giá đầu vào bộ nhớ giảm 60%; Sol giữ nguyên giá, nhưng tổng chi phí hoàn thành một số nhiệm vụ đã giảm thêm.
Cần lưu ý rằng GPT-6.2 Astra cũng là mô hình công khai đầu tiên của OpenAI được đánh giá đạt ngưỡng khả năng tự cải tiến AI "Cao".
Tuy nhiên, những buổi trình diễn đẹp mắt và điểm số cũng đã thu hút những đánh giá khác nhau. Vào ngày phát hành, nhiều nhà phát triển đã thử nghiệm mô hình mới trước đó vài tuần công khai bày tỏ sự thất vọng, cho rằng Astra vẫn có thể dừng lại sớm trong các nhiệm vụ phát triển phần mềm kéo dài, và đầu ra quá ngắn gọn đôi khi còn bỏ sót thông tin cần thiết.
Đồng thời, khi ngày càng gần gũi với công việc chuyên môn thực tế, ranh giới và kiểm soát an toàn của mô hình cũng trở thành điểm nhấn quan trọng trong lần phát hành này.
Giám đốc điều hành OpenAI Sam Altman. Hình ảnh do AI tạo ra
01 Hiệu suất và chi phí
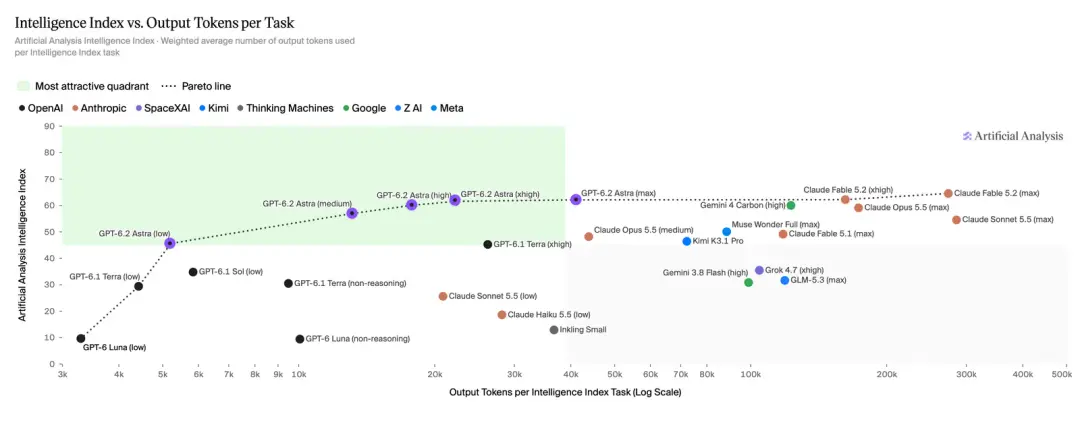
Giá API của GPT-6.2 Astra là 8 đô la cho mỗi triệu Token đầu vào, 40 đô la cho Token đầu ra, và 0,40 đô la cho đầu vào bộ nhớ. So với thế hệ trước, giá đầu vào và đầu ra đều giảm 20%, giá đầu vào bộ nhớ giảm từ 1 đô la xuống 0,40 đô la, giảm 60%. GPT-6.2 Sol giữ nguyên giá 2 đô la cho mỗi triệu Token đầu vào và 10 đô la cho Token đầu ra.
Đối với các tác nhân đa bước, giá API không thể phản ánh hoàn toàn chi phí thực tế. Khi mô hình thực hiện nhiệm vụ, có thể cần nhiều lần gọi công cụ, đọc tệp, xử lý lỗi và thử lại. Ngay cả khi giá không thay đổi, nếu số Token cần thiết để hoàn thành nhiệm vụ ít hơn, hóa đơn cuối cùng cũng sẽ giảm theo.
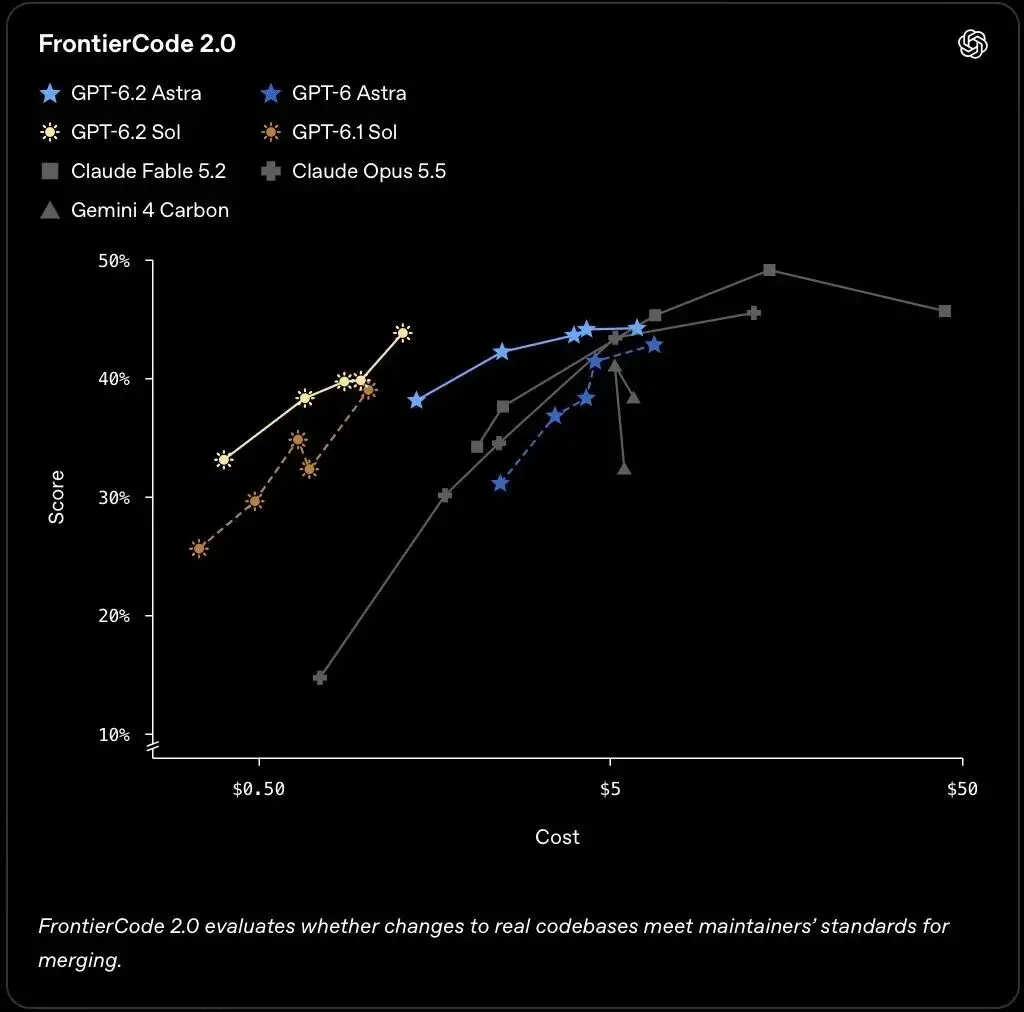
Trong bài kiểm tra lập trình FrontierCode 2.0 của Cognition, điểm số của GPT-6.2 Sol chỉ thấp hơn Astra 0,5 điểm, chi phí khoảng một phần năm của Astra. Trong đánh giá LifeVal hướng đến các giao dịch phức tạp hàng ngày, điểm số của Sol vượt qua mô hình flagship trước đó GPT-6 Astra, chi phí cho từng nhiệm vụ khoảng một phần bảy của Astra.
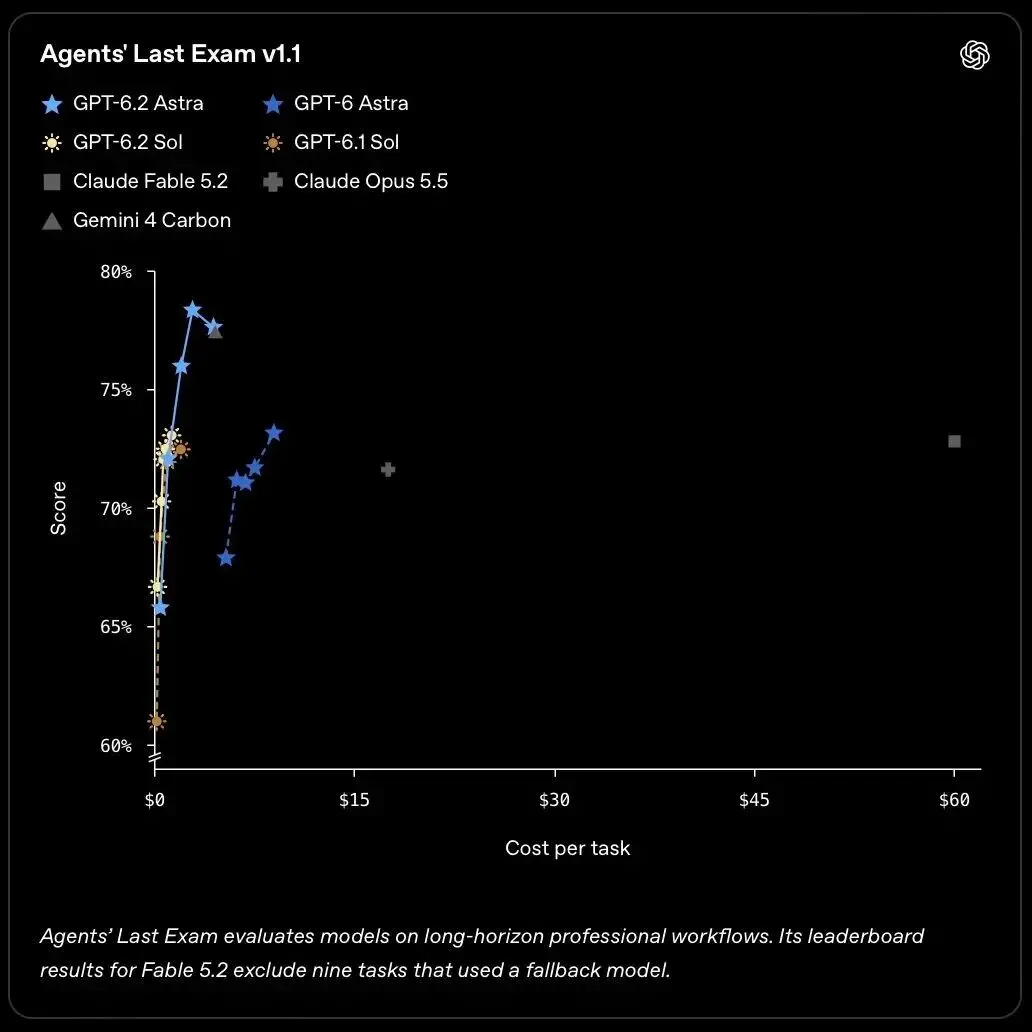
Astra cũng có sự cải thiện trong các nhiệm vụ khó khăn. Trong đánh giá Agents' Last Exam, nó đã tăng 5,2 điểm so với GPT-6 Astra, chi phí hoàn thành nhiệm vụ chưa đến một phần ba của thế hệ trước. So với Claude Fable 5.2, Astra cao hơn 5,5 điểm, chi phí cho từng nhiệm vụ khoảng 5% so với Claude.
02 Giao hàng công việc chuyên môn
Các công việc chuyên môn như tài chính, pháp lý và tư vấn yêu cầu AI xử lý một lượng lớn tài liệu gốc, kiểm tra dữ liệu và hình thành kết quả có thể giao được theo tiêu chuẩn ngành. OpenAI cho biết, GPT-6.2 Astra đã cải thiện hiệu suất trong các nhiệm vụ này, có khả năng hoàn thành các công việc như mô hình tài chính, phân tích sáp nhập, tìm kiếm pháp lý và phân tích khoa học dữ liệu.
Bài kiểm tra GDPval v2 nội bộ của OpenAI bao gồm các lĩnh vực tư vấn, tài chính và thiết kế, điểm số của Astra đã tăng 6,2 điểm so với thế hệ trước, và Token đầu ra giảm 22%.
Trong lĩnh vực tìm kiếm pháp lý, trong bài kiểm tra Harvey LAB-AA v1.1 mô phỏng nhiệm vụ thực tế của một văn phòng luật sư, tỷ lệ vượt qua của Astra vượt quá gấp đôi so với Claude Fable 5.2, chi phí cho từng nhiệm vụ khoảng một phần sáu so với Claude.
Bài kiểm tra GDPval v2 nội bộ của OpenAI cũng bao gồm các công việc tư vấn, tài chính và thiết kế. Kết quả kiểm tra cho thấy, điểm số của Astra đã tăng 6,2 điểm so với thế hệ trước, và Token đầu ra giảm 22%.
03 Tham gia vào thế giới 3D
Một khả năng khác mà GPT-6.2 Astra trình diễn lần này là tham gia trực tiếp vào mô hình 3D và thiết kế kỹ thuật. Mô hình không chỉ tạo ra một đoạn mã mô hình hóa, mà còn có thể điều khiển phần mềm chuyên nghiệp, xử lý các bộ phận, điều chỉnh cấu trúc và tạo ra nội dung trực quan từ kết quả tính toán.
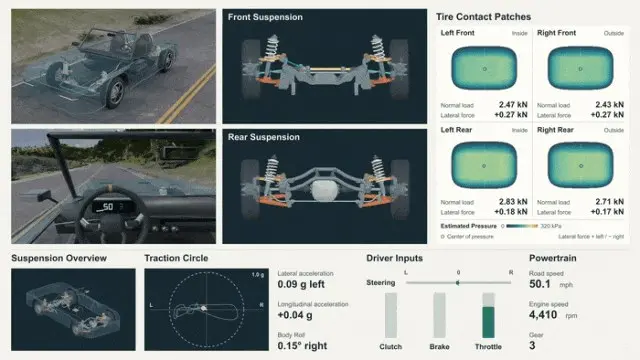
GPT-6.2 Astra mô phỏng lái xe trên đường đồi và mô phỏng động lực học khung gầm
Trong trường hợp mô phỏng lái xe trên đường đồi, Astra trước tiên xây dựng mô hình 3D của một chiếc xe thể thao, sau đó viết một bộ giải vật lý Python, tính toán lực tiếp xúc của lốp và sự thay đổi động học của hệ thống treo, cuối cùng nhập kết quả tính toán vào Blender để tạo ra hoạt ảnh di chuyển của xe. Thông qua mô phỏng, kỹ sư có thể quan sát tình trạng chuyển tải của xe khi đi qua các điều kiện đường phức tạp trước khi sản xuất mẫu xe thực tế.
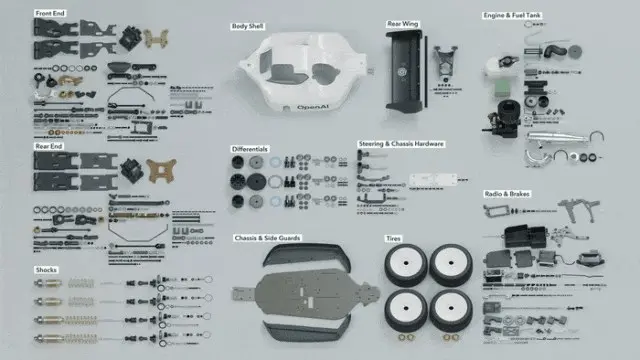
Dữ liệu đầu vào cho trường hợp mô hình cơ khí đơn giản hơn nhiều. OpenAI chỉ cung cấp ảnh công khai của một chiếc xe địa hình điều khiển từ xa tỷ lệ 1:8 và một động cơ sáu xi-lanh thẳng hàng cùng với hướng dẫn lắp ráp. Astra dựa vào đó để xây dựng mô hình 3D của các bộ phận cơ khí và tạo ra hoạt ảnh lắp ráp từng bước cùng với danh mục bộ phận có hình minh họa.
Một bài kiểm tra khác liên kết thiết kế CAD với sản xuất thực tế. Nhóm OpenAI đã cung cấp ảnh của ban công hình quạt của tòa nhà Marina City nổi tiếng ở Chicago, để mô hình tham khảo cấu trúc của nó trong thiết kế. Sau nhiều lần điều chỉnh, Astra cuối cùng đã tạo ra một chiếc đèn bàn bằng giấy có thể in và lắp ráp, và viết một trang web đi kèm có tên Lamp Builder, cho phép người dùng điều chỉnh tham số trực tuyến và tạo ra bản vẽ tùy chỉnh.
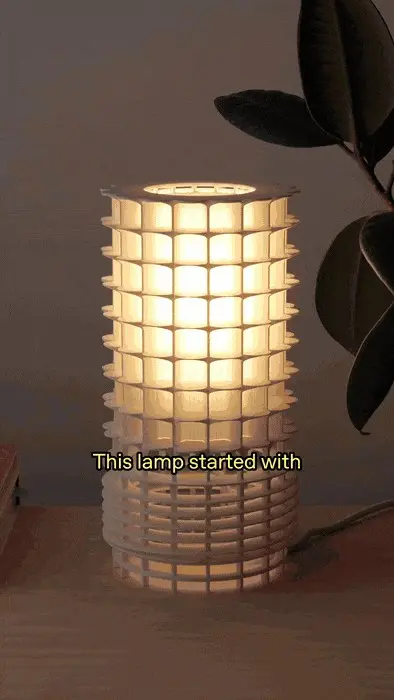
GPT-6.2 Astra hoàn thành mô hình cơ khí của xe địa hình điều khiển từ xa và động cơ
Trong phát triển web, Astra đã tạo ra một bộ cấu hình tương tác cho xe cắm trại. Người dùng có thể thay đổi màu sắc thân xe, lắp đặt mái che trên nóc xe, và báo giá trên trang cũng sẽ được cập nhật đồng bộ. Nó cũng đã tạo ra một bàn bóng có thể chơi, mô hình phục hồi đấu trường La Mã, và một trò chơi đua xe thành phố tương lai có tên là "Meridian Sound Racing" dựa trên mô tả bằng văn bản.
Từ tòa nhà Marina City ở Chicago đến đèn bàn bằng giấy
Bài kiểm tra AA-3D của Artificial Analysis cũng đã so sánh khả năng tạo 3D của mô hình. GPT-6.2 Astra đạt 1318 điểm Elo, đứng đầu bảng; Claude Fable 5.2 đạt 1271 điểm, GPT-6.2 Sol đạt 1259 điểm.
Bộ cấu hình tương tác cho xe cắm trại do GPT-6.2 Astra tạo ra
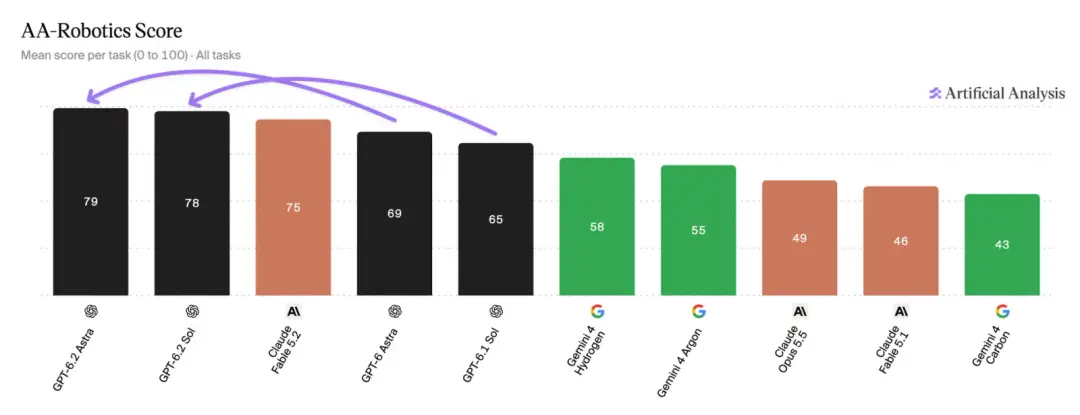
Trong phiên bản thử nghiệm AA-Robotics v0.1 đánh giá khả năng hiểu biết thế giới vật lý và lập kế hoạch hành động, Astra và Sol lần lượt đạt 79 điểm và 78 điểm, cao hơn 75 điểm của Claude Fable 5.2. Tuy nhiên, nhóm đánh giá cho biết, hiện tại các mô hình hàng đầu đã có thể hoàn thành hầu hết các nhiệm vụ cơ bản trong bài kiểm tra ban đầu, và đang tăng độ khó cho các câu hỏi cao hơn.
04 Lập luận khoa học và điểm yếu
Nghiên cứu khoa học cũng là một trong những điểm nhấn mà OpenAI trình diễn lần này.
Trong bài kiểm tra Terminal-Bench-Science 0.1, GPT-6.2 Astra đã tăng 9 điểm so với thế hệ trước, đứng đầu bảng. Bài kiểm tra này chủ yếu kiểm tra khả năng của mô hình trong việc hoàn thành quy trình công việc nghiên cứu khoa học trong môi trường đầu cuối. Trong chỉ thị yêu cầu mô hình giải thích dữ liệu sinh học thực tế, thiết kế thí nghiệm và suy luận cơ chế hệ thống trong chỉ số khoa học Vals, Astra cũng đã lập kỷ lục mới.
Các kết quả của một số bài kiểm tra khác thì kém hơn Claude Fable 5.2. Trong tập con khó của tiêu chuẩn suy luận vật lý CritPt v2, đánh giá kiến thức thực tế AA-Omniscience v1.1 và tiêu chuẩn suy luận HLE-Diamond, Astra đều xếp thứ hai.
Một vấn đề mà mô hình vẫn gặp phải là có thể đưa ra câu trả lời sai khi đối mặt với các sự kiện không chắc chắn.
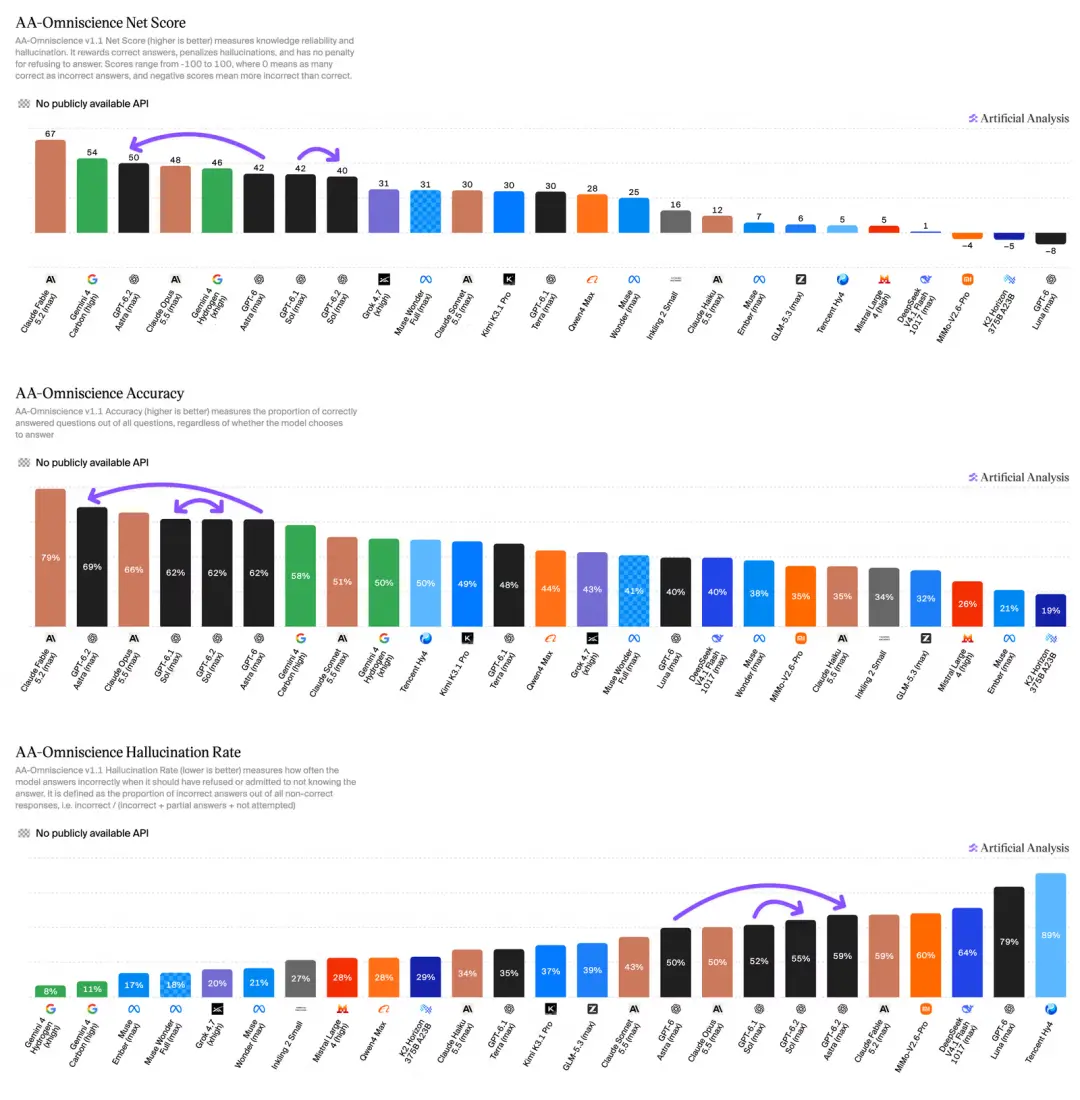
Bài kiểm tra tỷ lệ ảo giác của Artificial Analysis về AA-Omniscience cho thấy, ở cường độ suy luận cao nhất, tỷ lệ ảo giác của GPT-6.2 Astra và Sol lần lượt là 59% và 55%. Bài kiểm tra này chủ yếu xem xét xem mô hình có xu hướng đoán câu trả lời khi đối mặt với các vấn đề thực tế mà nó có thể không nắm rõ câu trả lời hay không. Nó không đại diện cho tỷ lệ sai sót của mô hình trong các câu hỏi chung, nhưng đối với các tình huống như kiểm toán tài chính, viện dẫn pháp lý, vẫn cần kiểm tra bằng tay.
Bài kiểm tra lập trình cũng không có sự cải thiện toàn diện. Trong chỉ số trí tuệ lập trình của Artificial Analysis, điểm số của GPT-6.2 Astra giữ nguyên so với thế hệ trước, trong khi GPT-6.2 Sol giảm 3 điểm so với GPT-6.1 Sol.
Kết quả chi tiết cho thấy, điểm mất của Sol chủ yếu đến từ SWE-Atlas-QnA-AA, với điểm giảm 14 điểm. Bài kiểm tra này xem xét khả năng hiểu và trả lời của mô hình đối với các kho mã phức tạp. Kết quả kiểm tra cho thấy, Sol dễ dàng bỏ lỡ các sự kiện quan trọng hơn so với thế hệ trước khi trả lời các câu hỏi liên quan đến kho mã.
Điều này là một điểm cần lưu ý đối với các nhà phát triển cần xử lý các kho mã lớn. Mô hình có thể viết mã không có nghĩa là nó đã nắm rõ lịch sử, mối quan hệ phụ thuộc và các ràng buộc cụ thể của dự án.
05 Ranh giới an toàn
Khi mô hình có khả năng thao tác terminal, kiểm tra mã và gọi phần mềm chuyên nghiệp, rủi ro an ninh mạng cũng tăng theo.
OpenAI tiết lộ, cả GPT-6.2 Astra và Sol đều đã đạt đến "ngưỡng quan trọng" (Critical threshold) về an ninh mạng theo khung phòng ngừa (Preparedness Framework) của công ty. Cả hai mô hình có thể phát hiện và khai thác lỗ hổng phần mềm hiệu quả hơn, cũng như viết mã nền tảng an toàn hơn, tạo ra các bản vá sửa lỗi giữ nguyên logic kinh doanh càng nhiều càng tốt.
Điều này có nghĩa là cùng một khả năng có thể được sử dụng cho việc kiểm tra lỗ hổng, nhưng cũng có thể bị sử dụng để tấn công. Do đó, OpenAI đã tăng cường các hạn chế đối với các nhiệm vụ an ninh mạng có rủi ro cao trong phiên bản công khai.
Đối với các nhà nghiên cứu an ninh cần thực hiện kiểm tra lỗ hổng, các hạn chế cũng sẽ ảnh hưởng đến một số công việc bình thường. Hiện tại, OpenAI đang mở cấp độ khả năng liên quan thông qua dự án Daybreak: các nhân viên phòng thủ có thể sử dụng GPT-6 Sol với tỷ lệ từ chối thấp hơn thông qua Daybreak Blue; các nhân viên kiểm tra đội đỏ có quyền truy cập cao cấp có thể gọi phiên bản alpha của GPT-6 Astra và GPT-6 Cyber trong Daybreak Red. OpenAI cho biết, trong tương lai cũng sẽ đưa dòng GPT-6.2 vào hệ thống này.
Ngoài ra, OpenAI cũng đã thêm tín hiệu đào tạo hướng phòng thủ trong giai đoạn đào tạo. Trước đó, AI đã được sử dụng để phát hiện các lỗ hổng nguy hiểm như PHP2Shell. Dòng GPT-6.2 đã tăng cường khả năng nhận diện các khuyết điểm an ninh từ nguồn phát triển và học cách tạo ra các bản vá sửa lỗi vừa đảm bảo an toàn vừa giữ nguyên tính toàn vẹn chức năng.
 Cảnh báo rủi ro
链捕手ChainCatcher nhắc nhở: hãy nhìn nhận blockchain một cách tỉnh táo, nâng cao ý thức rủi ro, cảnh giác với việc phát hành và đầu cơ các token ảo. Mọi nội dung trên trang chỉ là thông tin thị trường hoặc quan điểm của các bên liên quan, không cấu thành bất kỳ hình thức tư vấn đầu tư nào. Nếu phát hiện nội dung nhạy cảm, hãy nhấp , chúng tôi sẽ xử lý kịp thời.

Bài viết nổi bật





