英伟达和微软已经动手了:4天238颗星的DeepSeek-Bot,烧出30倍的Token账单

 算力消耗的结构可能正从GPU单极走向CPU、内存、GPU协同,硬件端的需求增量相对更可核对,软件端的冲击则取决于代理替代的节奏;两条线索由同一个产品周期驱动。这一转移已经在多大程度上被市场计入,仍有待观察。
导语: 10月7日上线的DeepSeek-Bot,只是一个让多个AI Bot在群聊里协作的小插件,四天238颗星,本身撑不起一篇深度。值得写它的是另一件事:它踩中了一条正在改写AI硬件定价的趋势,多智能体协作让Token消耗出现数量级跳变,而跳变的账单最终落在CPU和内存上。本文从这个小插件出发,把Token倍数、CPU缺口、内存置换和两家巨头的动作串成一条线。
一、30倍不是线性翻倍,是成本从可预算变成不可预算
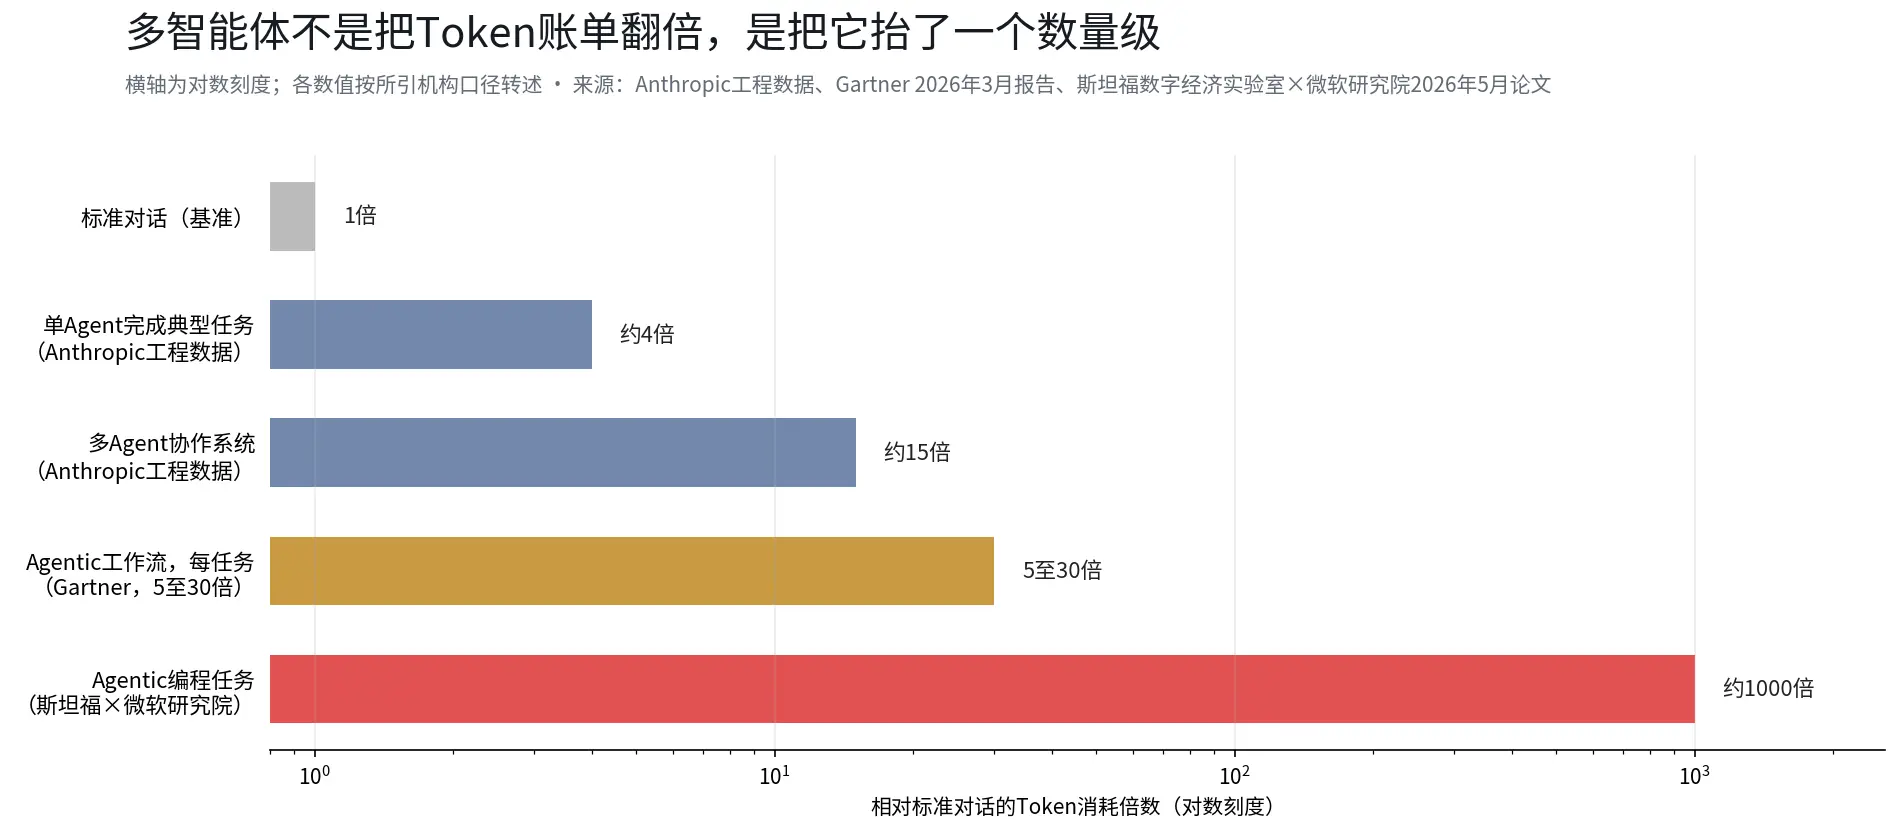 先看量级。据Anthropic的工程数据转述,单Agent完成一次典型任务的Token消耗约为普通对话的4倍,多Agent协作系统达到15倍。学术界给出的数字更极端:据上述联合论文,Agentic编程任务中Agent执行的Token消耗约为标准对话的1000倍,操作外部系统的简单工具也在5到30倍之间。
同一篇论文里还有一个更容易被忽略的发现:运行同一个Agent、执行同一个任务,Token账单的波动幅度可达30倍。也就是说,同一个用户点击同一个按钮,背后的模型调用次数可能相差30倍,每次调用都要重新发送累积的对话历史。Gartner在2026年3月的报告中给出折中估算:Agentic工作流每任务消耗的Token是标准聊天机器人的5到30倍,因为一次用户请求可能触发10到20次顺序模型调用。
高盛研究部5月的预测更激进:到2030年Token消耗量将增长24倍,月用量级折算约12亿亿枚。Token单价的下降没有扭转这个趋势,据Gartner预计,2030年推理成本将比2025年下降超过90%,但用量增速远超价格降幅。单次调用越来越便宜,调用次数越来越多、每次越来越大,总支出因用量爆炸而增加。
综合调用数据与硬件读数,Token经济的主要矛盾已经从单价转移到调用次数与单次消耗的乘积。 这一点对硬件的含义是:GPU利用率的瓶颈不再是单次前向计算的速度,而在内存带宽和调度;这正是CPU和内存重新进入定价视野的原因。
二、CPU从配角回到主角
 多智能体系统里,任务调度、工具调用、逻辑判断、上下文管理,都是CPU擅长的事。据上海证券报研报,智能体负载中仅编排环节的耗时就可占总延迟的50%到90%;CPU性能不足时,再强的GPU也会因等待调度而闲置。
需求已经在价格和交期上显形。据公开报道,英特尔确认上调部分服务器CPU售价,高端Xeon整体涨7%至12%,消费级CPU年内经历三轮调价、Plus系列累计涨幅接近30%;AMD下半年对中高端服务器CPU预计再提价4%至7%;服务器CPU交货周期从通常的1至2周延长到8至12周,个别情况长达6个月。
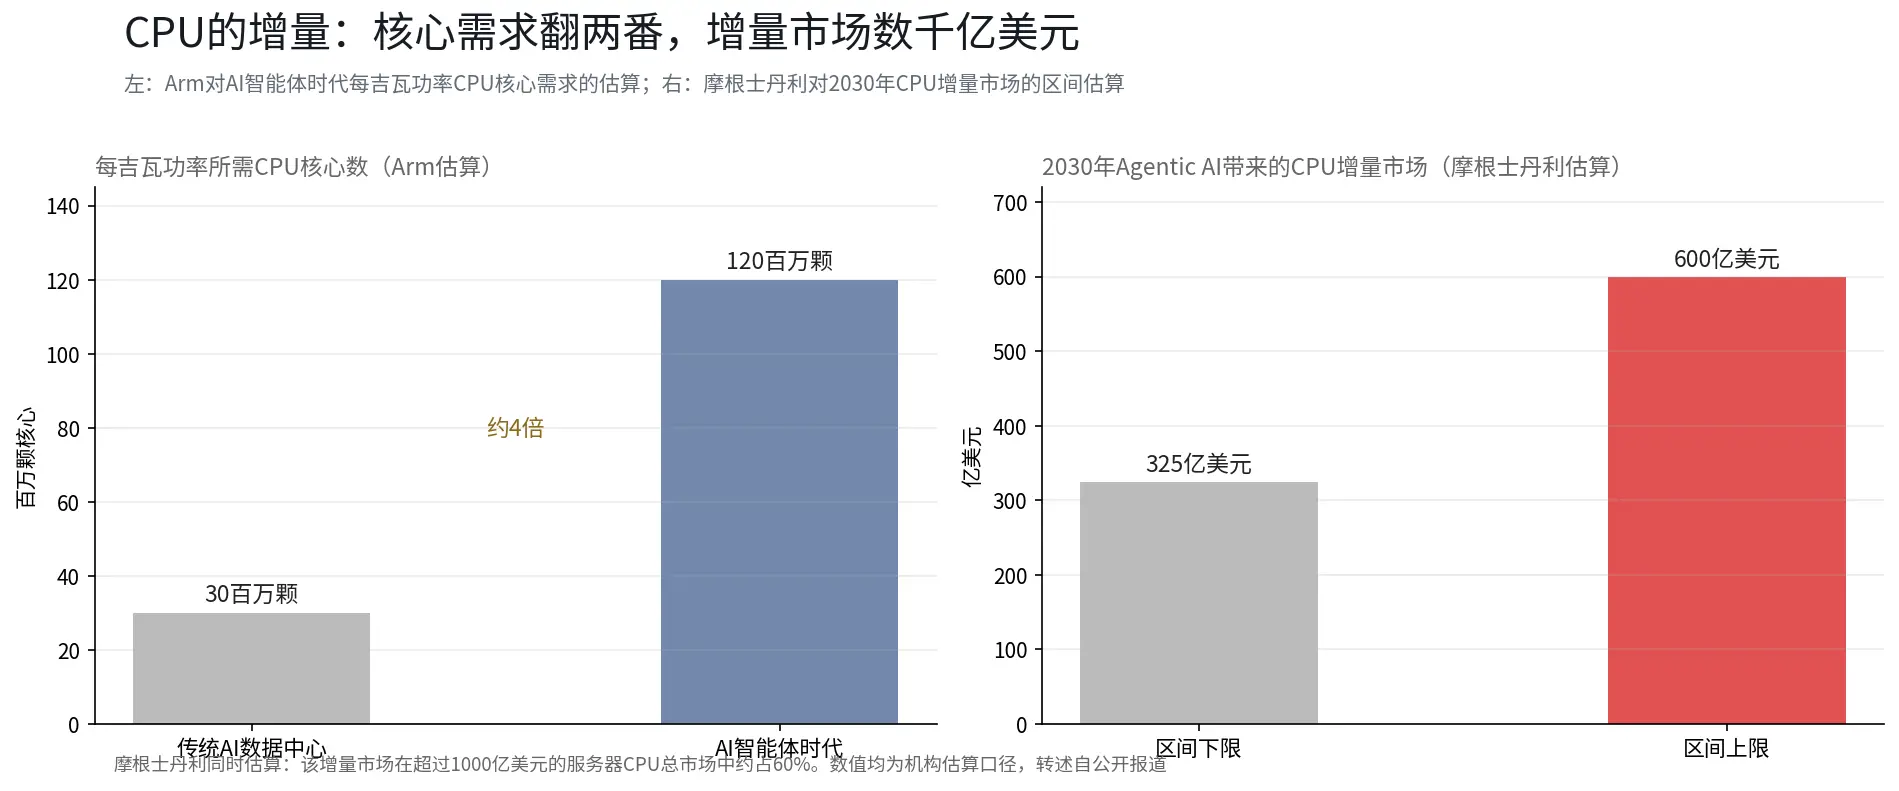
量级估算有两家。据Arm的测算,传统AI数据中心每吉瓦功率约需3000万颗CPU核心,智能体时代将升至1.2亿颗,增长3倍;据摩根士丹利的框架,到2030年Agentic AI带来325亿至600亿美元的CPU增量市场,在超过1000亿美元的服务器CPU总市场中约占60%。AMD在一季度财报电话会上给出的方向一致:AI基础设施中CPU与GPU的配比正从1:4至1:8向1:1靠拢,智能体密集部署场景下CPU配置数量可能反超GPU。
进一步看:CPU这条线的弹性来自配比变化,而不是总量增长。 服务器CPU市场本身增速平稳,变化在于每一块GPU旁边站着的CPU数量。配比从1:8走到1:1,意味着同样的GPU开支对应数倍的CPU开支,这是CPU第一次在AI硬件叙事里拥有独立的增量逻辑。这个判断的前提是智能体负载确实按当前路径放量,若编排环节被软件优化明显压缩,配比曲线会放缓。
三、内存:紧缺的根源在产能置换,不在需求波动
多智能体系统依赖长期记忆,记住偏好、历史和任务进度,并在不同时点调用。技术上,每一次内部推理都要从GPU内存读取整个不断增长的KV缓存,推理是内存带宽密集型的工作。用散户熟悉的话说:GPU算得快不快,越来越取决于内存喂得快不快。
美光的高管在公开场合把这件事说得很直白。执行副总裁Sumit Sadana在KeyBanc科技论坛表示,Agentic AI工作负载的Token消耗可能达到同类聊天任务的5到30倍,深度推理更高;CEO桑杰·梅赫罗特拉在接受CNBC采访时说,训练时代已经过去,推理时代刚开始,而智能体AI甚至还没有真正大规模落地。
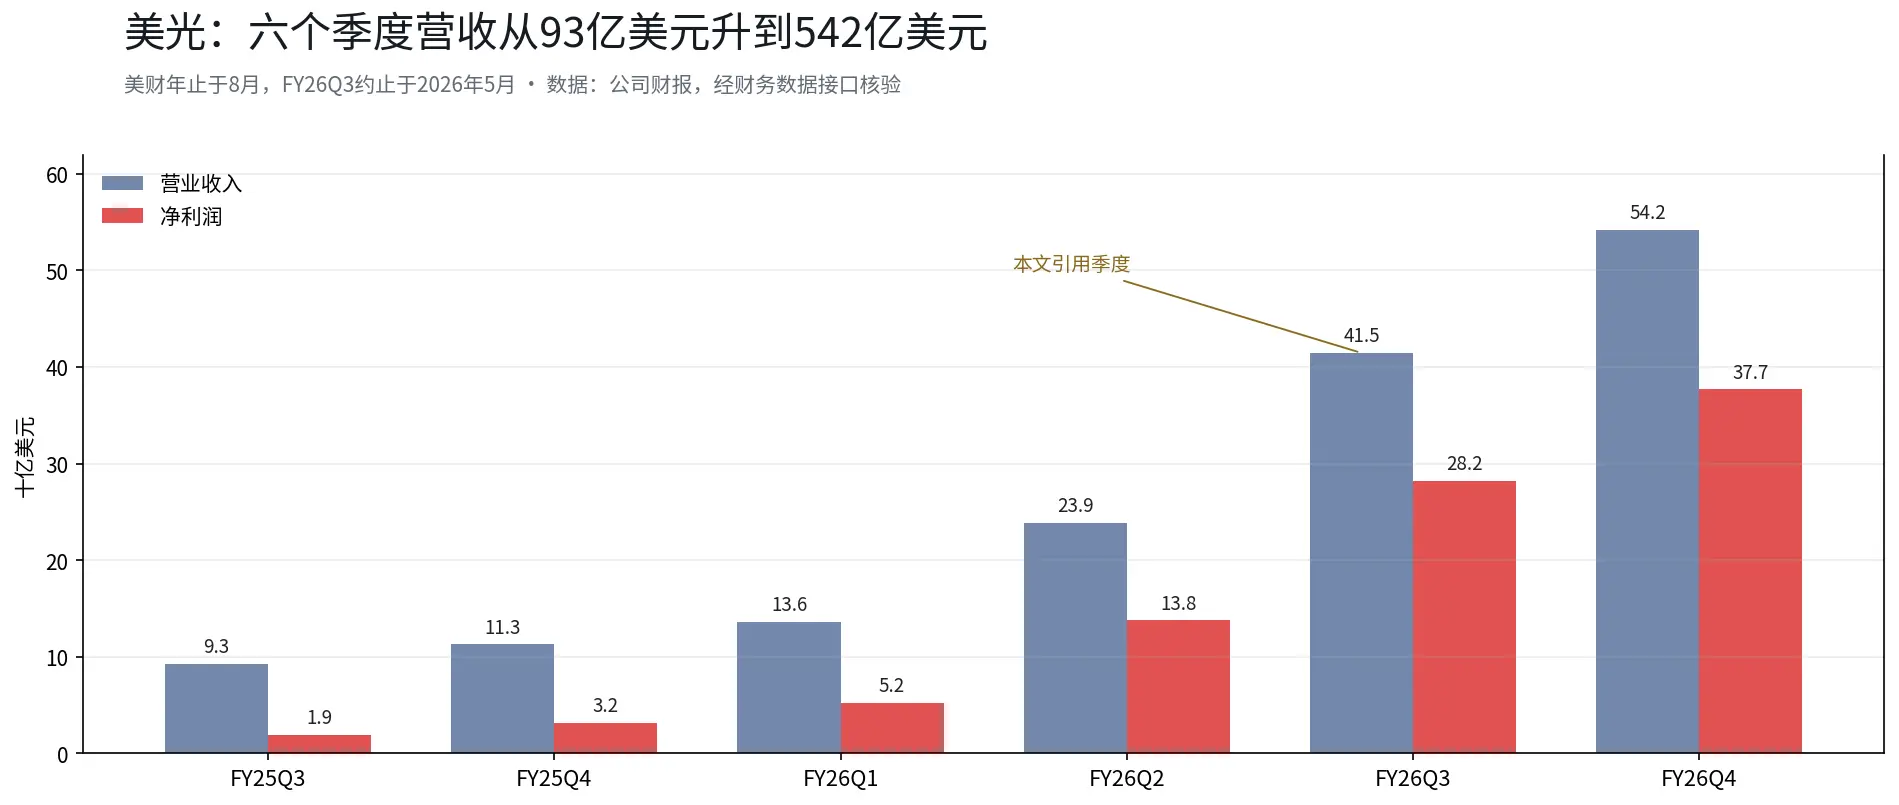
美光的报表在验证这个趋势。FY26Q3营收414.56亿美元,同比增长345.7%,数据中心业务营收115.2亿美元、上年同期仅15.3亿美元;FY26Q4营收进一步升至542.29亿美元(公司财报,经财务数据接口核验)。Sadana在论坛上补充了两条:2027年的供需比2026年更紧,DRAM客户"即使出高价也拿不到想要的一半以上";产品端,HBM4 36GB 12-high在测试条件下可将LLM推理吞吐提升2.6倍。
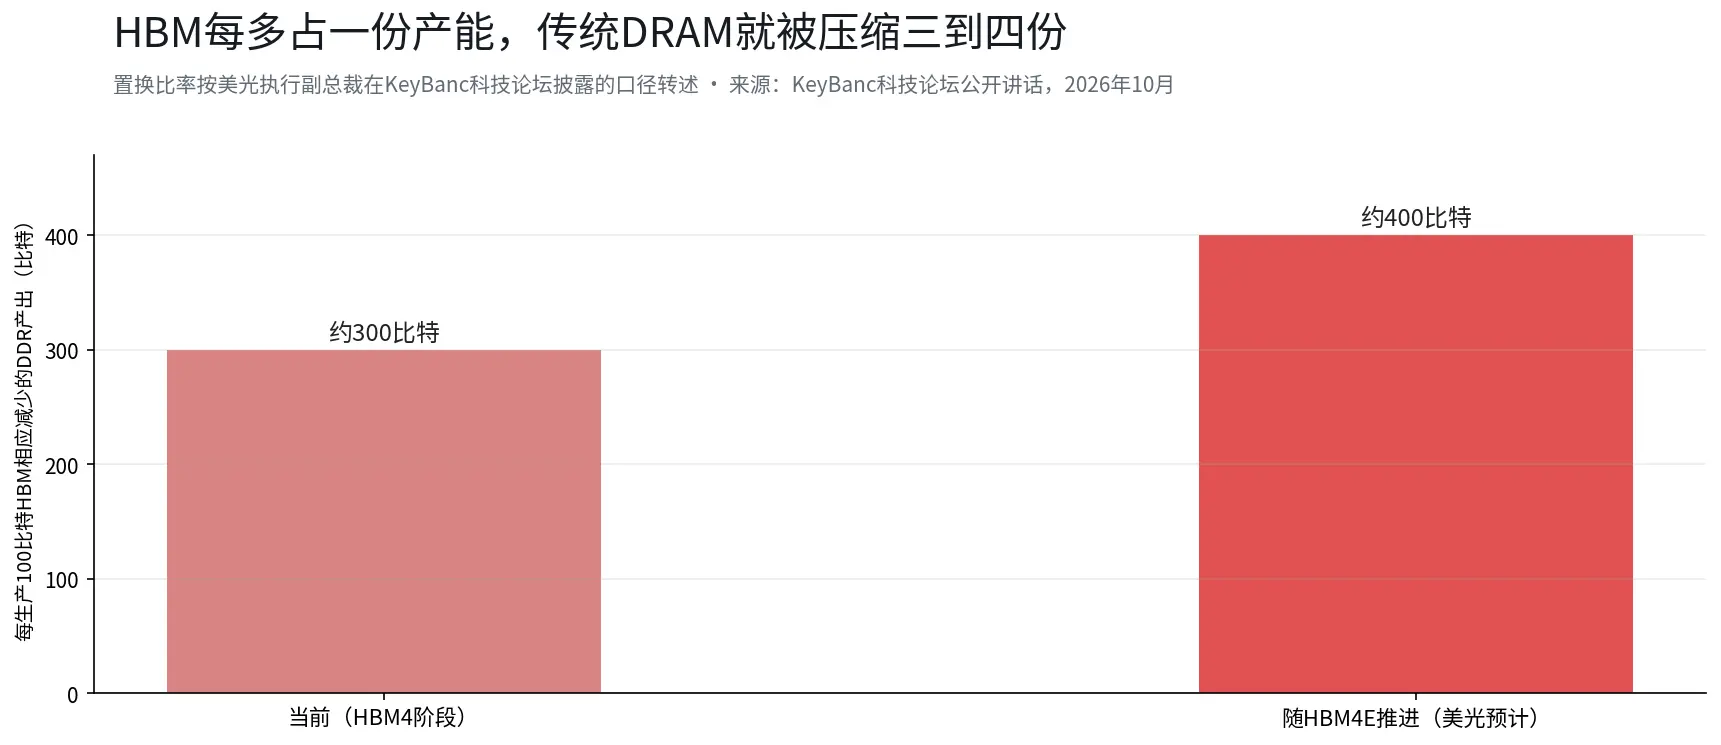
 更关键的细节是置换比率:每生产100比特HBM,约减少300比特DDR产出,随HBM4E推进可能接近4:1。 这意味着内存紧缺的结构性根源不在需求端,在产能的物理置换,HBM每扩产一份,传统DRAM供应就被压缩三到四份。只要HBM还在为AI扩产,DDR的紧缺就难以靠需求降温化解,这条供需逻辑的验证点在美光等厂商后续公布的产能与价格指引。
四、软件的恐慌和硬件的增量,来自同一次产品发布
2026年1月中旬,Anthropic发布Claude Cowork,1月30日上线面向法务、财务、销售等职能的行业插件,随后Claude Opus 4.6把大任务拆成子任务、交给不同代理并行完成。市场的反应分成了两半。软件端,据公开报道及Wedbush研报,那轮抛售抹去的软件股市值在8000亿美元到1万亿美元之间(不同统计涵盖的股票范围不同),FactSet单日跌10%,Wedbush称之为"Software-mageddon"。担忧的核心是:代理能自主完成合同审查、财务分析之后,按人头收费的SaaS模式会被侵蚀。
硬件端在同一时间给出相反的读数。摩根士丹利指出,随着AI从生成式转向智能体,投资范围将从GPU扩展至CPU和内存;半导体在标普500中的权重已突破20%。同一枚硬币的两面是:代理的替代能力越强,底层算力、CPU和内存的消耗越大。 软件的份额焦虑和硬件的需求增量,由同一个产品周期驱动,把它们当成两个故事分开定价,可能是当前AI板块最大的定价分歧之一。
五、微软和英伟达在做什么
当地时间10月7日,微软在旧金山发布与英伟达合作的Surface Laptop Ultra:NVIDIA RTX Spark平台,Blackwell RTX GPU至多6144个核心,配Grace CPU至多20核,统一内存至多128GB,可在本地运行超过1200亿参数的模型,售价2599美元起,10月16日发货。黄仁勋到场,他的原话被广泛引用:"四十年来,你启动应用,点击、打字;现在你发问,电脑替你干活。"
比硬件更重要的是操作系统的改法。据微软官方博客,Windows围绕"混合智能"重新设计:获得授权后,Copilot可读取本地文件、代为整理、排查故障、执行工作流;安全层面通过系统级容器限制智能体可访问的文件与网络范围;按任务在本地模型与云端模型之间调度。英伟达则在9月28日发布了Open Agent Safety Platform,覆盖代理从测试到部署的安全层;黄仁勋同时披露,Blackwell和Vera Rubin系统的订单金额已达1万亿美元、覆盖至2027年(公司口径)。
两个动作的逻辑是连贯的:微软在操作系统层为代理时代重建入口,英伟达在芯片和平台层为代理的规模化部署备货。 与其说它们在预期多智能体协作到来,不如说它们已经在为它建设底座。把部分推理放进本地设备,本质上是承认代理的算力消耗太大,必须分层处理,每一台跑着代理的PC,都是一个新的常驻算力节点。
六、Token账单:从按人头收费到按消耗收费
Gartner 2026年的企业调研给出一个值得认真对待的读数:近四分之一的技术领导者已经在为每位开发者每月支付200至500美元的AI编码Token,约6%超过2000美元;该机构预测,AI编码Token成本将在2028年超过开发者平均工资。这预示着计费方式的切换:聊天机器人时代按座位数做预算,代理时代只能按执行次数做预算,而执行次数连模型自己都估不准,上述联合论文明确指出,模型会持续低估自己将要花费的Token数量。
回到开头那个238颗星的小插件。Main Bot默认独占回复、按需调用其他Bot,开发者做的其实就是最朴素的Token预算管理。这个微观动作放到企业级部署,含义会放大:对CPU、内存和网络的刚性需求只会更强。
写在最后
DeepSeek-Bot的238颗星不重要,重要的是它演示的成本结构:多智能体每协作一步,Token账单就跳一档,跳变的幅度连模型自己都无法预告。这个结构顺着产业链往下游压,先压出CPU的配比变化和交期,再压出内存的产能置换,最后压出操作系统级的重构。从这条链条看,算力消耗的结构可能正从GPU单极走向CPU、内存、GPU协同,硬件端的需求增量相对更可核对,软件端的冲击则取决于代理替代的节奏;两条线索由同一个产品周期驱动。这一转移已经在多大程度上被市场计入,仍有待观察。
免责声明:本文内容仅供一般信息及市场评论之用,基于截至文中所述时间的公开资料整理,相关市场数据、预期及概率可能随市场情况变化而发生变动。文中引用的第三方机构、分析师或其他人士的观点及投资策略仅代表相关第三方在特定时间的观点,不代表 BIT 的观点或推荐。本文不构成投资建议、投资研究、要约、招揽或对任何证券、投资产品或交易策略的推荐,亦不应作为任何投资决策的依据。金融市场存在风险,证券价格及市场表现可能波动,历史表现及过往市场走势并不代表或保证未来结果。投资者应根据自身情况独立评估相关风险,并在需要时寻求专业意见。BIT 的港股交易服务不向香港居民或其他受限司法管辖区的用户提供。
 风险提示