OpenAI самораскрытие рекурсивного самоулучшения: интеллектуальные агенты экспоненциального взрыва, человечество стало узким местом
 Ключевые тезисы

 Человечество предоставляет первоначальную способность суждения и базовый уровень допуска к ошибкам, в то время как AI отвечает за увеличение этого уровня в десять тысяч раз.
Автор:ASI Откровение,Синьчжиюань
OpenAI без предупреждения объявила: «Рекурсивное самоулучшение» (RSI, Recursive Self-Improvement) официально начало действовать.
Проще говоря, OpenAI сама подтвердила: ИИ начал разрабатывать ИИ!
Долгое время люди гадали, в какой день появится суперискусственный интеллект (ASI). Все следили за оценками больших моделей, за ростом количества параметров.
Но OpenAI ясно говорит вам: настоящий поворотный момент на пути к ASI — это не превышение оценок моделей над человеческими, а формирование замкнутого цикла «ИИ разрабатывает ИИ».
Праздник вычислительной мощности, каждый день сжигая 23 тысячи долларов «суперработника»
Внутри OpenAI исследователи используют ИИ-агентов с такой частотой, что это уже вышло из-под контроля — конечно, в положительном смысле.
Согласно ценам API, в сентябре этого года средний исследователь тратил на агентов по 1500 долларов в день.
Всего через месяц, в октябре, эта цифра взлетела до 2400 долларов, увеличившись на 62%.
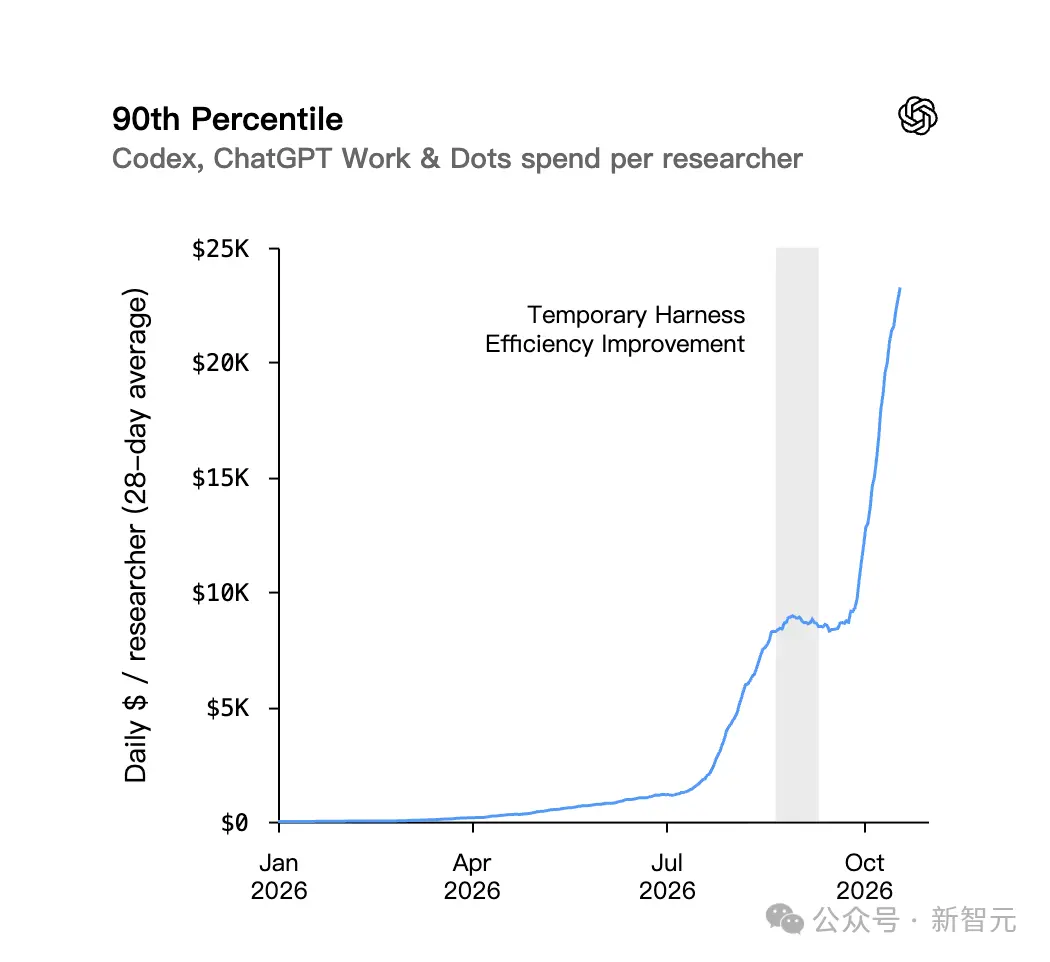
Но это лишь средний уровень. А как насчет тех, кто в верхних 10% «тяжелых пользователей»? Они сжигают на агентов по 23000 долларов в день, что на 105% больше по сравнению с предыдущим месяцем.
Более 20 тысяч долларов в день. Если у вас есть представление о ценах на API, вы поймете, какой огромный объем кода, логического вывода и параллельных задач это подразумевает. Это не человек стучит по клавиатуре, это сотни и тысячи «кремниевых мозгов» неутомимо работают на полную мощность.
Чтобы более наглядно оценить, OpenAI ввела концепцию: «рабочий день агента» (каждые 8 часов использования агента считается одним рабочим днем).
Данные показывают, что средний «рабочий день агента» на исследователя вырос с первоначальных 0.5 до ужасающих 5.7, увеличившись в 11 раз!
В самых ключевых командах предтренировки и посттренировки это число достигло 8.
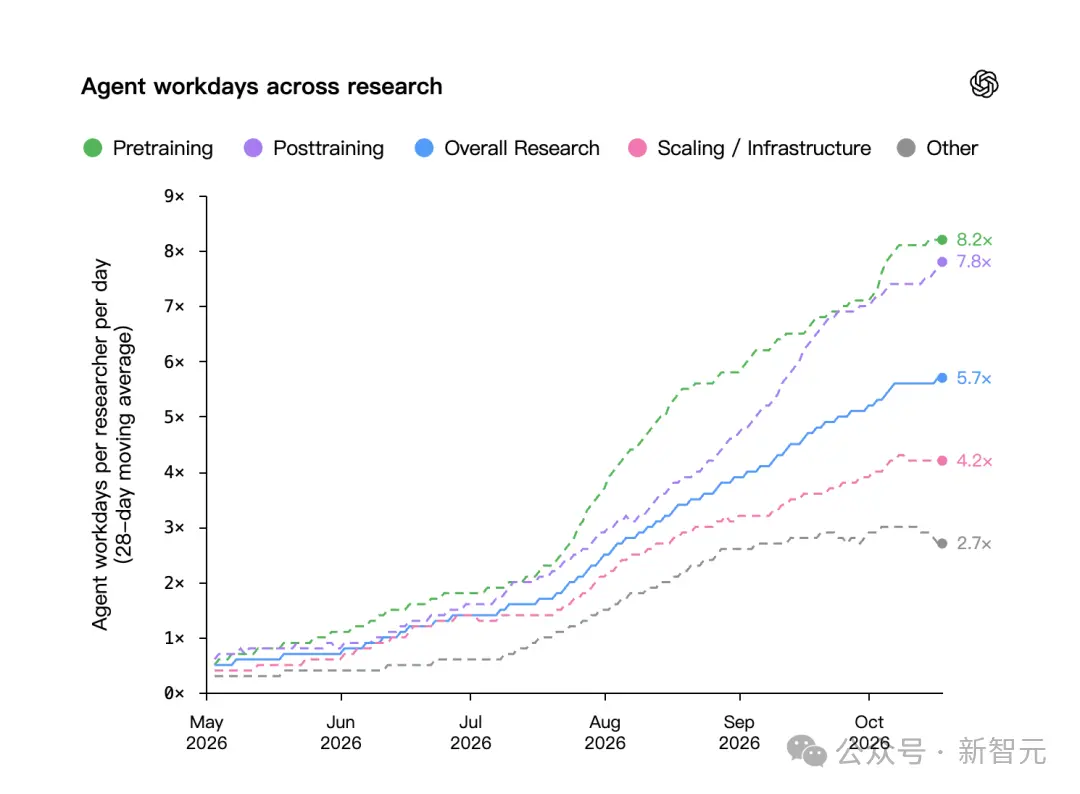
Это означает, что один человеческий исследователь работает 8 часов в день, а его «AI-двойники» одновременно выполняют объем работы, эквивалентный 64 часам.
К середине октября более одной десятой исследователей ежедневно имели по крайней мере 16 агентов, одновременно обрабатывающих задачи.
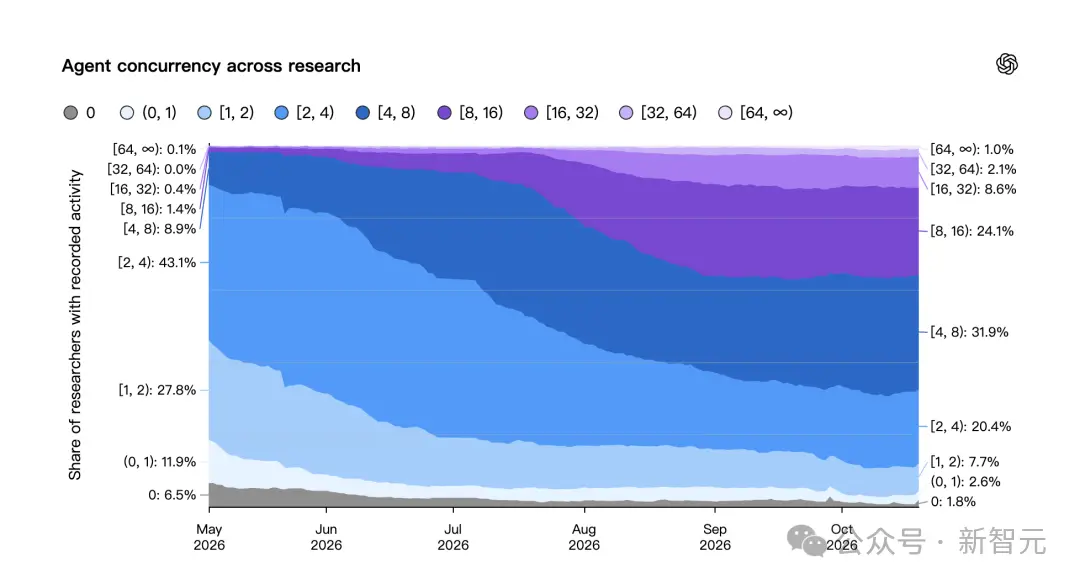
Зависимость человеческих инженеров от этих ИИ-инструментов достигла почти «пристрастия».
В анонимном опросе, проведенном внутри OpenAI, исследователям был задан крайне острый вопрос: «Если в течение следующих 3 месяцев у вас отберут всех ваших кодирующих агентов, превосходящих GPT-5.2, что вы готовы отдать, чтобы вернуть их?»
Средний ответ потрясал: они готовы сократить команду на 40%, или уменьшить текущую вычислительную мощность на 30%.
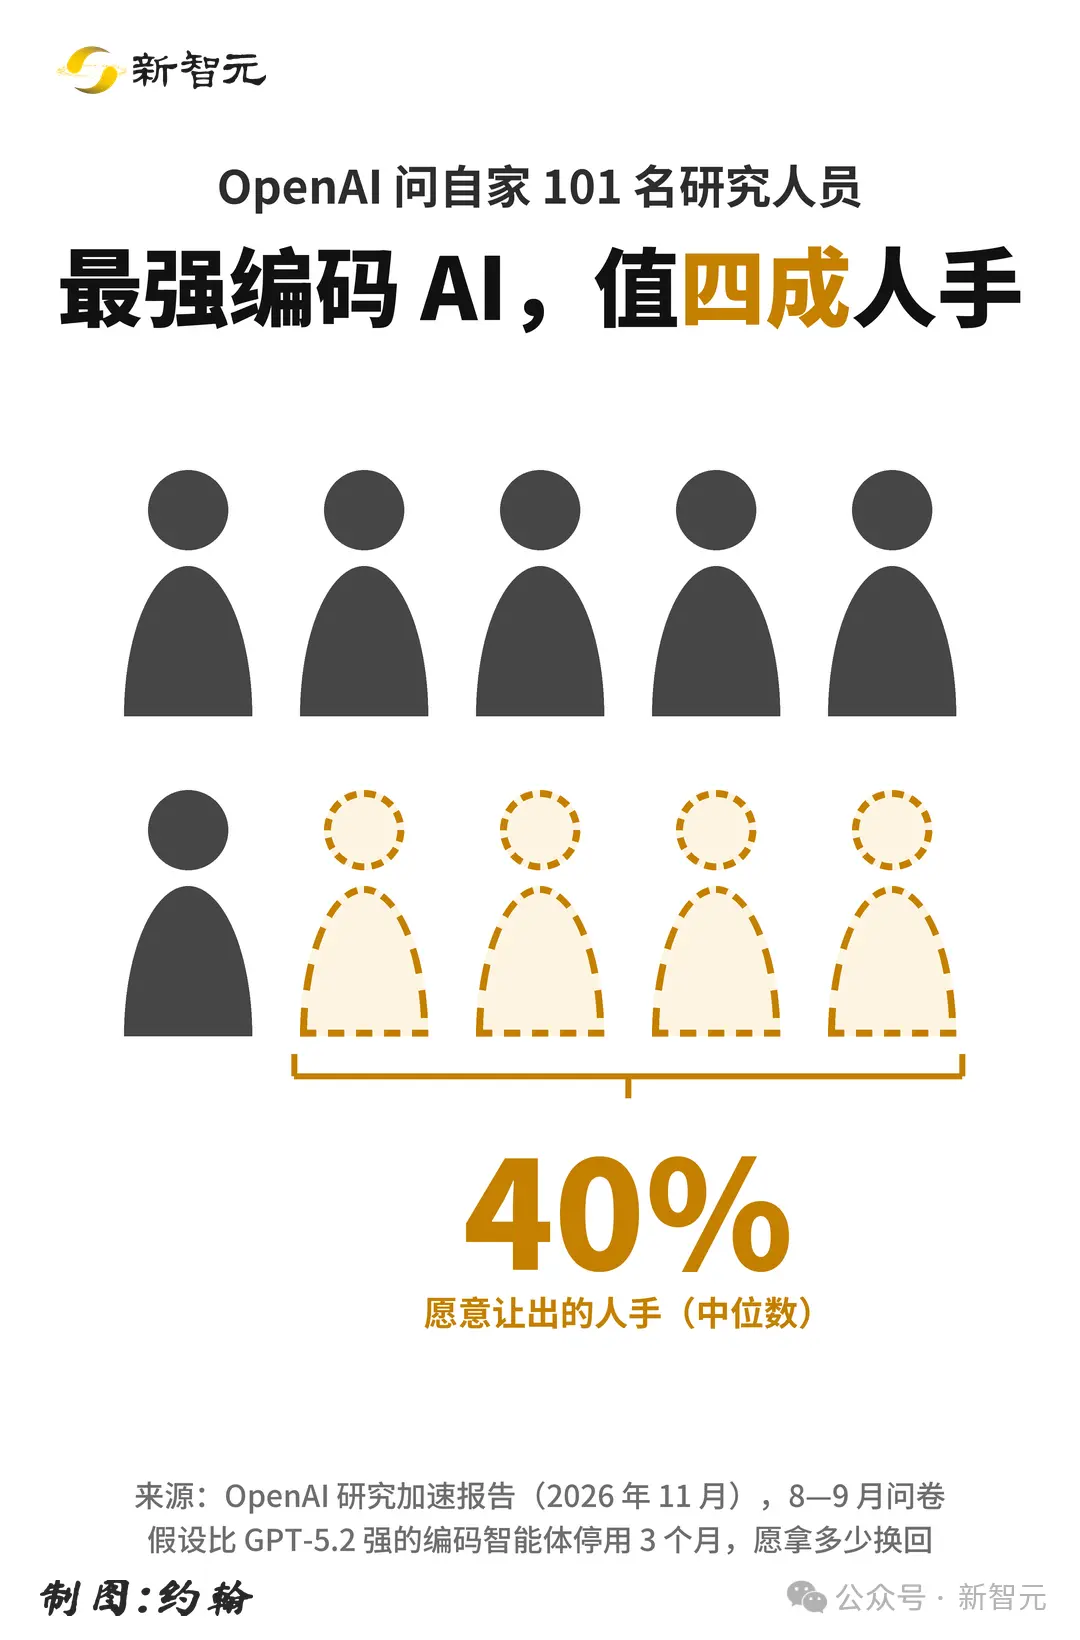
В глазах лучших исследователей ИИ несколько дорогих кластеров вычислительной мощности H100, даже живые коллеги, уже не могут сравниться с ценностью передового кодирующего агента.
Действительно пугающая деталь: ИИ начинает иметь «научный вкус»
Действительно шокировало людей из Силиконовой долины — это внутренние подробности разработки GPT-6.2 Astra.
Ранее большие идеи (Big Ideas) всегда были прерогативой человека.
При разработке более ранней версии GPT-6 Astra исследователи OpenAI все еще гордо заявляли: основные научные идеи полностью придуманы человеком, модель лишь высококлассный программист, отвечающий за превращение идей в код.
Но с приходом GPT-6.2 Astra ситуация изменилась тонко, но фатально.
В интервью исследователи команды предтренировки признали, что ключевые идеи возникли в результате многократных диалогов с моделью (Codex).
Один из исследователей четко заявил, что Codex точно определил ключевые идеи, когда они совместно развивали одну идею.
Другой ключевой участник признался, что его первоначальная идея зашла в тупик, «только после того, как Codex предложил внести изменения, вся идея действительно начала работать.»
ИИ начинает обладать интуицией, начинает выявлять слепые пятна, которые игнорируют люди, и даже начинает направлять людей, как создать лучший ИИ.
Это называется «научный вкус» (Research Taste).
Обнаружить проблему часто сложнее, чем решить ее. Когда ИИ начинает различать «какие данные лучше», «какая архитектура более перспективна», тогда ящик Пандоры действительно открывается.
Некоторые разработчики описали этот цикл обратной связи (Feedback Loop):
- Один исследователь хочет, чтобы ИИ-модель была сильнее в логическом выводе.
- Они вызывают десятки агентов, чтобы написать базовый код, настроить окружение, провести множество экспериментов и выяснить, какие изменения действительно эффективны.
- Успешные изменения, доказанные агентами, упаковываются в следующую версию модели.
- Следующая версия модели становится умнее, и поэтому она может помочь исследователям решить более сложные ошибки кода, которые предыдущая версия не могла понять.
Цикл продолжается бесконечно.
Каждый новый лучший ИИ помогает человечеству строить следующий более мощный ИИ с беспрецедентной скоростью. Это и есть истинное «рекурсивное самоулучшение» (RSI).
Как только скорость этого маховика превысит определенную критическую точку, скорость развития ИИ полностью выйдет за рамки линейного восприятия человека, проявляя почти вертикальный экспоненциальный взрыв.
Сложный передний край: «замкнутый цикл» уже создан, но человек все еще является узким местом
Конечно, если сейчас объявить, что ИИ полностью автономен, это будет слишком сенсационно.
OpenAI признает, что текущая технология все еще имеет огромные ограничения. Они называют текущую стадию «сложным передним краем» (Jagged Frontier).
Что такое сложный? Это крайняя специализация.
С марта по октябрь этого года для сложных исследовательских задач, которые, как предполагается, требуют 2-4 часов для завершения, «ноль вмешательства успешность» агентов (то есть полное отсутствие вмешательства человека) увеличилась с 23% до 46%. Даже для более сложных задач, требующих 4-8 часов, успешность возросла с 13% до 35%.
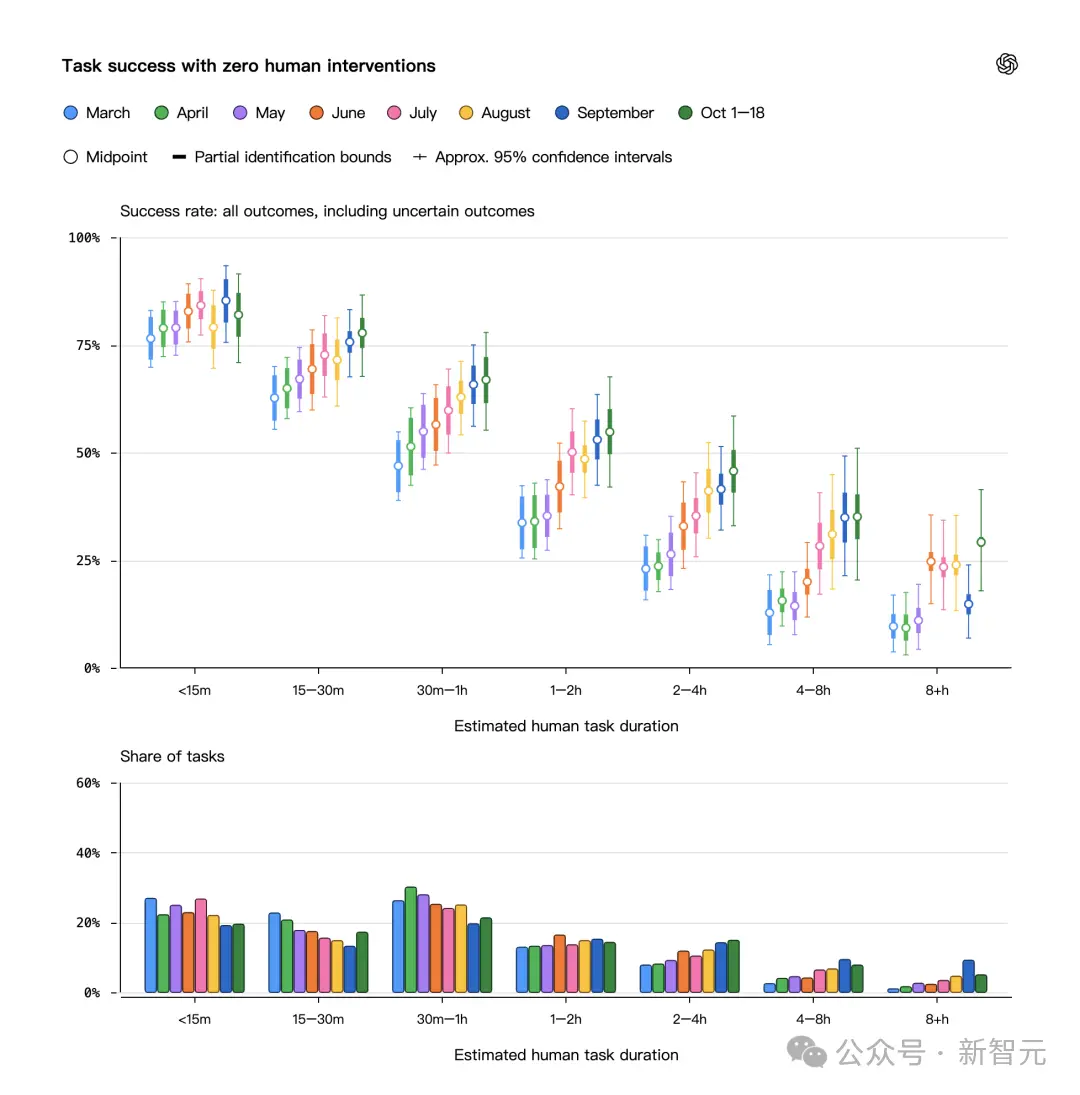
Но если разбить задачи на более мелкие, вы обнаружите, что способности ИИ очень неоднородны. Успешность в мониторинге тренировочных процессов составляет 79%. Но при написании базового кода вывода и сервисного стека, успешность всего лишь 25%.
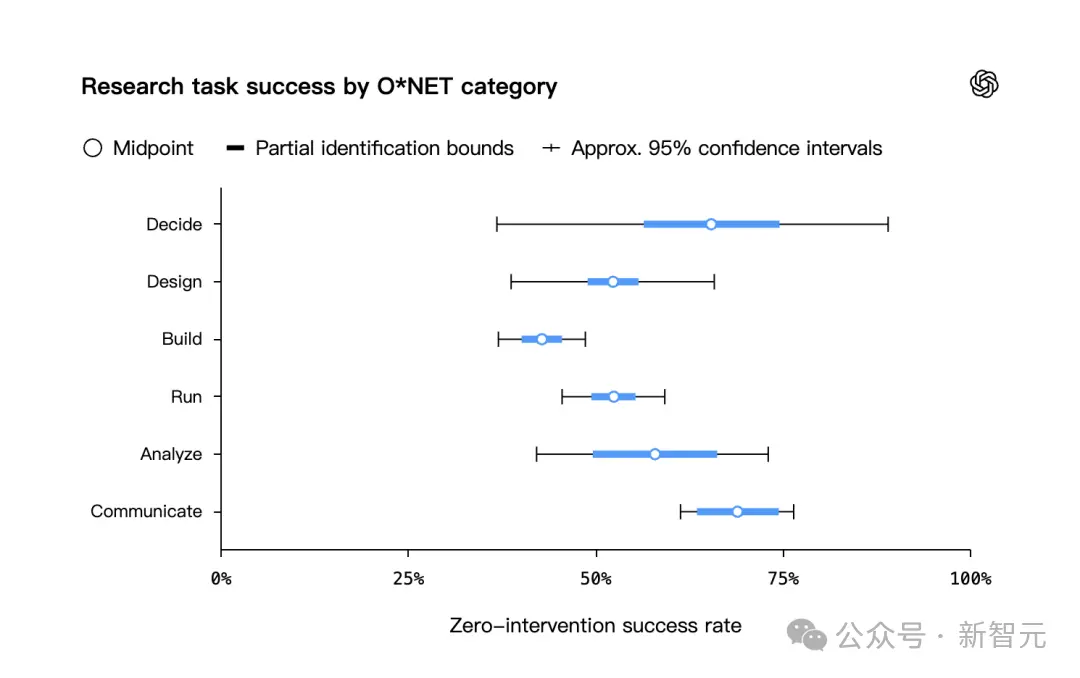
Данные показывают, что когда задача включает в себя высокую абстракцию «строительства с нуля», успешность ИИ резко падает.
Он исключительно хорош в коммуникации (69%) и анализе (58%), но в разработке (43%) все еще ведет себя как неумелый ученик.
В внутренних интервью человеческие исследователи продолжают жаловаться на ИИ.
Чтобы исправить одну небольшую ошибку, ИИ может застрять в тупике; он может написать «мусорный» PR (запрос на изменение), который выглядит эффектно, но не работает; он может производить непригодные данные и даже делать крайне абсурдные аналитические предположения.
Один исследователь, занимающийся оценкой посттренировки, безнадежно подытожил свой новый рабочий процесс:
«Я раньше пробовал прямо сказать ИИ: «сделай эту задачу так, как ту», и в результате много раз попадал в ловушку, потому что он всегда неправильно понимал, и мне приходилось убирать за ним.
Теперь стратегия изменилась, я говорю: «Сначала сделай одно, я проверю, я исправлю. Когда я подтвержу, что все верно, ты сделаешь оставшиеся десять тысяч.»»
Вот такова текущая реальность. Человек все еще является абсолютным ядром замкнутого цикла разработки ИИ, просто роль человека изменилась с «создателя» на «ревизора».
Человек предоставляет первоначальную оценку и базовый уровень допуска ошибок, в то время как ИИ отвечает за увеличение этого уровня в тысячу раз.
Но этот баланс крайне хрупок. Как сказал один исследователь в своем отчете: «Я действительно считаю, что сейчас у меня больше вкуса в научных идеях, чем у ИИ. Но я совершенно не уверен, как долго эта ситуация может продолжаться.»
Конец предопределен? Срочный призыв OpenAI и новый порядок
В конце отчета OpenAI редко сделала крайне настоятельный призыв к отрасли: обязательное раскрытие показателей RSI.
Они считают, что все ведущие лаборатории ИИ должны быть обязаны отслеживать и публично сообщать о ключевых показателях «рекурсивного самоулучшения». Общественность и регулирующие органы имеют право знать, на каком этапе находится процесс ускорения разработки будущих ИИ-систем.
Почему нужно раскрывать? Потому что скорость прогресса уже превышает традиционные интуитивные восприятия.
В отчете раскрыто, что внутренний индекс возможностей OpenAI (ECI) показывает, что с августа 2025 года передовой ECI моделей OpenAI стремительно растет на 16.4 пункта в год, превышая средний показатель по отрасли в 14 пунктов.
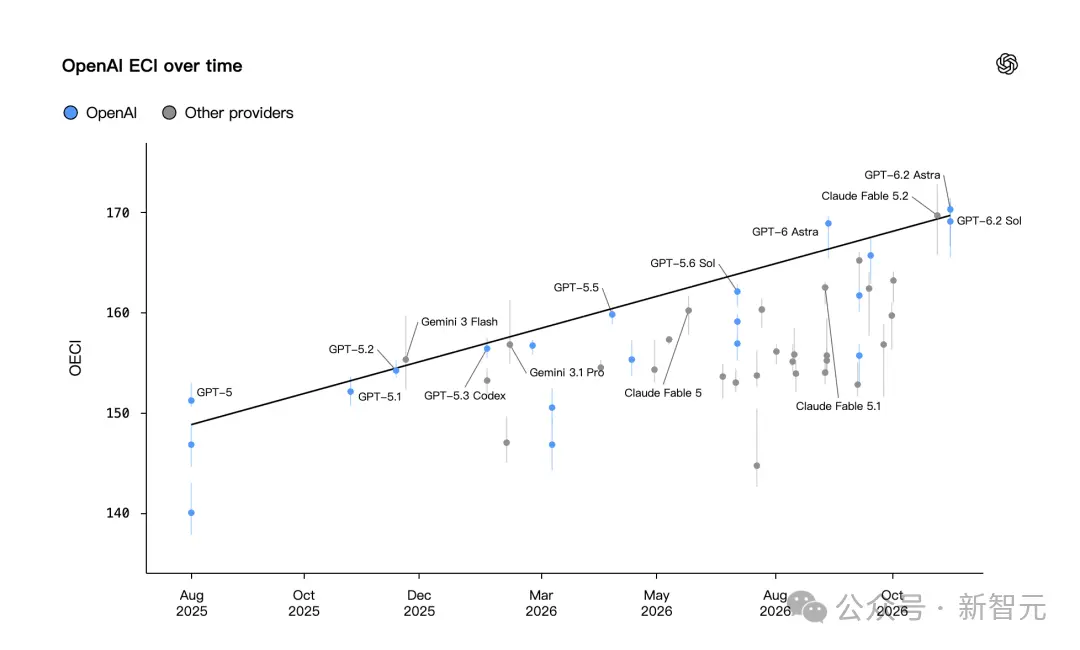
Что еще более пугающе, такой удивительный прогресс был достигнут всего лишь с использованием 2% общей вычислительной мощности OpenAI для развертывания внутренних агентов.
Представьте себе, что произойдет, когда этот процент достигнет 20%, 50% или даже 80%?
Традиционный «человеческий цикл разработки» разрушается. Ранее для итерации модели требовалось полгода на сбор данных, три месяца на обучение, два месяца на доработку. Теперь агенты используют параллельные вычисления, чтобы завершить объем работы, который человек выполняет за несколько недель, всего за несколько часов.
Как предупреждает отчет: исторические тенденции могут уже не предсказывать будущее.
В математической области передовые модели недавно продемонстрировали резкие и быстрые прорывы, «мутации» в области ИИ могут произойти в любой момент.
 Предупреждение о рисках
链捕手ChainCatcher напоминает: относитесь к блокчейну рационально, повышайте осведомлённость о рисках и будьте осторожны с выпуском и спекуляциями виртуальными токенами. Весь контент на сайте является рыночной информацией или мнением соответствующих сторон и не является инвестиционной рекомендацией в любой форме. Если вы обнаружите чувствительную информацию, нажмите — мы оперативно разберёмся.
Популярные статьи