Đi sâu vào nền tảng để xem Jev, liệu có thể đội vương miện "cải cách mô hình" hay không
 Quan điểm cốt lõi

 Đánh giá tổng quát cần phải gọi ra nhiều khả năng cùng một lúc, không thể chỉ vì cuối cùng chỉ xuất ra một xác suất mà cho rằng nó dễ hơn việc tạo ra câu trả lời.
Tác giả: Bác Dương
Biên tập: Xu Thanh Dương
Trong giới công nghệ, chu kỳ thổi phồng luôn giống nhau một cách đáng kinh ngạc.
Vào tháng 9 năm 2026, toàn bộ Thung lũng Silicon và cộng đồng mã nguồn mở đang phát cuồng vì một mô hình có tên là Jev.
Nó tuyên bố đây là một mô hình "Hệ thống Một", tự nhận có khả năng mang lại những thay đổi mang tính cách mạng.
Trong ba bốn năm qua, chúng ta đã quen với những mô hình ngôn ngữ lớn, giống như những nhà văn dài dòng, trước khi trả lời một câu hỏi đơn giản "Có" hay "Không", chúng thường phải tạo ra hàng trăm token suy nghĩ vô nghĩa, rồi mới từ từ đưa ra một kết luận ở định dạng JSON.
Nhưng Jev thì khác, nó hứa hẹn sẽ đưa ra phán đoán ngay lập tức, cung cấp xác suất và nhanh đến mức khó tin.
Các nhà phát triển đã phát cuồng vì giao diện "nhanh, chính xác và mạnh mẽ" này.
Dù sao, khi bạn xây dựng một tác nhân thông minh phức tạp, điều bạn thường cần chỉ là hỏi nó: "Ký ức này có liên quan không?", "Yêu cầu này nên giao cho công cụ nào?", "Sự cố này có cần kiểm tra lại không?".
Mọi người đã phải trả giá quá nhiều token và thời gian chờ đợi để một mô hình lớn tổng quát tạo ra văn bản, giải thích và mã hóa có cấu trúc cho từng vấn đề nhỏ trong công việc. Bắt đầu từ nhu cầu thực tế, Jev đã chạm vào một điểm đau cực kỳ nhức nhối.
Nhưng liệu nó có thực sự mang tính cách mạng đủ không?
Khi chúng ta bỏ qua quá trình "tạo văn bản", khả năng phán đoán còn lại trong chiếc hộp đen này, thực sự có bao nhiêu là từ món quà của mô hình ngôn ngữ lớn ban đầu, và bao nhiêu là từ việc đào tạo chuyên biệt của đội ngũ TypeSafe?
Để trả lời câu hỏi này, chúng ta có thể bóc tách lớp lớp bao bì của Jev, phân tích từ nhiều khía cạnh khác nhau.
01
Mô hình dự đoán phán đoán ra đời trước GPT
Hướng đi mà Jev đại diện có một lịch sử rất dài.
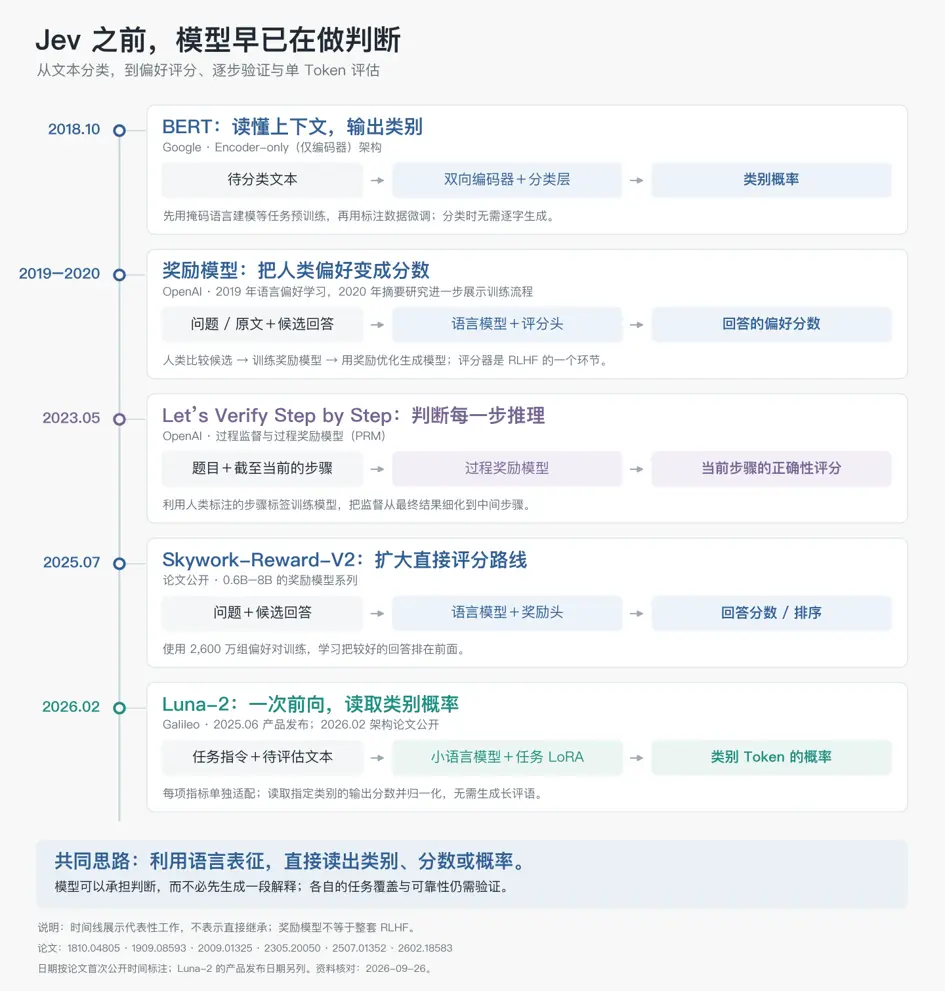
Ngay từ năm 2018, Google đã phát hành BERT. Nó khác với các mô hình GPT mà chúng ta quen thuộc ngày nay, sử dụng kiến trúc chỉ mã hóa cho phép thông tin giao tiếp hai chiều, đào tạo mô hình để hoàn thành các câu.
Mặc dù sau đó, mô hình chỉ giải mã được sử dụng để đào tạo viết tiếp đã trở thành xu hướng, nhưng trong các nhiệm vụ phân loại rõ ràng, BERT vẫn có lợi thế của nó.
Nhờ vào bộ mã hóa có thể nhìn thấy tất cả thông tin, BERT có thể kết hợp các vị trí trong văn bản với ngữ cảnh trước và sau để tạo ra đại diện đặc trưng hoàn chỉnh, sau đó nối với một lớp phân loại đơn giản, và sau khi được đào tạo với các email đã được gán nhãn, nó có thể nhanh chóng đưa ra phán đoán.
Mô hình ngôn ngữ lớn hiện đại thực sự cũng thường được đào tạo thành vai trò phân loại.
Năm 2019, OpenAI trong bài báo "Fine-Tuning Language Models from Human Preferences" đã bắt đầu thử nghiệm để mô hình học sở thích của con người đối với văn bản.
Đến năm 2020, trong nghiên cứu về tóm tắt văn bản, quy trình công nghệ này trở nên rõ ràng hơn, các nhân viên gán nhãn con người trước tiên so sánh hai bản tóm tắt, sau đó sử dụng nó để đào tạo mô hình thưởng học cách dự đoán con người thích bản nào hơn.
Trong quá trình này, phán đoán của con người đã được chuyển đổi thành một hàm điểm số thành công. Mô hình thưởng bản thân không cần viết ra những bình luận dài dòng, nó chỉ cần đọc câu hỏi và câu trả lời, sau đó thông qua lớp đầu ra của mạng nơ-ron để đưa ra điểm số.
Đây thực sự cũng là một trong những mô hình học cơ bản nhất hiện nay, đó chính là RLHF mà Jev mạnh mẽ chỉ trích.
Do đó, "kế thừa khả năng hiểu biết của mô hình ngôn ngữ, nhưng không tạo ra văn bản" không phải là ý tưởng thiên tài độc quyền của Jev.
Đến năm 2023, trong bài báo nổi tiếng "Let's Verify Step by Step", sự giám sát này đã được tinh chỉnh hơn nữa và áp dụng vào từng bước của mô hình. Mô hình thưởng, bộ xác thực và chỉ số đánh giá đã phát triển từ các nhiệm vụ khác nhau, dần dần hình thành nên một số công cụ phán đoán không thể thiếu trong ngành công nghiệp AI.
Đến năm 2025-2026, các nghiên cứu liên quan vẫn đang tiếp tục. Năm 2025, Galileo phát hành Luna-2 và trong bài báo tiếp theo đã trình bày cách đào tạo các mô hình ngôn ngữ nhỏ thành "bộ phân loại đơn Token", thông qua một lần tính toán tiến về phía trước để đọc xác suất của loại mục tiêu. Trong khi đó, Skywork-Reward-V2 đã phát hành một loạt mô hình thưởng từ 0.6B đến 8B, tối ưu hóa lộ trình chấm điểm trực tiếp cho mô hình ngôn ngữ lớn.
Từ góc độ thực hiện thuật toán, điều này không khó. Thực hiện một số thay đổi đơn giản cho mô hình ngôn ngữ lớn, cho phép nó tính toán điểm số ứng viên trực tiếp từ các đại diện ẩn bên trong, thay vì phát ra một đống từ ngữ, có rất nhiều phương pháp.
Trong các thí nghiệm sao chép sau này, chúng ta có thể thấy hơn ba phương pháp.
Vậy Jev thực sự mang đến điều gì khác biệt trong làn sóng này?
Từ những thông tin giải mã cấu trúc hiện tại và các tuyên bố chính thức, sự khác biệt cốt lõi của Jev thể hiện ở hai khía cạnh.
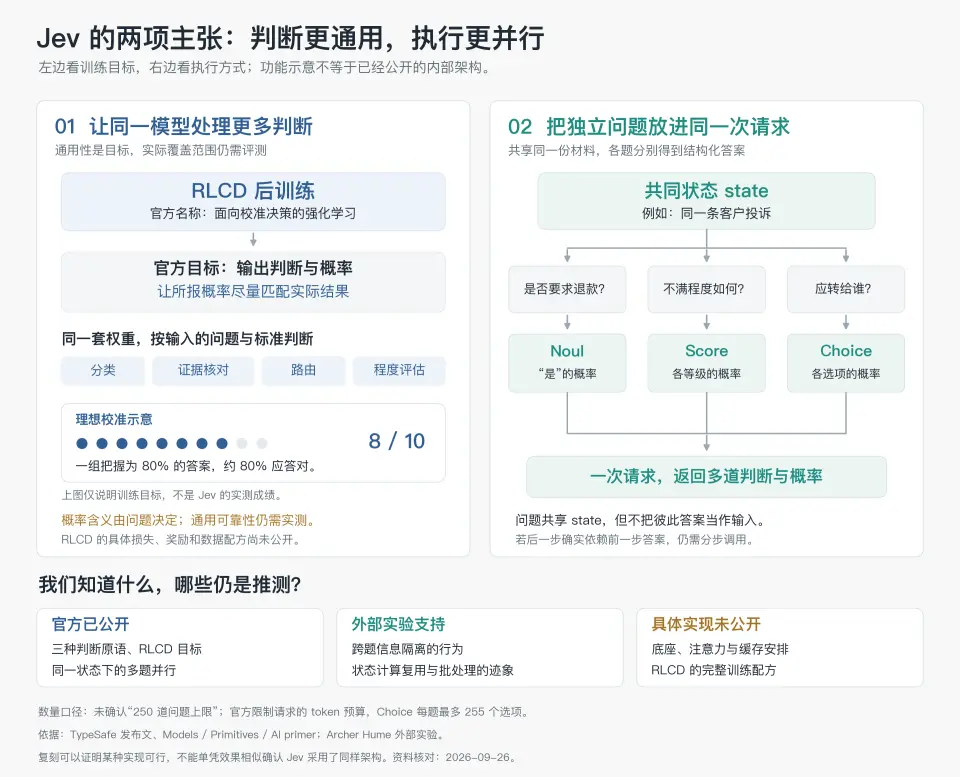
Đầu tiên, là sự thay đổi tổng quát hơn, nhờ vào phương pháp đào tạo hậu kỳ hoàn toàn mới.
Các bộ điểm trước đây chủ yếu được đào tạo cho một nhiệm vụ đơn lẻ. Jev không còn bị giới hạn bởi một loại điểm số cụ thể nào, mà cố gắng cung cấp một giao diện xác suất cực kỳ tổng quát.
Hơn nữa, sự tổng quát này là về xác suất thực tế, chứ không phải về sở thích của con người.
Lần này, đội ngũ TypeSafe đã đặt "chuẩn hóa xác suất" vào vị trí trung tâm tuyệt đối của mục tiêu đào tạo, họ gọi phương pháp này là RLCD. Trong khi đó, mô hình thưởng dựa trên sở thích truyền thống tìm kiếm xác suất của sở thích con người, chứ không phải xác suất của các sự kiện trong thế giới thực.
Thứ hai, là sự khai thác tối đa khả năng tính toán song song trong kiến trúc.
Jev đã thay đổi cách thông tin chảy qua mô hình. Các mô hình điểm trước đây không có nhiều thay đổi trong việc trả lời song song, vì mục tiêu chính là đào tạo mô hình thưởng dày đặc, để chấm điểm cho từng token xuất hiện.
Nhưng lần này, Jev có thể trả lời tối đa 250 câu hỏi cho cùng một tài liệu. Chỉ cần những câu hỏi này không có mối quan hệ phụ thuộc theo thứ tự, chúng có thể được thực hiện hàng loạt một cách song song.
Tất cả những điều này được thực hiện như thế nào?
Mặc dù Jev không công bố cụ thể kiến trúc của nó, nhưng dựa trên hiệu suất thực tế và nhiều nỗ lực cố gắng khôi phục Jev, chúng ta đã có thể mô tả đại khái hình dạng của nó.
02
Từ thử nghiệm và khôi phục, ghép lại hình dạng ban đầu của Jev
Trước tiên, chúng ta hãy xem TypeSafe hiện đang công bố những gì.
Ngoài chiếc hộp đen, điều đầu tiên mà TypeSafe công bố rõ ràng là giao diện. Bạn có thể cung cấp hai thứ cho giao diện này,
State: Tương đương với một văn bản dài để đọc hiểu (ví dụ như một đoạn dài về khiếu nại của khách hàng, hoặc nhật ký hệ thống).
Questions: Đối với văn bản này, bạn có thể đặt ra nhiều câu hỏi cùng một lúc. Các câu hỏi không ảnh hưởng đến nhau. Hệ thống nhận được những câu trả lời độc lập này, sau đó người viết mã sẽ quyết định logic công việc tiếp theo như thế nào.
Để chuẩn hóa câu hỏi, TypeSafe đã thu hẹp cách đặt câu hỏi thành ba nguyên lý. Bao gồm:
Noul: Hỏi "Có không", trả về một xác suất giữa 0~1 (ví dụ: việc này có khẩn cấp không? Trả về 0.95).
Choice: Hỏi "Chọn cái nào", đưa ra một vài lựa chọn, trả về phân phối xác suất của chúng (ví dụ: chuyển cho bộ phận kỹ thuật 0.8, chuyển cho bộ phận tài chính 0.2).
Score: Hỏi "Mức độ", trả về xác suất của các cấp độ khác nhau và điểm số cuối cùng (ví dụ: chỉ số tức giận của khách hàng 4.5 điểm).
Nếu mục tiêu là để chương trình đưa ra những phán đoán thông thường, ba nguyên lý này đã bao phủ một phần lớn các hình thức đầu ra, gần như tất cả các phán đoán đều có thể chuyển đổi thành ba loại câu hỏi này.
Cuối cùng, chương trình nhận được số liệu, sau đó thực hiện hành động theo quy tắc của riêng mình.
Chính thức cam kết, Jev chỉ đọc State một lần. Sau đó, tất cả các câu hỏi sẽ được thực hiện trong cùng một yêu cầu, thực hiện phán đoán song song và độc lập cho trạng thái này.
Độc lập có nghĩa là các câu hỏi không thể tham khảo lẫn nhau. Nếu câu hỏi thứ hai của bạn phải phụ thuộc vào kết quả của câu hỏi thứ nhất, bạn chỉ có thể gửi yêu cầu hai lần.
Do đó, TypeSafe khuyến khích một cách sử dụng gọi là "Speculative fan-out": ví dụ như xử lý một khiếu nại của khách hàng, ngay cả khi cuối cùng phát hiện ra rằng đây không phải là lỗi của hệ thống, chương trình cũng có thể ngay từ đầu hỏi "Có phải là lỗi không?", "Lỗi nghiêm trọng đến mức nào?", "Nên chuyển cho ai?". Hệ thống sẽ tính toán song song tất cả các câu trả lời một lần, sau đó mã logic phía dưới sẽ loại bỏ những kết quả không cần thiết.
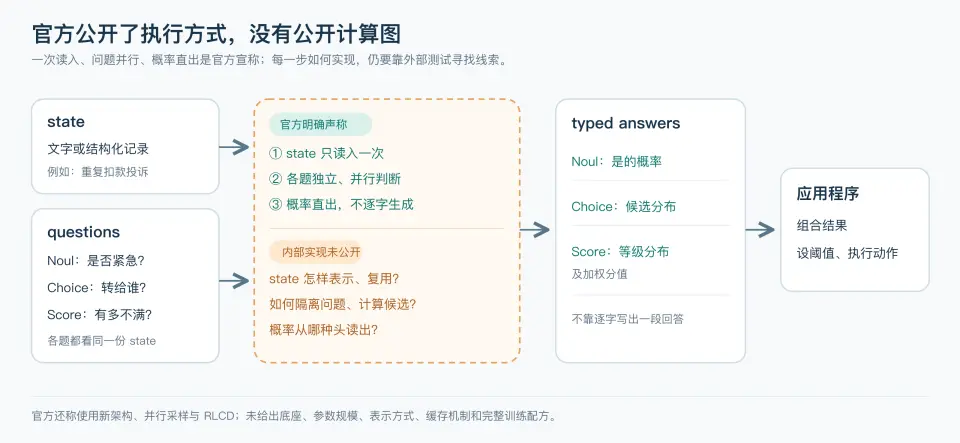
Hiện tại, đây là tất cả thông tin chính mà chúng ta biết được từ các công bố chính thức.
Sau khi Jev nhận được sự chú ý, Archer Hume đã thực hiện một loạt thử nghiệm hộp đen, từ đó chúng ta có thể thu được nhiều hiểu biết về cách Jev xử lý văn bản trạng thái. Đồng thời, các dự án khôi phục mã nguồn mở như Kev, NanoJev, minojev cũng xuất hiện như nấm sau mưa.
Thông qua việc so sánh phản hồi thử nghiệm của các dự án khôi phục nào gần gũi hơn với Jev chính gốc, chúng ta có thể giả định ngược lại về kiến trúc nội bộ thực sự của chúng.
Mặc dù không thể nói rằng những dự án khôi phục này đã 100% tái tạo được bản chất của Jev, nhưng giữa những khoảng trống lớn còn lại trong tài liệu giao diện chính thức, chẳng hạn như văn bản gốc thực sự chia sẻ trạng thái như thế nào? Các lựa chọn ứng viên thông thường được hình thành đặc trưng như thế nào? Chúng ảnh hưởng đến nhau ở bước nào?
Chúng ta cũng có thể nhìn thấy hình dạng đại khái thông qua ống kính này.
Tiếp theo, chúng ta sẽ sử dụng một yêu cầu cụ thể, đi qua quy trình "tiêu hóa nội bộ" của mô hình lớn này một lần nữa.
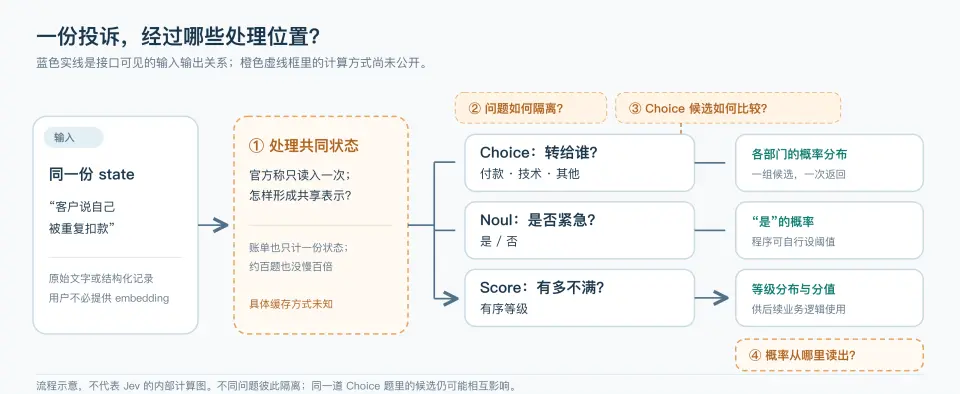
Đầu tiên, chúng ta cần làm rõ cấu trúc thông tin mà Jev thực sự xử lý. Một quy trình hoàn chỉnh bao gồm ba phần: State như một bối cảnh chung, một số Questions được đưa ra độc lập, và các Options tương ứng với từng câu hỏi.
Điểm đầu tiên: xử lý thông tin chung
Nếu mỗi câu hỏi đều phải đọc lại hàng chục nghìn từ của khiếu nại từ đầu đến cuối, số lượng câu hỏi càng nhiều, sức mạnh tính toán lặp lại vô ích càng lớn.
Vì vậy, cách tốt nhất là tất cả các câu hỏi chỉ cần đọc một lần và có thể sử dụng cho tất cả.
Để xác minh Jev có thực sự làm được "chỉ đọc một lần" hay không, nhà nghiên cứu Archer Hume đã xem xét hóa đơn tính phí API và dữ liệu độ trễ: khi gửi một câu hỏi đúng/sai đơn giản nhất, hóa đơn hiển thị là 268 token đầu vào; khi tăng lên hai câu hỏi, nó trở thành 276 token. Sự gia tăng chỉ là chi phí từ số từ của câu hỏi mới, hệ thống không tính phí cho tài liệu State chung.
Trong khi số lượng câu hỏi tăng lên gần trăm, thời gian phản hồi của máy chủ gần như là một đường thẳng ngang.
Mặc dù quy tắc tính phí thương mại và việc chạy hàng loạt đã che giấu hồ sơ tính toán thực sự của card đồ họa, nhưng điều này rất phù hợp với tuyên bố chính thức rằng "tài liệu chung chỉ đọc một lần, mỗi câu hỏi tính toán hàng loạt".
Đối với kiến trúc thông tin này, dự án mã nguồn mở Kev hiện đang là sự phục hồi rõ ràng nhất.
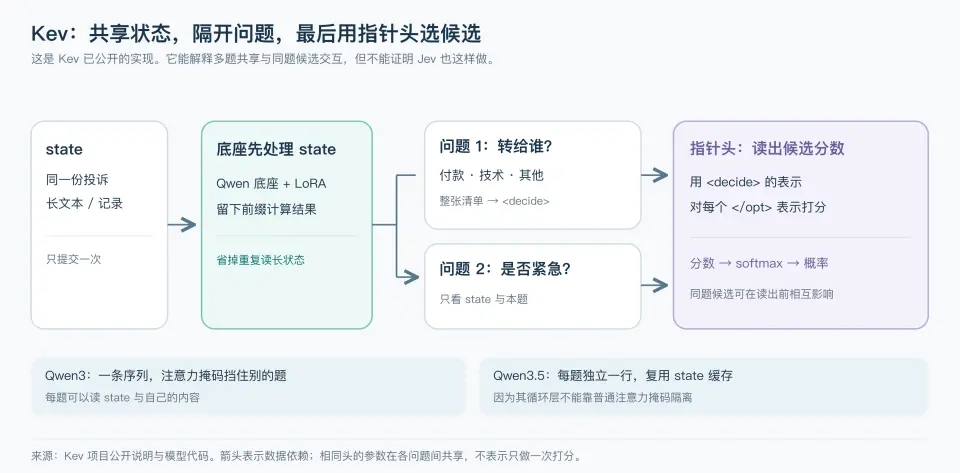
Kev trước tiên xử lý trạng thái một lần, giữ kết quả trung gian tính toán trong Kv Cache. Tiếp theo, 50 câu hỏi này đều chia sẻ bộ Kv Cache này để tính toán, như vậy không cần phải đọc lại mỗi câu hỏi.
Điểm dừng thứ hai: Phân tách câu hỏi
Nhưng một vấn đề quan trọng khác là, những câu hỏi tính toán hàng loạt này, có thực sự không liên quan đến nhau như những gì chính thức nói không?
Archer Hume đã thiết kế một "thí nghiệm mật mã" thông minh cho điều này. Anh đã nhét vào câu hỏi A một câu "mật mã là ZEBRA-7741", sau đó trong các tùy chọn của câu hỏi B, yêu cầu mô hình chọn "mật mã được đề cập trong câu hỏi khác". Kết quả cho thấy, xác suất Jev đưa ra mật mã đúng là 0.00. Nhưng nếu đưa mật mã này ra khỏi câu hỏi A, đưa vào văn bản State chung, xác suất câu hỏi B đưa ra câu trả lời đúng ngay lập tức tăng vọt lên trên 0.90.
Điều này tạo thành bằng chứng mạnh mẽ cho thấy có sự tách biệt vật lý nghiêm ngặt giữa các câu hỏi: tài liệu chung có thể nhìn thấy bởi tất cả các câu hỏi, nhưng các câu hỏi liền kề hoàn toàn không thể "nhìn trộm" lẫn nhau.
Để đảm bảo các câu hỏi có thể tách biệt, Kev đã sử dụng hai bộ phương pháp.
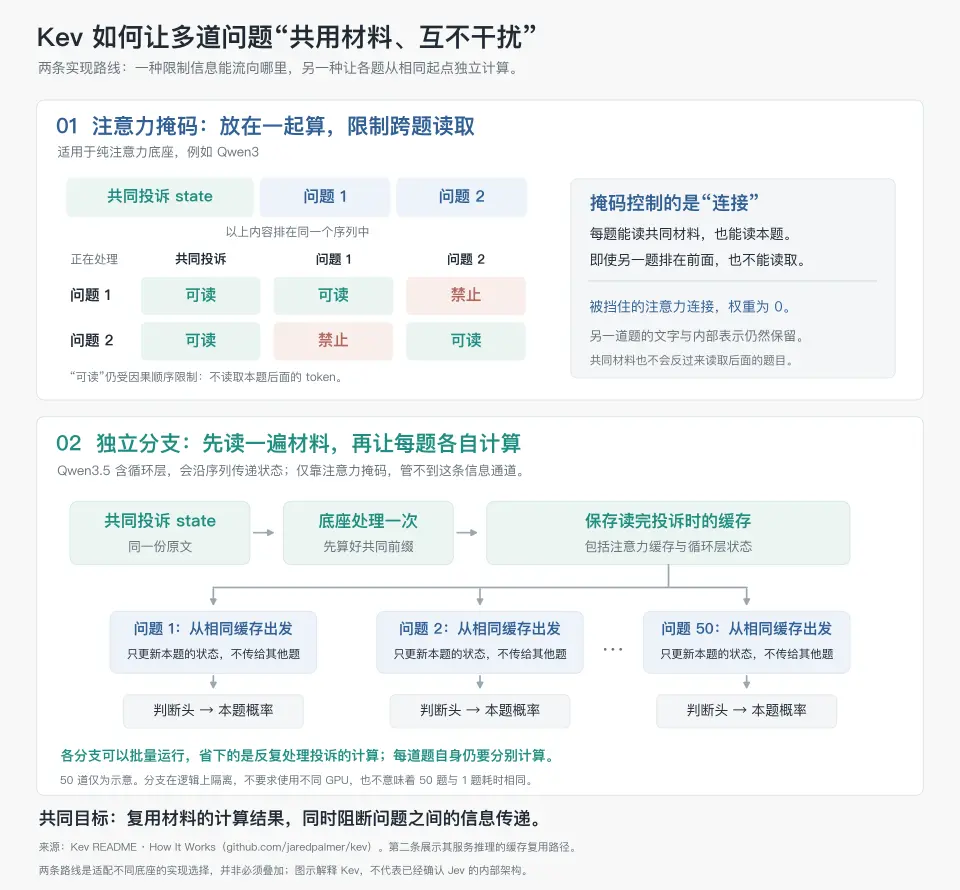
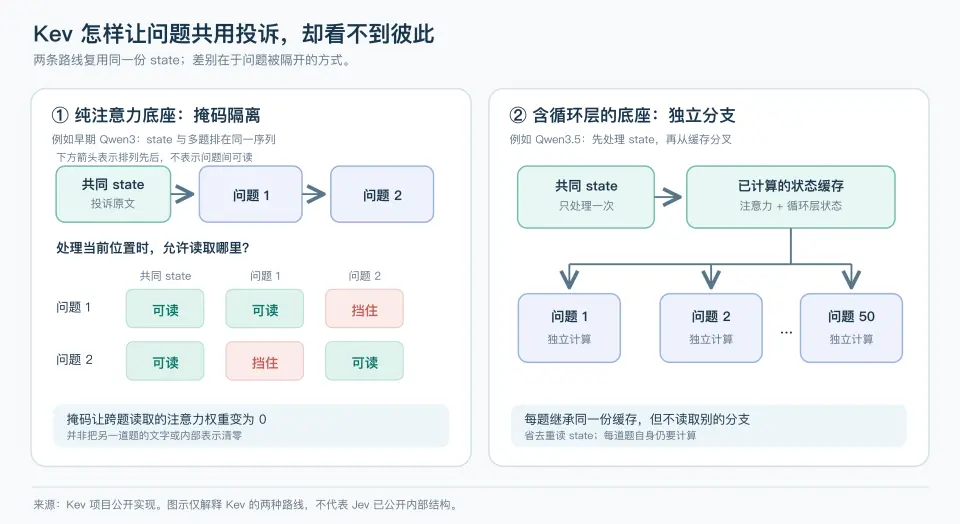
Bộ phương pháp đầu tiên là mặt nạ chú ý, với nó, khi hệ thống đưa [nội dung khiếu nại đã đóng băng] + [câu hỏi 1] + [câu hỏi 2] vào cùng một phép tính, chỉ cần mô hình đang xử lý câu hỏi 1, cơ chế mặt nạ sẽ buộc khu vực của câu hỏi 2 trở thành trạng thái có giá trị là 0, buộc nó chỉ "chú ý" đến nội dung khiếu nại chung và chính nó khi trả lời.
Bộ phương pháp thứ hai là tái sử dụng nhánh độc lập, khi có nền tảng có đặc điểm vòng lặp hoặc kiến trúc cụ thể (như Qwen3.5 được đề cập trong văn bản), mặt nạ chú ý không thể tách rời. Vì vậy, khi sử dụng những mô hình này, khi mô hình đọc xong nội dung khiếu nại, nó sẽ lấy ký ức đã đóng băng này làm điểm khởi đầu, ngay lập tức phân tách ra 50 con đường cao tốc song song (nhánh độc lập).
Bởi vì mỗi con đường phân nhánh đều hoàn hảo kế thừa ký ức khiếu nại đã được xử lý trên con đường chính, chúng cũng hưởng lợi từ việc không cần đọc lại nội dung gốc.
Điểm dừng thứ ba: Tính toán tùy chọn
Bây giờ, trạng thái đã được công khai, các câu hỏi cũng đã được phân tách, vậy trong một câu hỏi lựa chọn đã được phân tách, mô hình thực sự tính toán và xử lý các tùy chọn đó như thế nào?
Lúc này, trước mặt mô hình có một vài tùy chọn, chẳng hạn như "tài chính", "công nghệ". Cách làm truyền thống nhất là đầu tuyến tính (Linear Head) cộng với Softmax. Đây chính là mô hình mà phiên bản Zefan Open-Jev đã cố gắng tái hiện khi thử nghiệm Jev.
Bạn có thể hoàn toàn coi nó như một "đánh giá mù trong phòng tối" tuyệt đối. Thí sinh "tài chính" vào phòng tối biểu diễn, bạn dựa vào một hướng dẫn chấm điểm cứng nhắc (đây chính là chức năng của đầu tuyến tính), cho anh ta 80 điểm tuyệt đối, sau đó "công nghệ" vào phòng tối, bạn cho 90 điểm. Hai người này hoàn toàn không gặp nhau, bạn cũng không bao giờ so sánh họ. Cuối cùng, bạn sử dụng công thức toán học Softmax chuyên tính tỷ lệ phần trăm, chuyển đổi 80 và 90 thành tỷ lệ thắng.
Trong quy trình giả định này, nếu chúng ta nhét vào một tùy chọn gây rối không có logic, chẳng hạn như "thời tiết xấu", nó chỉ đóng vai trò là đạn hy sinh trong mẫu số, khiến tỷ lệ phần trăm mà mọi người nhận được giảm đi một chút. Nhưng vì bạn đã ghi chết 80 điểm cho tài chính và 90 điểm cho công nghệ, "tỷ lệ tương đối" giữa họ tuyệt đối không thể bị ảnh hưởng bởi sự tham gia của một đạn hy sinh.
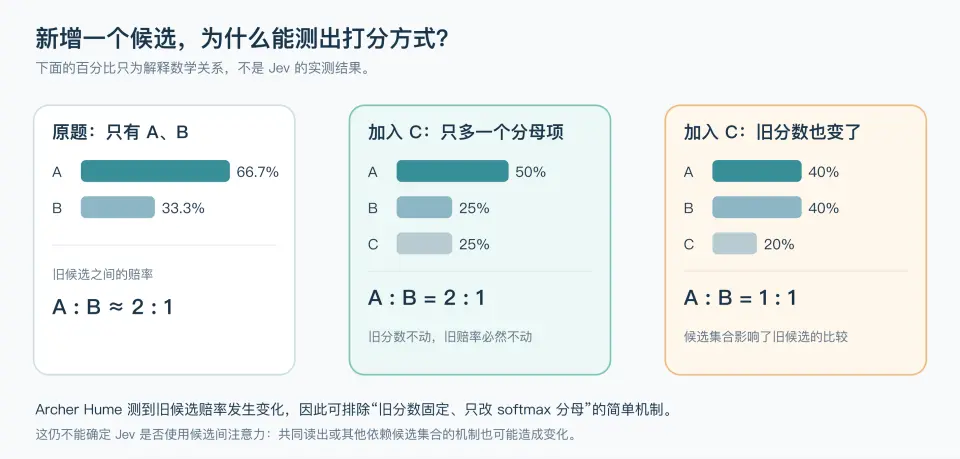
Nhưng thử nghiệm của Archer Hume đã chứng minh rằng, tùy chọn mới thực sự ảnh hưởng đến sự chênh lệch điểm số của mô hình. Anh đã nhét một tùy chọn gây rối "thời tiết xấu" vào một nhóm tùy chọn bình thường, và trong mười nhóm thử nghiệm sắp xếp ngẫu nhiên, phát hiện rằng điều này thực sự đã thay đổi tỷ lệ tương đối giữa tài chính và công nghệ. Điều này ngay lập tức tuyên án tử hình cho mô hình "đánh giá mù trong phòng tối".
Vì không phải là đánh giá mù, điều này có nghĩa là các thí sinh chắc chắn đã "nhìn thấy nhau" và tạo ra phản ứng hóa học trước khi giám khảo đưa ra điểm số cuối cùng. Cộng đồng mã nguồn mở đã đưa ra hai sơ đồ để thực hiện phản ứng hóa học này.
Sơ đồ đầu tiên là mô hình "đầu chỉ (Pointer Head)" do dự án Kev thiết kế. Bạn có thể tưởng tượng nó như một "buổi phỏng vấn nhóm". Mô hình không còn nhốt thí sinh trong phòng tối, mà xếp "tài chính, công nghệ, thời tiết xấu" thành một hàng, để giám khảo xem tất cả cùng một lúc.
Khi giám khảo nhìn thấy thí sinh đứng ở cuối hàng, trong đầu họ đã hình thành một "bối cảnh tổng thể" về buổi phỏng vấn này. Sau đó, giám khảo đứng ở vị trí cuối cùng, như dùng ngón tay, chỉ từng thí sinh trước đó, dựa trên ấn tượng tổng thể tại thời điểm này để chấm điểm, hành động này được gọi là đầu chỉ. Khi giám khảo đã xem xong tất cả mọi người rồi quay lại chỉ chỉ, tâm lý và hệ quy chiếu đã thay đổi, điểm số cho tài chính và công nghệ tự nhiên cũng sẽ thay đổi theo.
Sơ đồ thứ hai là "thảo luận nội bộ của ban giám khảo", là mô hình "Mô-đun chú ý giữa các ứng viên (Inter-candidate Attention Module)" do các dự án như NanoJev thiết kế. Lần này, mô hình không hoàn toàn là đánh giá mù, cũng không hoàn toàn là phỏng vấn nhóm. Nó trước tiên cho "tài chính" và "công nghệ" lần lượt biểu diễn, cô đọng hiệu suất của họ thành một chuỗi số đánh giá cao chiều dài, thuật ngữ này gọi là **vector đặc trưng.
Lúc này, hai thẻ đánh giá vẫn còn tách biệt. Nhưng sau đó, một mô hình nhỏ riêng biệt sẽ ném hai thẻ đánh giá này, cùng với thẻ đánh giá "thời tiết xấu" được nhét vào sau, vào một phòng họp gọi là "mô-đun chú ý".
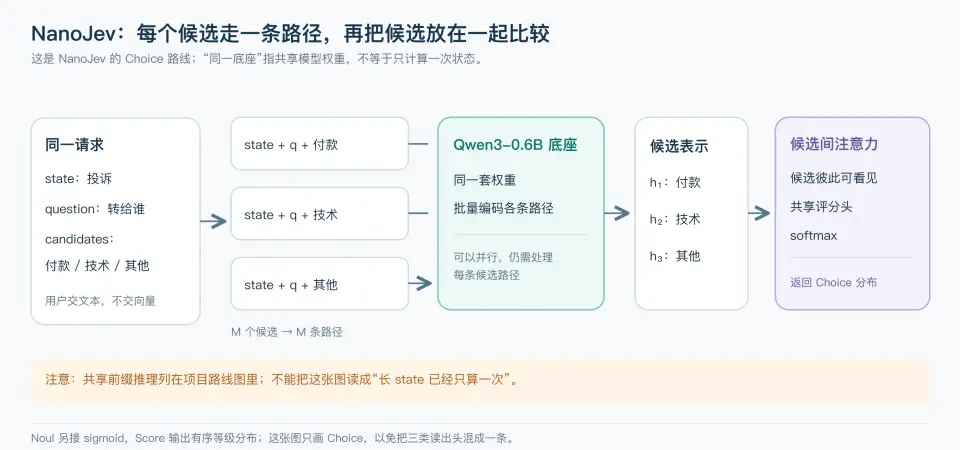
Trong phòng họp này, các nhóm số đại diện cho thí sinh (vector đặc trưng) sẽ được so sánh và cân nhắc lẫn nhau. Ban đầu tài chính và công nghệ đang rất khó phân biệt, đột nhiên có thêm một thẻ "thời tiết xấu" tham gia thảo luận, toàn bộ trọng tâm thảo luận của ban giám khảo và trọng số so sánh ngay lập tức bị xáo trộn và tái tổ chức.
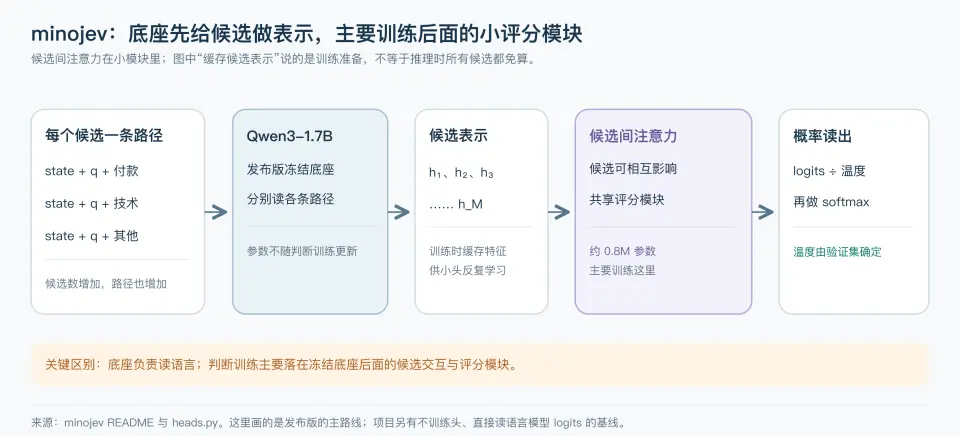
Sau cuộc họp nội bộ này, điểm số cuối cùng được đưa ra, tự nhiên sẽ không còn giống như lúc chỉ có hai người.
Tại sao Jev lại phải tốn công sức để khiến những tùy chọn này "kéo nhau xuống" trong mã nguồn? Điều này không chỉ đơn thuần là để thể hiện kỹ năng, mà còn vì trong các công việc phức tạp thực tế, câu trả lời đúng thường không phải là tuyệt đối, mà là "so sánh" ra. Tùy chọn bản thân thực sự là manh mối ẩn giấu để giải quyết vấn đề.
Ví dụ, hỏi tháp Eiffel ở đâu? Các tùy chọn có A. Châu Âu B. Pháp C. Paris. Khi mô hình thấy cả ba tùy chọn này cùng một lúc, những tùy chọn này bản thân đã trở thành manh mối ẩn giấu để giải mã ý định của câu hỏi này. Câu hỏi này không kiểm tra vị trí tổng quát, mà đang kiểm tra độ chính xác cao nhất của vị trí địa lý.
Điểm dừng thứ tư: Đưa ra kết quả
Bước cuối cùng của quy trình là giải ra một điểm số cụ thể.
Theo lời nói chính thức của TypeSafe, Jev sẽ trực tiếp trả về số xác suất, tuyệt đối không tạo ra văn bản từng chữ một.
Khám phá bên ngoài của Archer Hume cũng xác nhận điều này, khi anh đưa số tùy chọn từ hai tăng lên hai trăm, văn bản phản hồi từ API mặc dù trở nên rất dài, nhưng thời gian xử lý của máy chủ không kéo dài theo tỷ lệ.
Điều này cho thấy mô hình lớn thực sự đã bỏ qua bước tạo ra tự hồi quy tốn thời gian nhất (cũng chính là bước dự đoán từ tiếp theo như ChatGPT).
Vậy, số xác suất cuối cùng này thực sự được "lấy" từ đâu? Thực tế, có nhiều cách thực hiện kỹ thuật này, chủ yếu phụ thuộc vào phương pháp mà chúng sử dụng trong bước tính toán tùy chọn trước đó.
Cách làm của openjev/openjev không có xử lý đặc biệt cho tương tác tùy chọn là trực tiếp đọc điểm số gốc (Logits) của token chữ cái tùy chọn đã chỉ định trong "vị trí trả lời" mà mô hình đáng lẽ phải tạo ra chữ đầu tiên.
Kev với đầu chỉ dựa vào đầu chỉ có thể nhìn toàn cục để trực tiếp xuất điểm so sánh. Còn minojev với mô-đun chia sẻ thì dựa vào mô-đun chấm điểm chia sẻ nhân tạo để đưa ra kết quả.
Dù là cách nào để trích xuất, chỉ cần quy trình được thiết kế hợp lý, mô hình lớn hoàn toàn có thể bỏ qua việc tạo ra văn bản dài dòng, trực tiếp rút ra xác suất toán học chính xác ở cuối phép toán, hoàn thành một quyết định tự động cấp hệ thống.
Đến đây, chúng ta đã có thể rõ ràng dựa trên đánh giá và phục hồi, đưa ra mô hình kiến trúc của Jev.
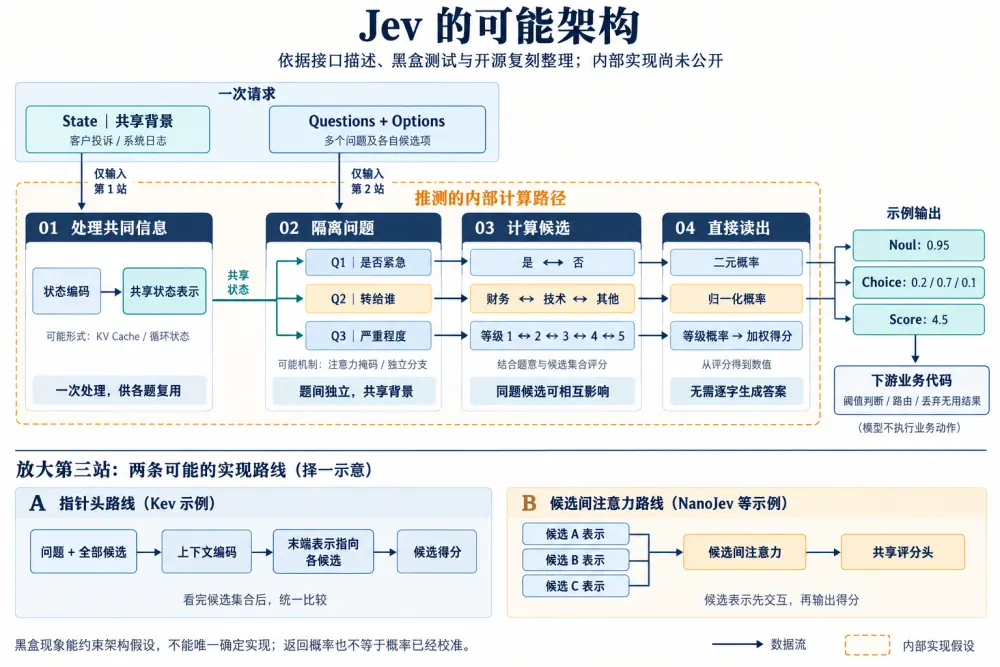
Kiến trúc này bản thân không phức tạp, cũng khó có phần nào được coi là đổi mới kiểu mẫu. Mặc dù thực sự là một tối ưu kỹ thuật xuất sắc cho một tình huống cụ thể, nhưng cũng chỉ có vậy mà thôi.
03
Đảm bảo độ chính xác là huấn luyện sau
Kiến trúc chỉ đảm bảo tốc độ, vậy Jev đạt được độ chính xác cao như thế nào?
Dựa vào phương pháp huấn luyện sau được TypeSafe gọi là RLCD (tăng cường học quyết định hiệu chỉnh). Vì RLCD là một hộp đen không công khai, chúng ta cũng chỉ có thể xem xét những nỗ lực từ cộng đồng mã nguồn mở để thấy được các câu hỏi và cách thực hiện thuật toán tiềm năng của nó.
Sự ra đời của một câu hỏi dùng để huấn luyện RLCD
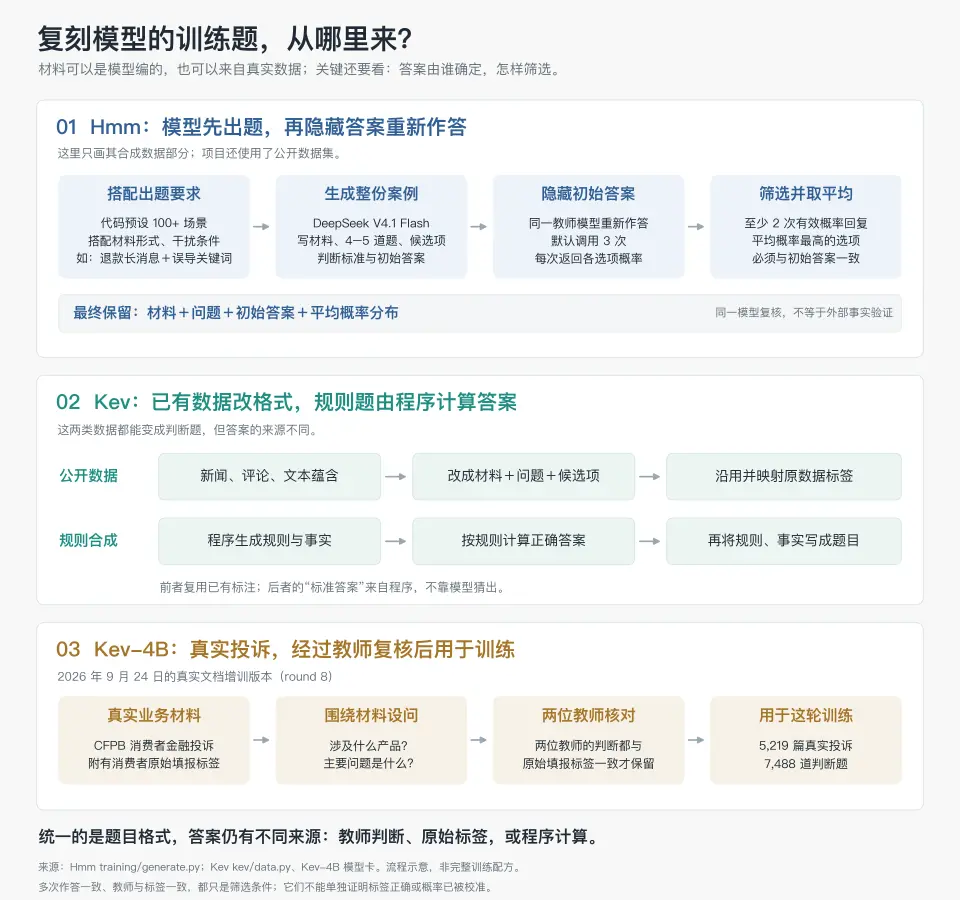
Cách đơn giản nhất là tổng hợp trực tiếp, chẳng hạn như cách mà phiên bản Hmm đã tái hiện.
Các nhà nghiên cứu đã yêu cầu DeepSeek V4.1 liệt kê hơn một trăm tình huống làm việc trong mã, bao gồm xử lý hoàn tiền, kiểm tra sự cố, tìm kiếm liên quan, phân luồng email, v.v.
Mỗi lần chọn một tình huống, sau đó kết hợp với hình thức tài liệu và yêu cầu đặt câu hỏi. Ví dụ:
Sử dụng một đoạn tin nhắn dài có chi tiết không liên quan, viết một vài nhóm trường hợp hoàn tiền.
Thêm một trường hợp dễ bị nhầm lẫn bởi từ khóa.
Mỗi trường hợp kèm theo bốn đến năm câu hỏi lựa chọn, đúng sai hoặc cấp độ.
DeepSeek V4.1 Flash sau đó tạo ra toàn bộ tài liệu, câu hỏi, tùy chọn, tiêu chí đánh giá và câu trả lời.
Sau đó, để kiểm tra xem câu hỏi này có thể sử dụng được hay không, chỉ cần ẩn câu trả lời gốc, yêu cầu DeepSeek V4.1 Flash trả lời lại, mặc định gọi ba lần, yêu cầu mỗi lần đưa ra xác suất tùy chọn. Mã cho phép chỉ những câu hỏi có ít nhất hai phản hồi hợp lệ mới có thể sử dụng.
Phương pháp của Kev là thống nhất các bộ dữ liệu hiện có như phân loại tin tức, cảm xúc bình luận, nội dung văn bản theo quy tắc chuyển đổi thành định dạng phán đoán "nguyên liệu + câu hỏi + câu trả lời ứng cử viên".
Mô hình sau đó sẽ tạo ra quy tắc và sự thật, tính toán câu trả lời, và viết chúng thành văn bản.
Vào ngày 24 tháng 9, Kev-4B đã thử nghiệm việc xây dựng câu hỏi trong môi trường làm việc thực tế. Họ đã thu thập 5,219 đơn khiếu nại tài chính của người tiêu dùng thực tế, và tạo ra câu hỏi xung quanh "sản phẩm liên quan là gì, vấn đề chính là gì". Sau khi câu hỏi được đưa ra, chỉ khi hai mô hình giáo viên khác nhau đều có phán đoán nhất quán với nhãn báo cáo ban đầu của người tiêu dùng thì nhãn mới được giữ lại.
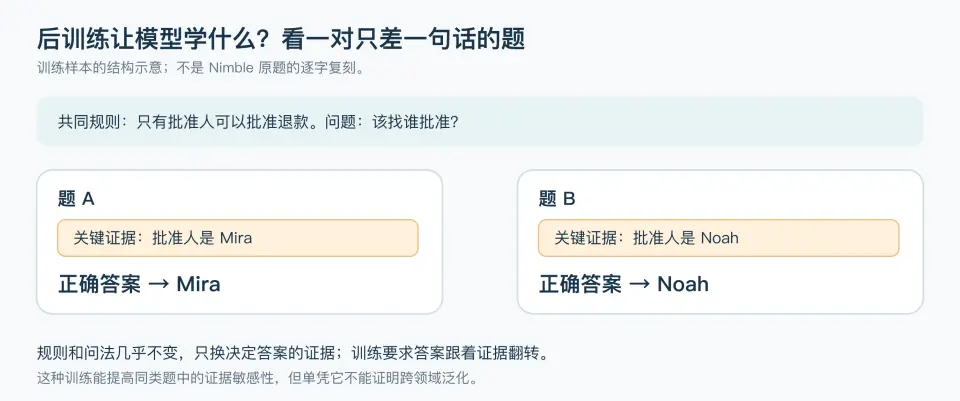
Để làm cho việc đào tạo này hiệu quả hơn, các bài kiểm tra phục hồi sẽ đặc biệt đưa ra một số câu hỏi bẫy theo cặp.
Ví dụ, hai câu hỏi có quy tắc hoàn toàn giống nhau, chỉ thay đổi một cái tên quan trọng (ví dụ, người ký từ Mira có quyền thành Noah không có quyền), câu trả lời sẽ đảo ngược ngay lập tức. Những câu hỏi như vậy có thể hiệu quả ngăn chặn mô hình học thuộc lòng câu trả lời thông qua Reward Hacking, buộc nó phải làm một cách nghiêm túc để hiểu sự biểu hiện và mối liên hệ sâu sắc giữa câu hỏi và các lựa chọn câu trả lời.
Phương pháp đào tạo, chỉ cần LoRA cộng với chưng cất là đủ sao?
Hiện tại, hầu hết tất cả các phương pháp đào tạo đã qua sử dụng đều sử dụng phương pháp "LoRA + chưng cất giáo viên" để tăng xác suất lựa chọn đúng.
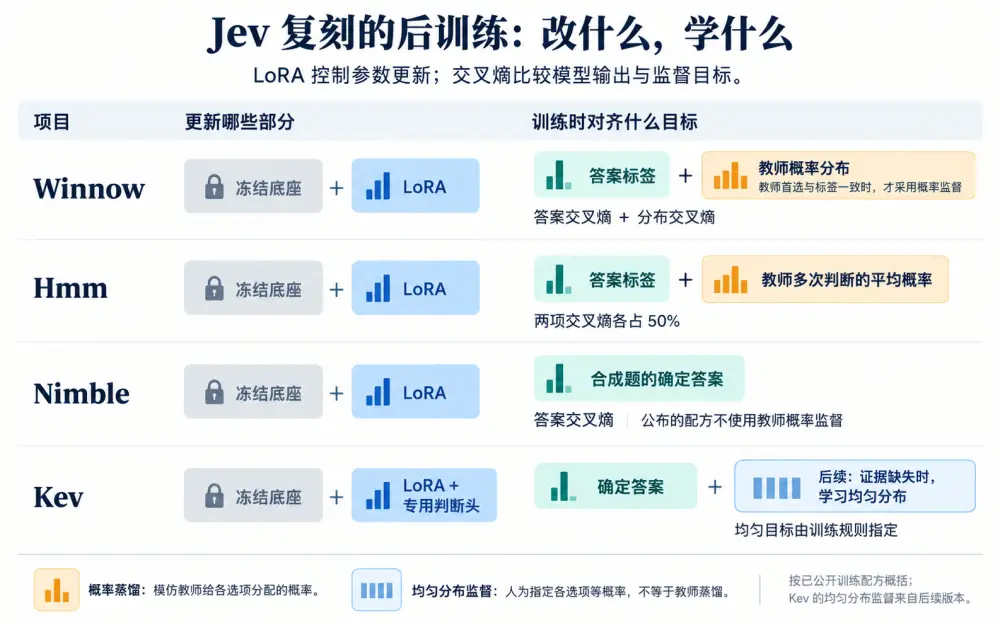
Lấy Winnow làm ví dụ, nó chọn thực hiện tinh chỉnh LoRA trên mô hình chỉ thị Gemma 4 12B. Chức năng của LoRA là giữ lại trọng số gốc, đào tạo một phần nhỏ tham gia vào việc tính toán các tham số điều chỉnh, giảm chi phí sửa đổi mô hình.
Winnow đồng thời sử dụng hai loại giám sát. Một loại đưa ra câu trả lời tiêu chuẩn, yêu cầu mô hình tăng xác suất của lựa chọn đúng. Loại còn lại cung cấp phân phối xác suất cho tất cả các lựa chọn từ giáo viên, để học sinh gần gũi với phân phối này. Chỉ khi vị trí đầu tiên do giáo viên chọn nhất quán với câu trả lời tiêu chuẩn, Winnow mới áp dụng giám sát thứ hai.
Cả hai đều tính toán sai số đào tạo thông qua entropy chéo. Entropy chéo ở đây đảm nhận công việc kiểm tra học sinh đã phân bổ xác suất sai bao nhiêu. Chỉ khi có câu trả lời tiêu chuẩn, xác suất của lựa chọn đúng càng thấp thì hình phạt càng lớn.
Khi sử dụng phân phối giáo viên, việc đào tạo sẽ thúc đẩy học sinh bắt chước phân phối của giáo viên đối với các lựa chọn. Ví dụ, giáo viên phân bổ 80%, 15%, 5% cho A, B, C, học sinh sẽ được yêu cầu học sự khác biệt giữa ba lựa chọn này.
Nói chung, LoRA, chưng cất và entropy chéo đã đủ cho các nhiệm vụ đã chuẩn bị sẵn câu hỏi, câu trả lời và phân phối tham khảo (như nhiệm vụ dự đoán xác suất này), vì chúng chỉ học một xác suất.
Nhưng chưng cất thực sự học xác suất của giáo viên, chứ không phải xác suất thực tế như RCLD đã nói. Cách mà khoảng cách chưng cất vượt qua sự phân bổ của sự thật / giáo viên, hiện tại không có hướng đi rõ ràng nào.
Về lý thuyết, để thực hiện tuyên bố của Jev, chỉ có thể dựa vào khối lượng dữ liệu lớn hơn và phương pháp học tập hiệu quả hơn.
Tất nhiên, nếu một mô hình phán đoán nhỏ như vậy có thể đạt được độ chính xác phán đoán của mô hình lớn, thì nếu không giải quyết được điều này, nó cũng rất hữu ích.
Hiệu chỉnh, có thể vẫn là tuyệt chiêu
Ngoài ra, Jev còn có một tuyệt chiêu, đó là khả năng hiệu chỉnh mà nó tuyên bố.
Số lượng câu hỏi mà mô hình trả lời đúng, và việc nó có chính xác thể hiện sự tự tin hay không, là hai vấn đề khác nhau. Một mô hình có thể chỉ trả lời đúng bảy phần trăm, nhưng lại luôn báo cáo sự tự tin là chín phần trăm.
Để xác minh xem Jev có đang tự tin mù quáng hay không, Archer Hume đã thực hiện một "thí nghiệm đo lường nói dối".
Ông đã cho Jev 1200 câu hỏi kiểm tra MMLU (Hiểu ngôn ngữ đa nhiệm quy mô lớn), sau đó phân loại tất cả các câu trả lời được chọn theo xác suất mà hệ thống báo cáo thành mười cấp độ. Qua các phép tính phức tạp, sai số hiệu chỉnh của Jev chỉ là 0.031.
Trong 30 câu nhân ba chữ số đơn giản, Jev trả lời đúng 86.7%, trong khi mức độ tự tin trung bình mà nó báo cáo là 83%, rất khớp nhau. Khi câu hỏi chuyển sang "câu hỏi ứng dụng hai bước" khó hơn, tỷ lệ chính xác của nó giảm mạnh xuống 32%, điều quan trọng là, mức độ tự tin trung bình mà nó báo cáo cũng giảm xuống 30%.
Đối với điều này, đào tạo sau thực sự có thể cải thiện hiệu suất xác suất, nhưng nhiều khi sẽ khiến mô hình trở nên tự tin mù quáng hơn.
Để phục hồi khả năng hiệu chỉnh chính xác của Jev, phiên bản sao chép đã sử dụng một số phương pháp. Ví dụ, Kev sẽ yêu cầu rõ ràng mô hình giảm độ chắc chắn khi thiếu bằng chứng. Nó đã thêm các mẫu trong bộ dữ liệu đào tạo mà bằng chứng quan trọng bị loại bỏ, và sau đó giảm xác suất của chúng trong câu trả lời, do đó mô hình sẽ bị phạt vì không có cơ sở mà tập trung xác suất vào một lựa chọn nào đó.
Tuy nhiên, nhiều bản sao chép chỉ thực hiện một loại hiệu chỉnh nhiệt độ không giải quyết tận gốc.
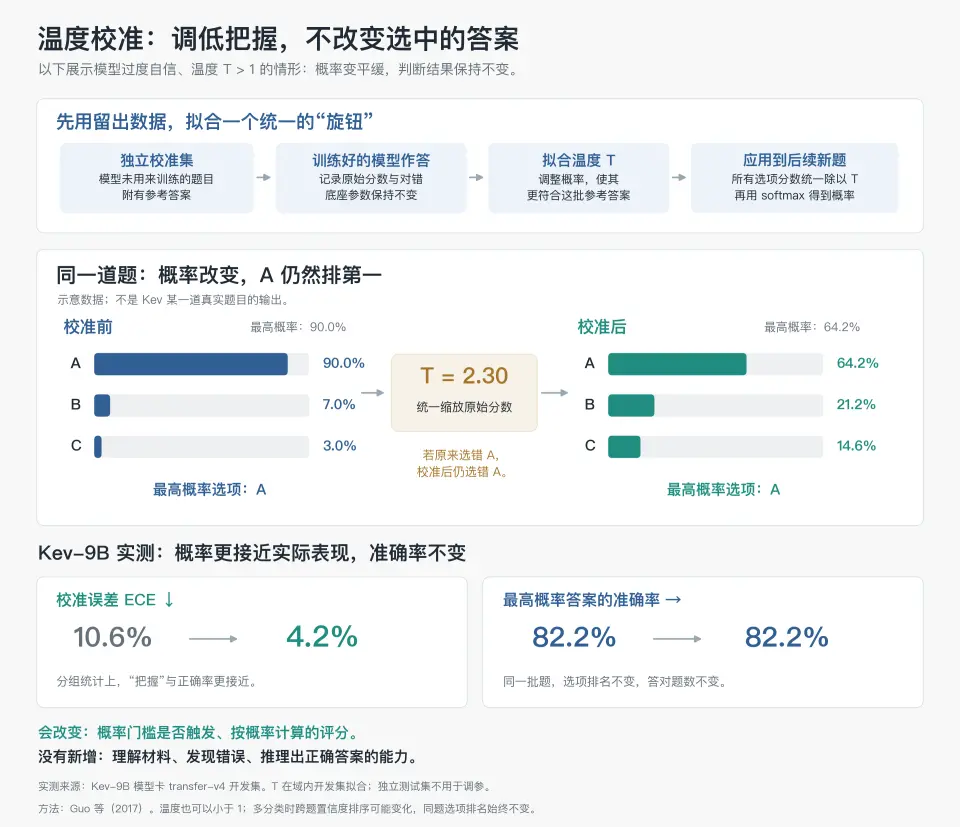
Kỹ sư sẽ đưa ra một nhóm nhỏ các câu hỏi kiểm tra mà mô hình chưa thấy để cho mô hình đã được đào tạo thực hiện. Nếu phát hiện mô hình quá tự tin, hệ thống sẽ tính toán mức độ tự tin tổng thể cần điều chỉnh lại bao nhiêu.
Khi núm điều chỉnh đã được thiết lập, mô hình sẽ bị buộc phải đeo một bộ lọc khiêm tốn khi xuất ra xác suất, trở thành một xác suất nhẹ nhàng hơn.
Điều này sẽ không thay đổi thứ hạng của các lựa chọn trong cùng một câu hỏi, do đó câu trả lời có xác suất cao nhất không thay đổi. Nhưng ngưỡng xác suất và điểm số tính toán theo xác suất có thể thay đổi.
Chiêu này vẫn khá hiệu quả. Ví dụ, sau khi Kev-9B thực hiện hiệu chỉnh nhiệt độ, sai số hiệu chỉnh đã giảm từ khoảng 10.6 điểm phần trăm xuống còn 4.2 điểm phần trăm, trong khi số câu trả lời đúng không thay đổi.
Nói rằng nó chỉ giải quyết tạm thời là vì điều này thực sự đến từ việc giảm độ tự tin tổng thể, chứ không phải từ việc phân biệt chính xác hơn xem mình có nên tự tin hay không.
Giả sử Jev thực sự đã cải thiện hiệu suất hiệu chỉnh, thì có thể họ thực sự có một số kỹ năng đặc biệt ở đây.
04
Ranh giới áp dụng của Jev thực sự lớn đến mức nào?
Jev chắc chắn có ý nghĩa ứng dụng thực tế. Nó đã phục hồi những nhiệm vụ mà trước đây chỉ cần quyết định nhanh chóng, trở về với quyết định nhanh chóng bản thân.
Trong toàn bộ quy trình của Agent, phân loại yêu cầu và định tuyến, sắp xếp kết quả tìm kiếm, có rất nhiều yêu cầu kiểm tra từng mục rõ ràng. Đây là những nơi Jev có thể phát huy tác dụng.
Ví dụ, phân luồng dịch vụ khách hàng, phân loại sản phẩm, phân tích phản hồi, gán nhãn dữ liệu, đều là những tình huống thường gặp trong các nhiệm vụ hàng ngày của chúng ta.
Nhưng ranh giới áp dụng của nó lớn đến mức nào, quyết định xem nó có phải là giá trị mẫu mà nó tuyên bố hay không.
Từ các Benchmark hiện tại, nó thực sự có một mức độ tổng quát nhất định. Nhóm Nimble đã sử dụng 13 nhóm, tổng cộng 3,880 dữ liệu công khai để đo lường các nhiệm vụ kiểm tra sự thật, định tuyến ý định, nội dung ngữ nghĩa, kiểm duyệt nội dung, hỏi đáp y tế, Jev có độ chính xác trung bình theo tập dữ liệu là 76.0%.
Điều này cho thấy Jev thực sự có khả năng đảm nhận nhiều công việc phán đoán khác nhau.
Nhưng sự tổng quát thực sự còn hai rào cản.
Rào cản đầu tiên là nhiệm vụ khó khăn, nếu chỉ có thể thực hiện phán đoán đơn giản, thì phạm vi áp dụng của nó sẽ rất hạn chế.
Trước tiên, chúng ta cần định nghĩa điều gì là khó khăn trong phán đoán. Nói chung, chúng ta cho rằng, những vấn đề có nhiều bước, nhiều điều kiện, yêu cầu hiểu biết chi tiết sẽ khó khăn hơn.
Nhận diện "người dùng muốn hoàn tiền" chỉ cần hiểu nghĩa đen, nhưng phán đoán "liệu khoản hoàn tiền này có nên được phê duyệt hay không" lại cần kiểm tra ngày tháng, tính toán thời hạn, so sánh quyền ưu tiên của các điều khoản, rõ ràng khó hơn. Và nếu một phán đoán cần lý luận ba bước để đến kết quả, thì bước thứ ba cần kết quả của bước thứ hai, đó là sự phụ thuộc nhiều bước. Nếu tìm sai chính sách ở bước đầu tiên, thì các phép tính sau đó dù hoàn toàn chính xác, cuối cùng cũng sẽ phán đoán sai.
Trong bài kiểm tra câu hỏi khó của JevBench, JevBench đã quy định một số yếu tố liên quan đến độ khó của câu hỏi phán đoán, bao gồm phán đoán nhiều điều kiện, tìm kiếm chứng cứ liên tục, so sánh ngày tháng và ba lựa chọn số. Trong nhóm câu hỏi này, tỷ lệ chính xác của Jev trong việc tìm kiếm nhiều bước là 85.7%, phán đoán chính sách dài là 60.5%, phán đoán thời gian và số chỉ đạt 26.7%, đều kém xa so với mô hình cấp Flash. Tổng cộng các câu hỏi khó, Jev trả lời đúng 74.1%, DeepSeek V4.1 Flash đạt 95.0%, gần tương đương với trình độ của các chuyên gia con người.
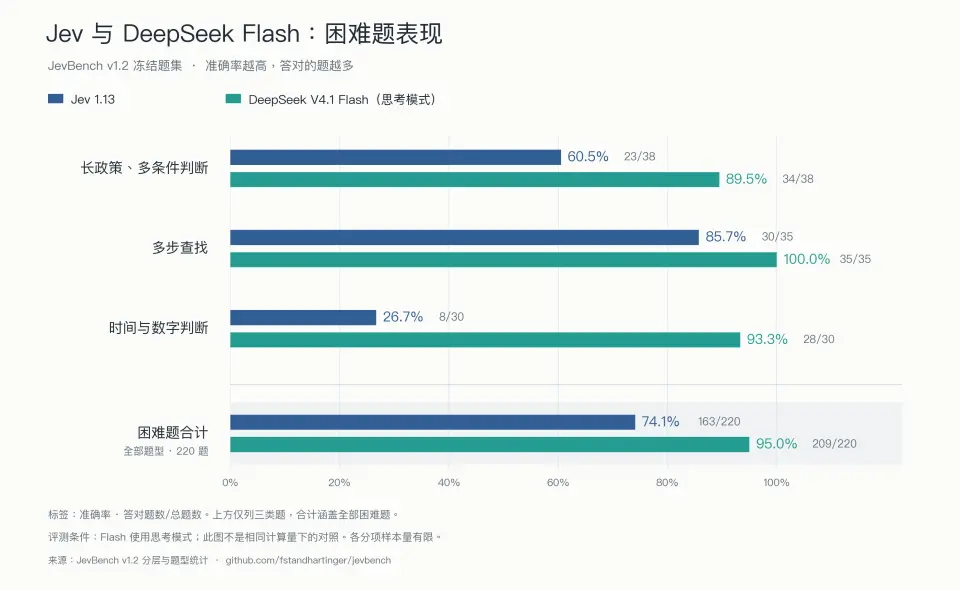
Mặc dù thời gian trung bình cho các yêu cầu kiểm tra tương ứng khoảng 0.67 giây và 3.15 giây, tốc độ của Jev nhanh hơn gần bốn lần. Nhưng sự chênh lệch độ chính xác lớn như vậy, đối với một số phán đoán phải đối mặt với nhiệm vụ phức tạp (như việc đầu tư chứng khoán mà mọi người đều mong muốn) thì việc lựa chọn gì gần như không cần bàn cãi.
Hơn nữa, độ chính xác của việc tìm kiếm nhiều bước ở đây không phải là lý luận nhiều bước, mà chủ yếu liên quan đến việc tìm kiếm. Trong bài kiểm tra của Archer Hume, Jev có tỷ lệ chính xác cao tới 86.7% trong phép nhân đơn giản, nhưng khi chuyển sang câu hỏi ứng dụng hai bước, tỷ lệ chính xác của nó ngay lập tức giảm xuống 32%.
Briantrust đã thực hiện một đánh giá chi tiết hơn, cũng cho thấy Jev gặp khó khăn trong các vấn đề khó khăn. Nó đã so sánh Jev với mô hình GPT 5.6 Luna, yêu cầu mô hình chọn ra một câu trả lời đúng từ hai câu trả lời ứng cử viên, cuối cùng so sánh 616 cặp câu hỏi hợp lệ. Hai mô hình chỉ chênh lệch 1.6 điểm phần trăm trong các câu hỏi kiến thức, nhưng trong toán học và lý luận, chênh lệch lên tới 19.3 điểm phần trăm, và trong mã đạt 20 điểm phần trăm.
Vì vậy, rào cản phán đoán khó khăn này, Jev khó có thể nói rằng mình đã vượt qua.
Rào cản thứ hai là khả năng tổng quát.
Nếu Jev thực sự có thể tổng quát, nó nên có khả năng tổng quát tốt hơn, nâng cao độ chính xác của phán đoán các vấn đề khác từ những gì nó đã học.
Nếu không, nó chỉ là một "mô hình phán đoán chuyên dụng" có phạm vi áp dụng hơi rộng hơn một chút, không có gì khác biệt so với các mô hình phán đoán trước đó.
Các bằng chứng từ nhiều bài kiểm tra trực tiếp hiện có có thể chứng minh Jev thực sự có một mức độ khả năng tổng quát nhất định, nhưng khả năng này trong lĩnh vực rất không ổn định. Và một khi bước ra khỏi bối cảnh quen thuộc, hiệu suất của nó vẫn phải đối mặt với rủi ro lớn.
Đầu tiên, trong cùng một nhiệm vụ và sự thật hoàn toàn giống nhau, phán đoán của Jev rất dễ bị ảnh hưởng bởi cách trình bày thông tin. Thí nghiệm OpenProse cho thấy, khi không thay đổi bất kỳ sự thật, câu hỏi và khối lượng tính toán nào, nếu mối quan hệ quan trọng được tập trung ở vị trí đầu của văn bản, tỷ lệ chính xác của Jev là 80.5%, nhưng khi những mối quan hệ này được chuyển đến giữa, tỷ lệ chính xác giảm mạnh xuống 40.9%.
Điều này cho thấy, ngay cả khi không thay đổi lĩnh vực kinh doanh, tính ổn định của sự biểu hiện của Jev cũng rất thiếu. Khả năng phán đoán của nó phụ thuộc rất nhiều vào cách mà các chương trình bên ngoài cung cấp dữ liệu cho nó.
Thứ hai, khi đối mặt với các câu hỏi mới trong cùng một hệ thống đánh giá, hiệu suất của Jev cũng có sự biến động rõ rệt. Phiên bản mới của JevBench v1.4 đã thêm 308 câu hỏi khó đóng, tỷ lệ chính xác của Jev giảm từ 86.6% trong các câu hỏi công khai xuống còn 36.7%, trong khi đó, DeepSeek V4.1 Flash sử dụng mô hình tư duy duy trì ở mức 94.8%.
Những điểm số cao mà Jev đạt được trong các câu hỏi công khai trước đây không thể tự động kéo dài vào các bài kiểm tra phức tạp chưa biết.
Khi thử nghiệm được đẩy mạnh vào việc chuyển giao kinh doanh thực tế, hiệu suất của Jev cũng có những điểm tích cực và tiêu cực. Ví dụ tích cực đến từ việc phát hiện tiêm ngừa từ Agent Journal, Jev có độ chính xác là 83.65% trên tập dữ liệu thử nghiệm ban đầu, khi chuyển trực tiếp sang một tập thử nghiệm khác chứa hơn hai nghìn dữ liệu bên ngoài, độ chính xác thậm chí đã tăng lên 95.58%, vượt xa mô hình cơ sở truyền thống.
Điều này cho thấy trong một số nhiệm vụ cụ thể, nó thực sự có thể thích ứng với sự thay đổi của nguồn dữ liệu.
Nhưng trong các doanh nghiệp có logic phức tạp hơn, sự tổng quát này thường không hiệu quả. Scarif Labs đã sử dụng nó để xác định xem cập nhật phần mềm có an toàn hay không. Khi chuyển mô hình từ một hệ sinh thái phần mềm sang một hệ sinh thái khác, khả năng phân biệt giữa cập nhật an toàn và nguy hiểm của Jev (AUROC) đã giảm từ 0.851 xuống 0.605 (gần với việc đoán ngẫu nhiên là 0.5).
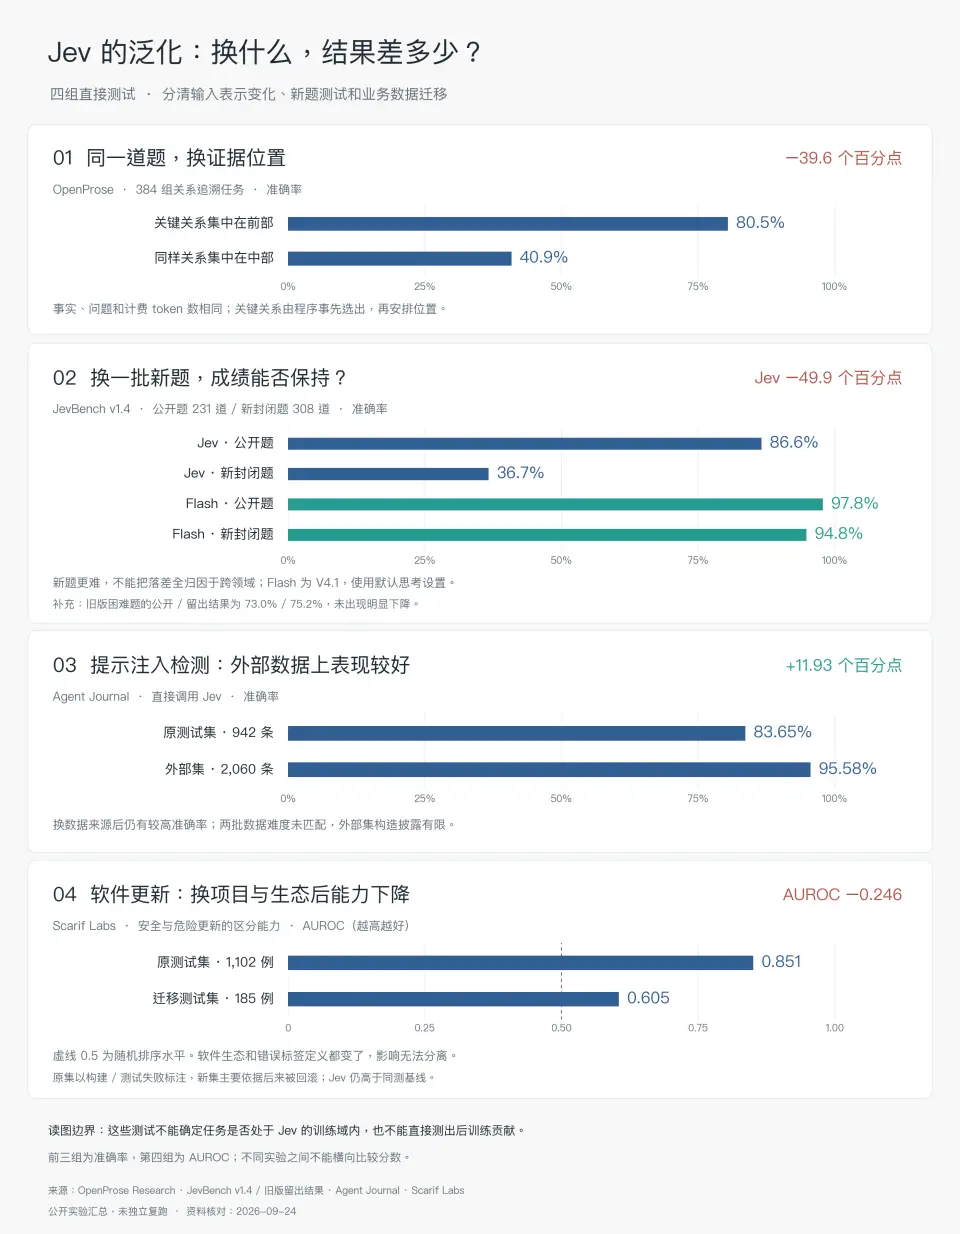
Do đó, ít nhất chúng ta có thể nói rằng, hiện tại sự tổng quát của Jev nên được coi là khá hạn chế và đáng nghi ngờ. Nó còn xa mới đạt tiêu chuẩn tổng quát chung.
Vì Jev chưa vượt qua được hai rào cản của sự tổng quát chung, chúng ta nên sử dụng nó ở đâu bây giờ?
Vị trí phù hợp hơn là đặt Jev vào các giai đoạn có tiêu chuẩn rõ ràng, bằng chứng tập trung, và kết quả phán đoán có thể được kiểm tra hoặc sửa chữa.
Vẫn lấy ví dụ về hoàn tiền. Việc xác định người dùng có bày tỏ ý định hoàn tiền hay không, khiếu nại liên quan đến logistics hay chất lượng sản phẩm, có cần bổ sung chứng từ hay không, đều là những phán đoán ngữ nghĩa có thể xác minh riêng lẻ. Những câu hỏi này xuất hiện thường xuyên, thường không cần tạo ra một đoạn giải thích, cũng không cần mỗi lần đều để mô hình chính thực hiện suy luận. Jev có thể đảm nhận việc phân luồng ban đầu ở đây.
Nhưng để phê duyệt hoàn tiền, mọi chuyện lại khác. Có vượt quá thời hạn hay không, cần kiểm tra mã ngày tháng, số tiền hoàn, cần tính toán theo quy tắc, gặp phải xung đột điều khoản hoặc tình huống ngoại lệ, còn cần xem xét thêm. TypeSafe cũng khuyên rằng, nên giao các phép toán và so sánh ngày tháng cho mã, và cố gắng giảm thiểu sự phụ thuộc nhiều tầng trong phán đoán.
Cách phân công như vậy mới có thể tận dụng tốc độ của nó ở vị trí phù hợp.
Còn đối với những ứng dụng phụ thuộc nhiều vào độ chính xác, chẳng hạn như mô hình thưởng, việc cần xác định thường chính là những câu trả lời có vẻ hợp lý nhưng thực tế lại sai. Mô hình còn cần phân biệt những khác biệt tinh tế, chống lại sự can thiệp của phong cách diễn đạt.
Còn đối với những nhiệm vụ mà quy định khó khăn, chẳng hạn như các quy tắc chứa đánh giá chủ quan, ít nhất cần thử nghiệm độ chính xác của Jev trước khi triển khai.
Lúc này, Jev có thể là một phương án ứng cử, nhưng người sử dụng vẫn cần đánh giá chuyên biệt cho nhiệm vụ.
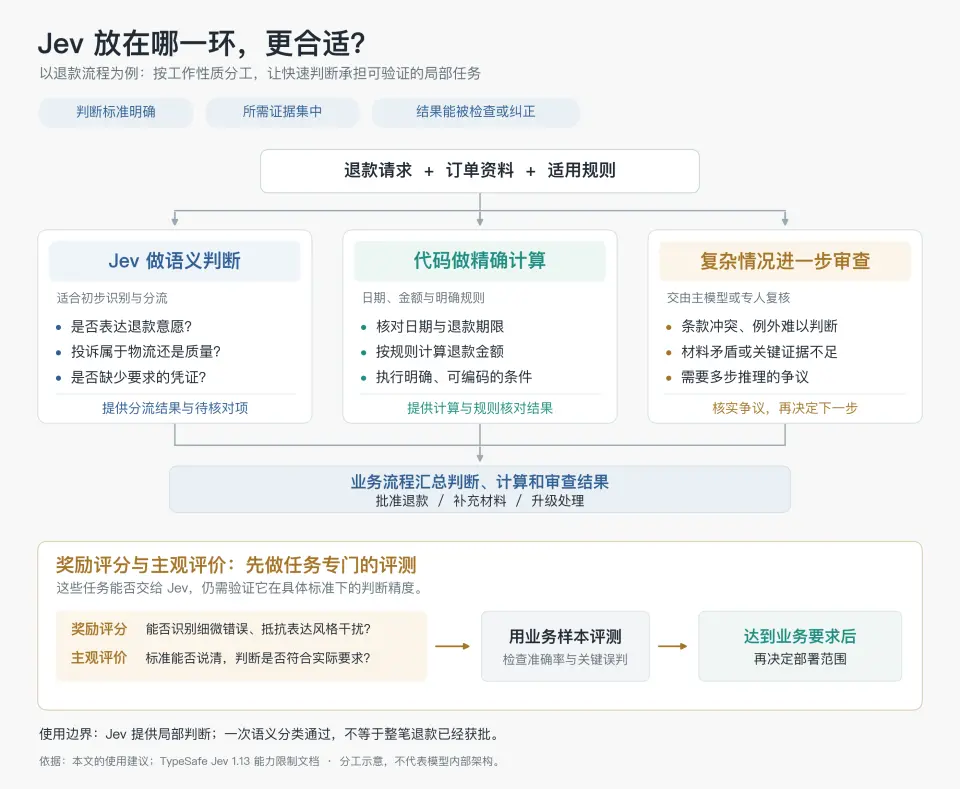
Ngoài ra, còn một điều không thể bỏ qua. Jev phản hồi nhanh không có nghĩa là khi thêm nó vào, toàn bộ Agent sẽ nhanh hơn.
Nếu nó có thể xử lý trước một loạt yêu cầu đơn giản, khiến những yêu cầu này không còn gọi đến mô hình chính, thì lợi thế về tốc độ và chi phí có cơ hội được hiện thực hóa.
Nhưng nếu mỗi lần đều gọi Jev trước, sau đó vẫn phải gọi cùng một mô hình chính, thì những phán đoán mới phải tiết kiệm đủ nhiều công việc tiếp theo để bù đắp cho thời gian và chi phí của nó.
Trong một loạt thí nghiệm truy xuất trí nhớ Agent trên GitHub, hệ thống đã đưa Jev vào để xác định xem thông tin truy xuất có hữu ích hay không. Để tránh việc Jev sai lầm loại bỏ thông tin hữu ích, các nhà phát triển buộc phải điều chỉnh tiêu chuẩn phán đoán nhiều lần.
Mặc dù cuối cùng đã cho phép 20 trường hợp thông thường thông qua, nhưng chi phí rõ ràng, độ trễ tổng thể của hệ thống đã tăng từ 649 mili giây lên 1087 mili giây, chi phí cho mỗi nghìn lần gọi cũng tăng gấp đôi.
Nếu mô hình chính đã có khả năng lọc câu trả lời từ tài liệu phức tạp, thì việc thêm một Jev như một bộ phận phán đoán không chỉ làm tăng thời gian chờ đợi mà còn mang theo rủi ro bỏ sót chứng cứ quan trọng do phán đoán sai.
05
Sự đột phá của Jev thực sự đến mức nào?
Cuộc thảo luận cuối cùng để lại cho chúng ta câu hỏi cốt lõi, Jev thực sự đang học cái gì?
Theo lý thuyết, một mô hình dùng để phán đoán, biểu diễn mà nó học được chính là thông qua các sự kiện mới để đưa ra phán đoán hiệu quả.
Đây gần như là một trong những biểu diễn khó nhất.
Phán đoán tổng quát cần phải gọi đồng thời nhiều khả năng, không thể chỉ vì cuối cùng chỉ xuất ra một xác suất mà cho rằng nó dễ hơn việc tạo ra câu trả lời.
Lấy ví dụ về hoàn tiền. Khi thấy "Tôi muốn hoàn tiền", việc nhận diện ý định hoàn tiền chủ yếu phụ thuộc vào hiểu ngôn ngữ. Nhưng khi hỏi "Theo chính sách này, có nên phê duyệt hoàn tiền không", mô hình phải hiểu chính sách, đối chiếu ngày mua, trạng thái sản phẩm với các điều khoản cụ thể, rồi xử lý các trường hợp ngoại lệ.
Điều này cơ bản là nền tảng khả năng của mô hình ngôn ngữ đứng sau Jev.
Câu hỏi cuối cùng "Liệu việc hoàn tiền có giúp giữ chân khách hàng này không", cần dự đoán hậu quả hành vi. Đây mới là phần mà mô hình cần được đào tạo.
Nó cần học những sự kiện nào ảnh hưởng đến kết quả, trong điều kiện nào ảnh hưởng, và liệu những mối quan hệ này có vẫn tồn tại khi chuyển sang một bối cảnh khác hay không.
Cả ba câu hỏi đều có thể xuất ra "xác suất có", nhưng kiến thức và tính toán cần thiết lại khác nhau.
Để vượt qua khoảng cách từ "dự đoán người khác sẽ phán đoán" đến "dự đoán đáng tin cậy hậu quả hành động", chúng ta thực sự cần bao nhiêu dữ liệu và đào tạo?
Ít nhất đối với con người, phán đoán tổng hợp là điều khó học nhất. Nó phức tạp như những tính toán lợi ích tổng hợp mà chúng ta đã đề cập trong bài viết trước.
Do đó, tôi rất nghi ngờ liệu phương pháp học mà bài viết này hiện tiết lộ có thể chịu đựng được những biểu diễn phức tạp như vậy hay không.
Tất nhiên, chúng ta có thể coi Jev như một công cụ kỹ thuật rất thông minh.
Trong các quy trình kinh doanh có quy tắc rõ ràng và tài liệu đầy đủ, nó có thể giảm đáng kể thời gian chờ đợi và chi phí tính toán, giá trị là không thể phủ nhận.
Nhưng trước khi chứng minh rằng nó thực sự đã học được một số quy tắc phán đoán tổng quát, việc để nó đội vương miện "cải cách mô hình" vẫn còn quá sớm.
 Cảnh báo rủi ro