一文字も書けないJevが、なぜChatGPTの後で最も人気のあるモデルになったのか?
 核心的な視点

 TypeSafe AI が発表した Jev は、テキスト生成能力を持たないセマンティックデシジョンモデルで、高頻度の決定的判断を行い、強い型の選択肢と信頼度を出力します。速度は約200倍、コストは約400倍低くなります。
この数日間、完全に話題になっているJevは、全く会話ができず、コードも書けないが、多くのAIの意思決定コストを400倍に削減できる全く新しいモデルです。
しかし、多くの人々はJevについてまだよく理解していません。
私は詳細に調査しましたので、この記事があなたにJevを完全に理解させる助けになることを願っています。ちょうど今日、Jevは全員が利用可能になったので、実際に操作してみてください。
文字版を見たくない方のために、GLM-5.3 flashを使って5分間の解説動画を作成しました。効果はなかなか良いので、直接動画を見てください。
無駄話はこれくらいにして、本文に入ります。
Jevにはテキスト生成能力は全くありません。
しかし、リリース以来、それが引き起こした議論の熱は、ChatGPT以来の最高のものです。
過去2年間、皆はすべての要求を汎用大モデルに投げることに慣れてきました。
しかし、現実のビジネスでは、ソフトウェアシステムが毎日直面する大量のリクエストには、長文を作成する必要は全くありません。
システムが本当に必要としているのは、しばしば極小の確定的な判断です:
この工事依頼は緊急ですか?
この指示はどの下流モデルに配信すべきですか?
ユーザーが入力した端末コマンドにはデータ削除のリスクがありますか?
最近検索されたこの知識は本当にユーザーの質問に答えられますか?
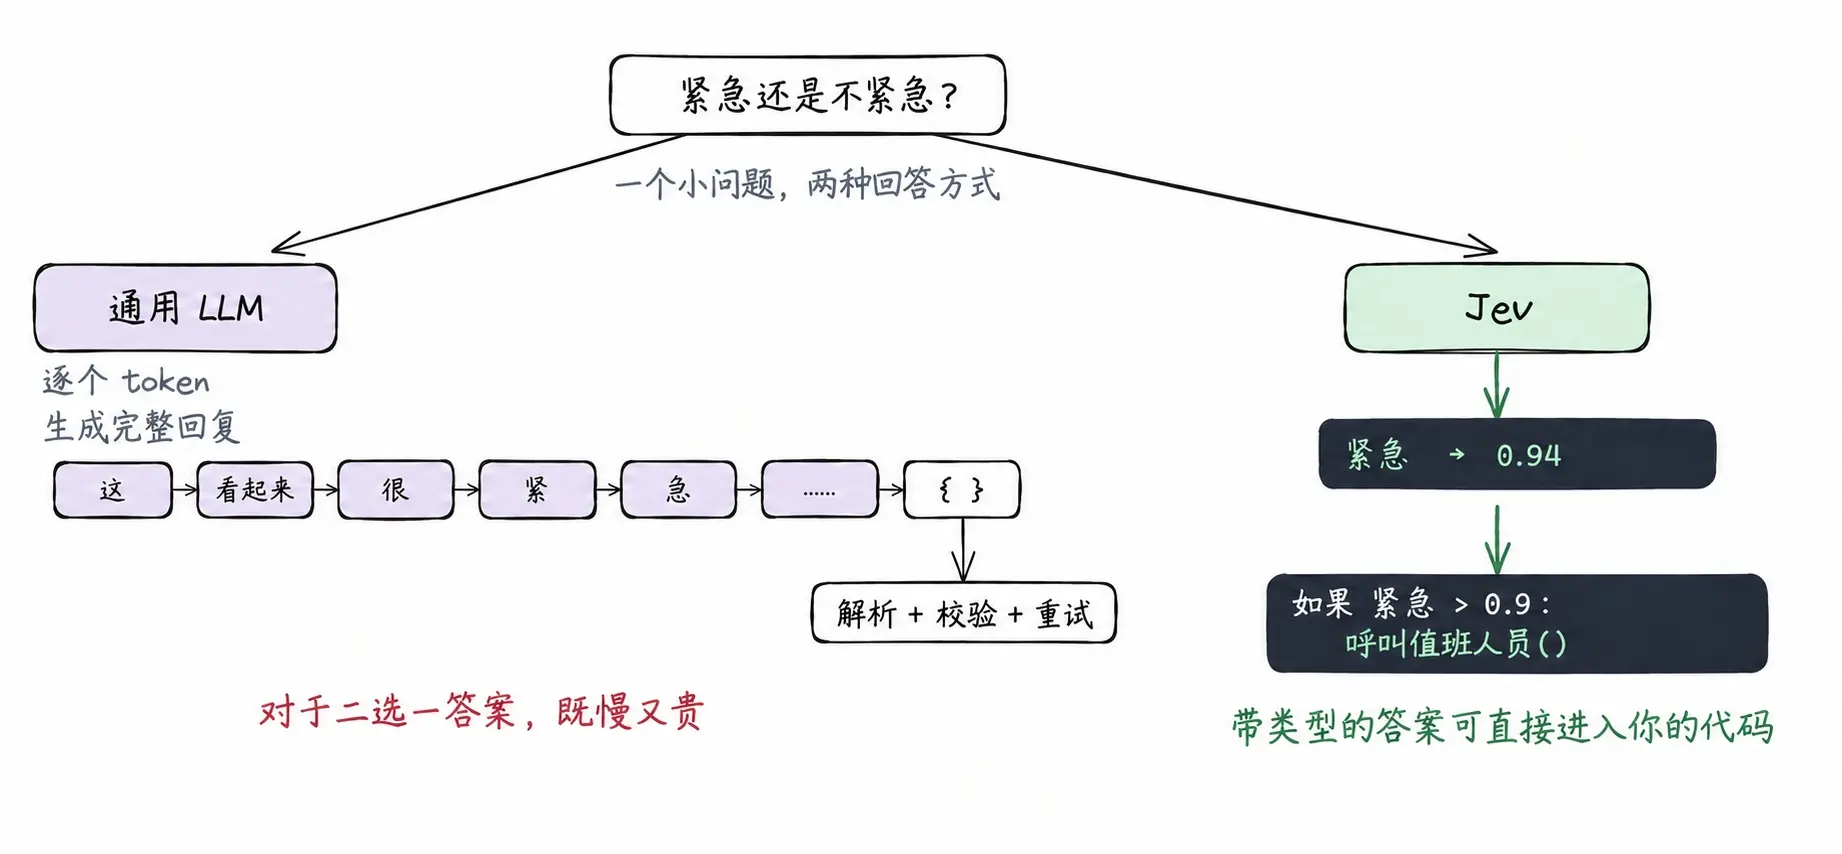
以前はこれらの判断を行うために、開発者は大モデルに逐語的に回答を生成させ、その後コードを使ってJSONを解析し、フォーマットエラーが発生した場合は再試行しなければなりませんでした。
これは遅く、しかも高額です。
TypeSafe AIが提供するJevは、まさにこの一連の意思決定ニーズを解決するために設計されています。
彼らはJevを「システム1(System One)モデル」と呼んでいます:非構造化データを入力すると、強い型のオプションと正確な信頼度を直接出力します。
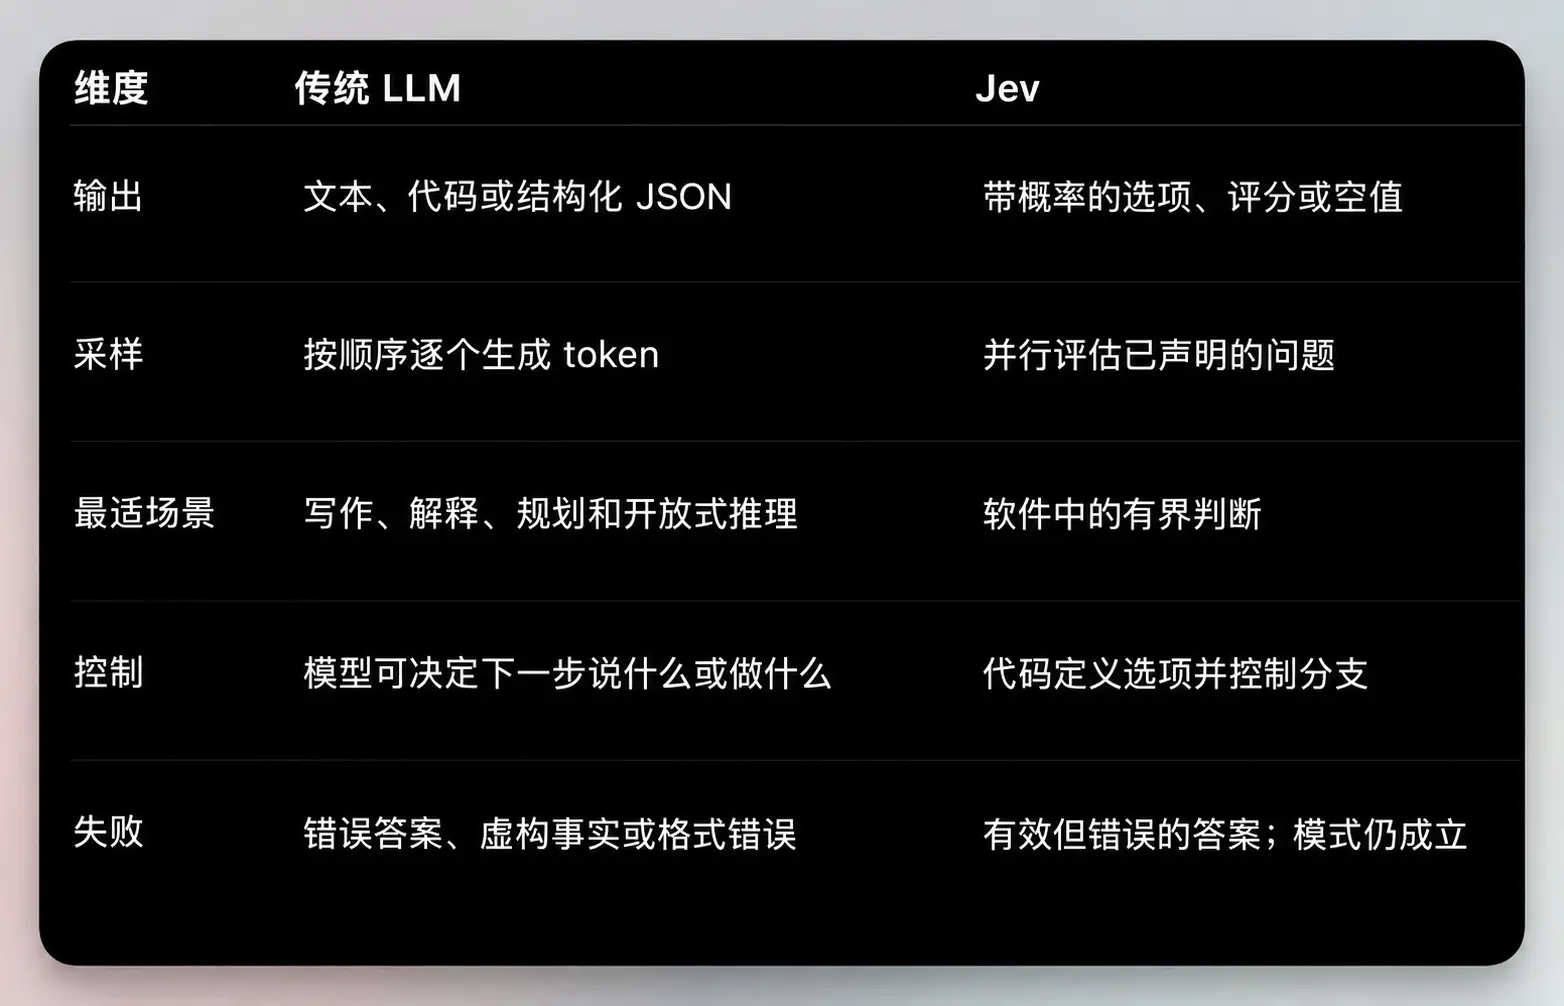
伝統的な大モデルによる判断が重すぎる理由は?
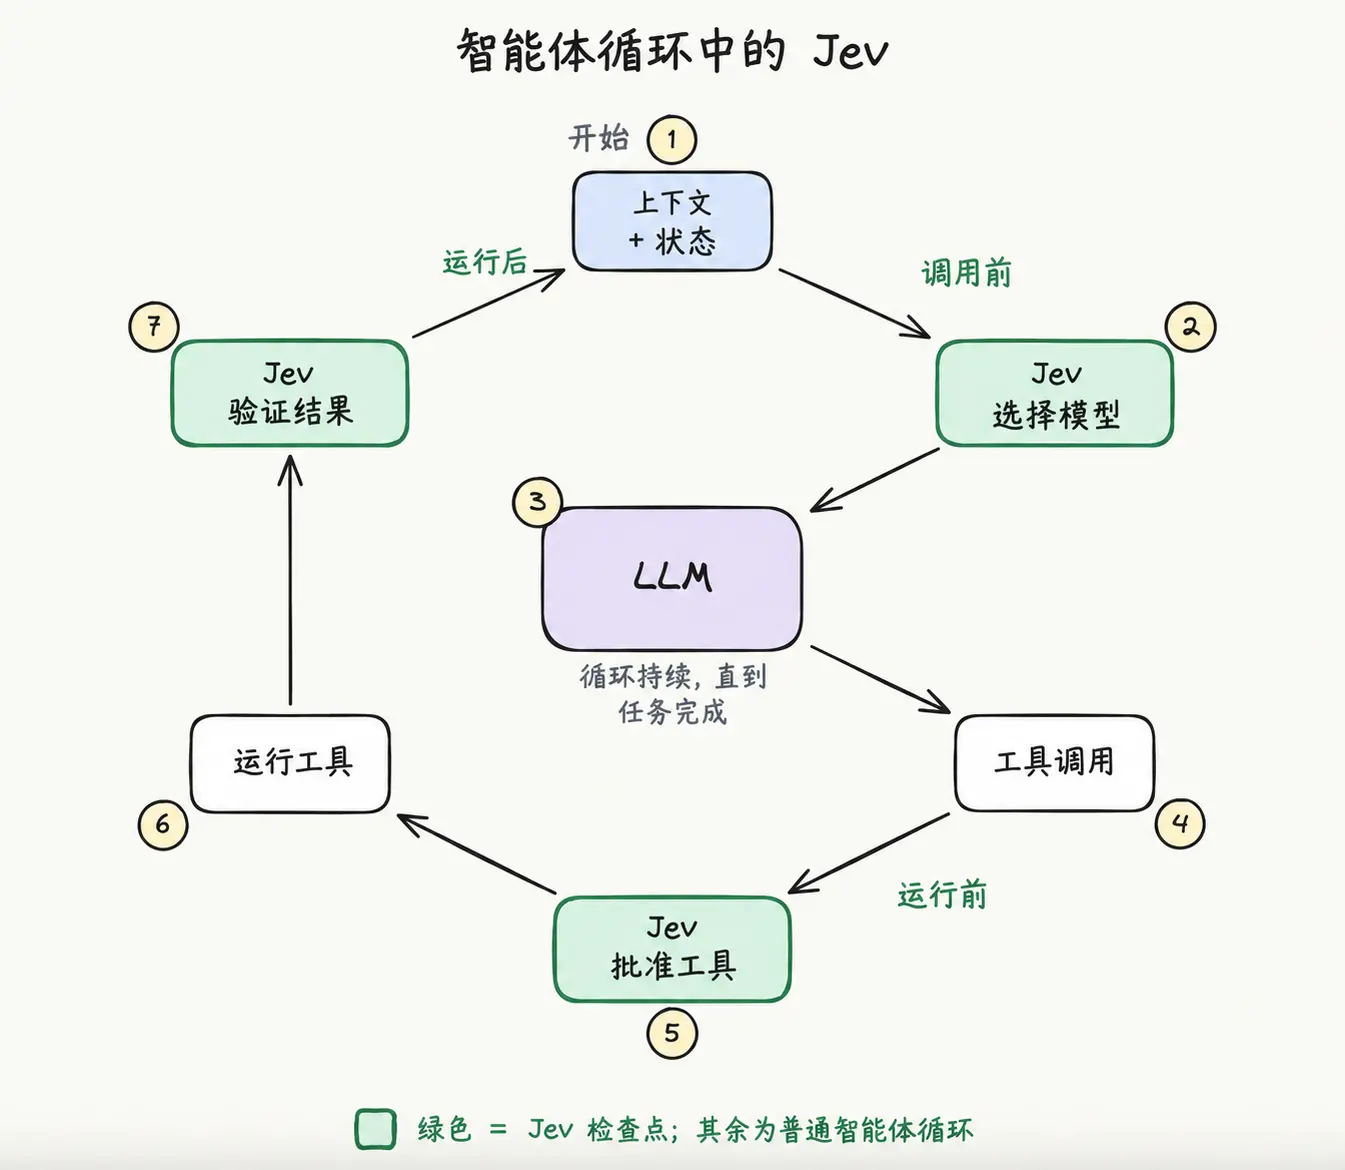
典型的なエージェント(Agent)ループでは、システムは一歩進むごとに意思決定を行う必要があります:
python
while not done:
    action = llm(context)
    result = run_tool(action)
    context += result
このループの中で、モデルはツールを選択し、実行結果を確認し、リスクがあるか判断し、タスクが完了したかどうかを決定します。
最終的な決定が「finance」という単語だけであっても、従来の生成モデルはトークンを一つずつ吐き出します。
入力に対して支払いをしなければならず、生成を待つ必要もあります。
Jevのコアロジックは非常に直接的です:
コードがすべての可能な答えを知っている場合、逐語的なテキスト生成は巨大なリソースの浪費です。
Jevは一体どう機能するのか?
Jevの本質は意味的意思決定エンジンです。
Jevを呼び出すとき、あなたは2つのものを提供する必要があります:
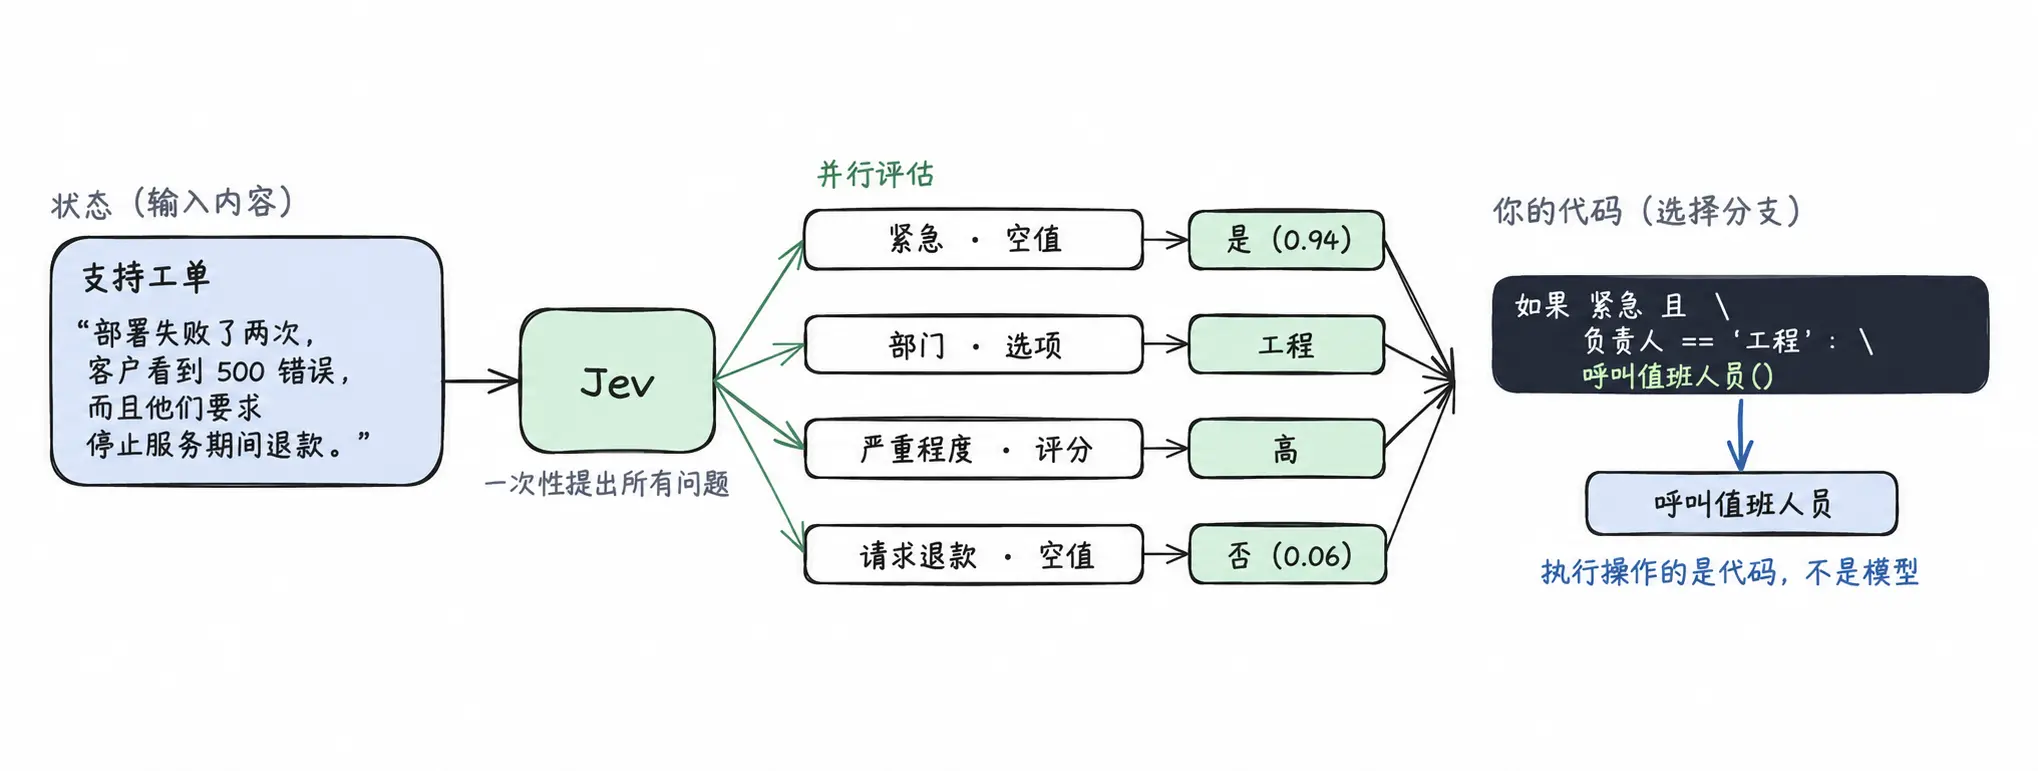
State(状態) :現在の状況を説明するテキストまたはJSON。
Questions(質問) :この状態に基づいてJevに行わせたい意思決定。
各質問は提出前に出力タイプを固定する必要があります。Jevは3つの基本データタイプをネイティブにサポートしています:
Choice :定義したリストから1つのオプションを選択し、すべてのオプションの確率分布を返します。
Score :入力を定義した順序付けられたランクにマッピングします。例えば、低、中、高。
Noul :ブール判断で、その命題が真である確率値(0から1の間の小数)を返します。
典型的なリクエストは次のようになります:
json
{
  "model": "jev-latest",
  "state": "デプロイが2回失敗し、ユーザー側で大量の500エラーが発生しています。",
  "questions": {
    "urgent": {
      "type": "noul",
      "instructions": "この問題はすぐに対処する必要がありますか?"
    },
    "owner": {
      "type": "choice",
      "instructions": "この問題はどのチームに割り当てるべきですか?",
      "criteria": {
        "engineering": "製品の故障とサービスのダウン",
        "billing": "請求、請求書、返金の問題",
        "sales": "価格相談と新規顧客の開設"
      }
    }
  }
}
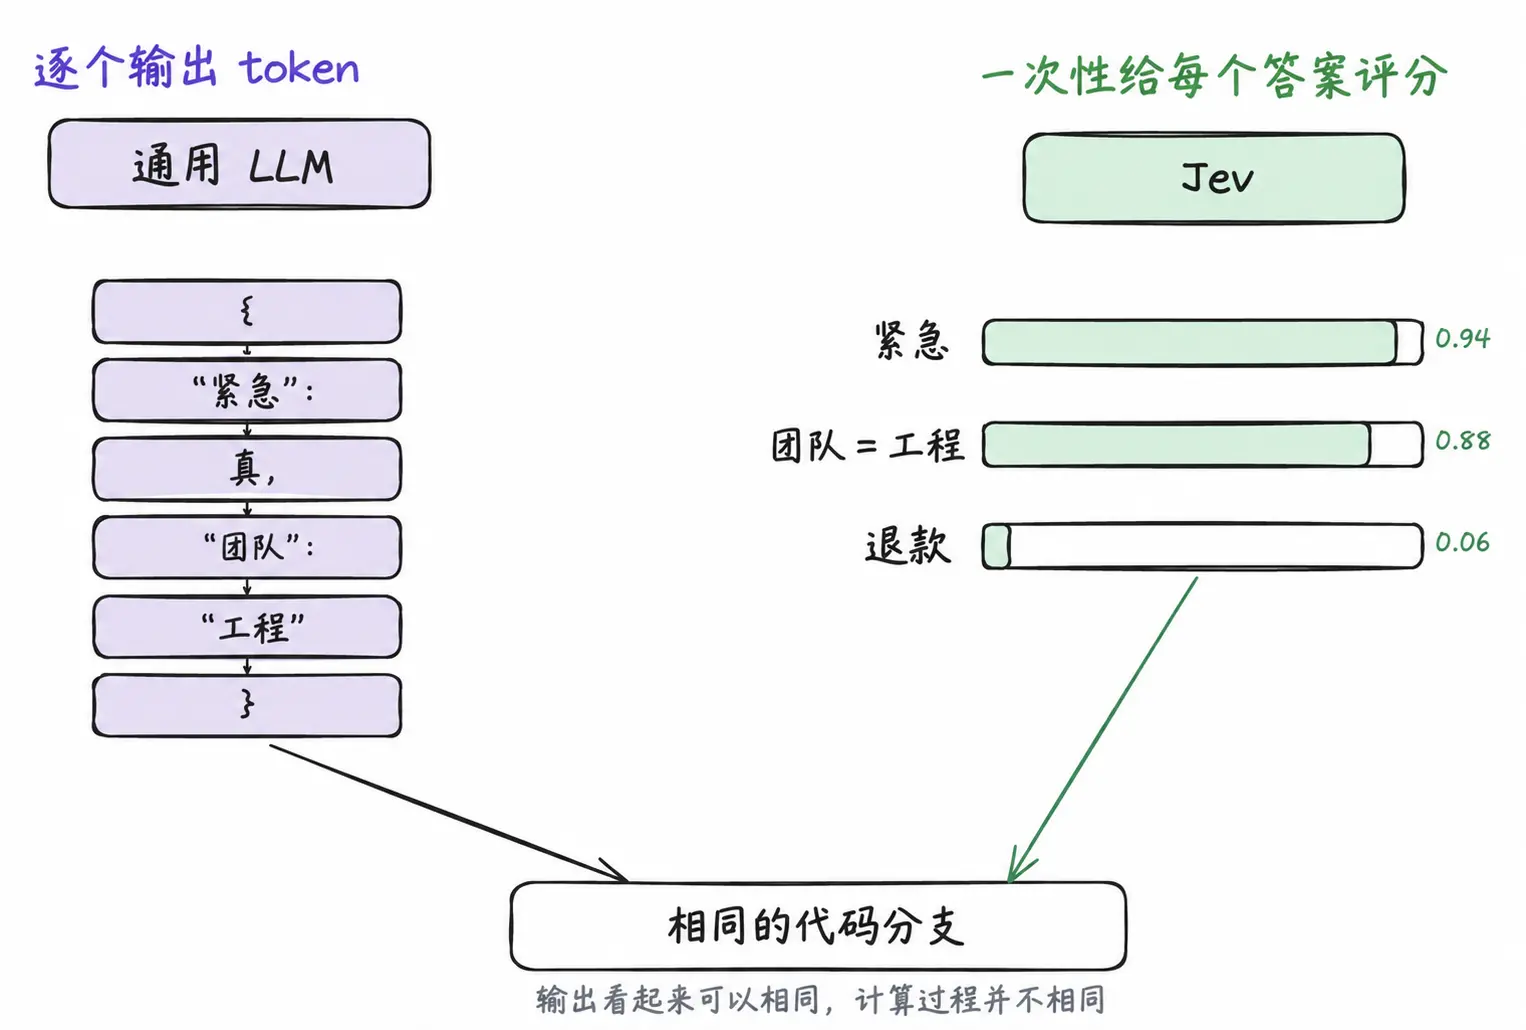
Jevが返すのは説明文ではなく、確定的な確率値とチームの確率分布です。
余計な言葉は一切なく、存在しない第4のチームを勝手に作り出すこともありません。
ビジネスコードは直接ロジック制御を引き継ぎます:
python
if urgent > 0.9 and owner == "engineering":
    page_on_call()
elif confidence < 0.6:
    send_to_human_review()
else:
    add_to_queue(owner)
多くのエンジニアはこれを「意味理解能力を持つswitch文」と表現しています。
ビジネスの分岐は依然として従来のコードの手中にあり、Jevはコード自体では計算できない意味的判断を提供するだけです。
コア指標:200倍速、400倍安い
Jevは単一のリクエスト内で全ての問題を並行評価することをサポートしています。
これは、シリアルに質問する必要がなく、同じ内容に対するすべての独立した判断を一度に送信できることを意味します。
公式に発表された実測データ:
エンドツーエンドの遅延:70から500ミリ秒。
価格:100万入力トークンあたりわずか0.042ドル、出力トークンは完全に無料です。
公式が提供した複数のワークフローの実測比較において、Jevの総合実行速度は従来の大モデルワークフローの約200倍、総合コストは約400倍削減されました。
たとえ複雑なビジネス環境でこれらのデータを理論的上限として見た場合でも、もたらされる効率の向上は桁違いです。
確率と信頼度が重要な設計
単一の分類ラベルを与えるだけでは、安全性が不十分なことがよくあります。
仮にJevがある工事依頼を「財務チーム」に分類し、結果が次のようになったとします:
json
{
  "choice": "billing",
  "probabilities": {
    "billing": 0.52,
    "technical": 0.46,
    "sales": 0.02
  },
  "confidence": 0.18
}
財務が最高票を得ましたが、技術サポートは46%の確率を得ており、全体の信頼度は0.18です。
システムが自動的に割り当てると、間違いが起こりやすくなります。
この確率分布があれば、開発者はコード内で明確に線を引くことができます:
高信頼度 :自動的に小リスクのロジックを実行します。
中信頼度 :より強力な大モデルで再確認するか、ユーザーに二次確認を求めます。
低信頼度 :直接人間のレビューキューに回します。
Jevは「キャリブレーションに基づく意思決定の強化学習(RLCD)」トレーニング手法を採用しています。モデルが90%の確率判断を出すとき、その実際の正確性も90%前後に高く収束します。
明確にすべき事実:Jevは本当に幻覚を生じないのか?
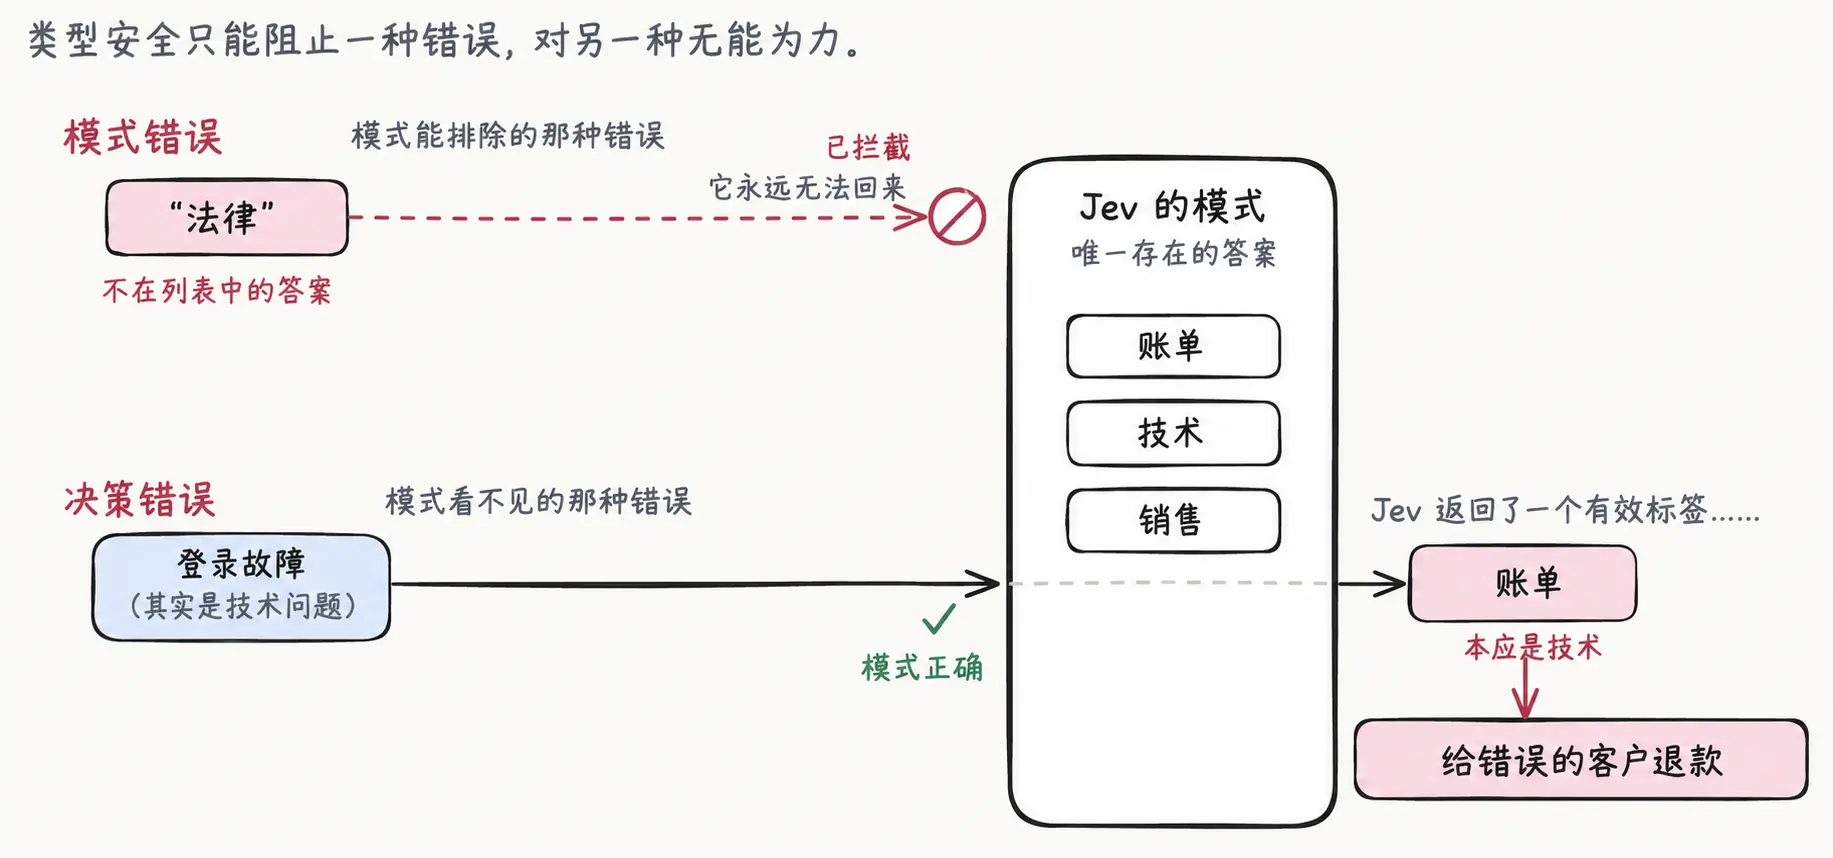
公式の宣伝では「Jevは幻覚を生じない」と述べています。この言い方が成立する前提は非常に厳格です。
Jevは、あなたが定義したスキーマの出力フォーマットを超えた内容を決して返しません。あなたがA、B、Cの3つのオプションを定義した場合、Dを返すことは絶対にありませんし、無効なJSONを出力することもありません。
しかし、これは彼の判断が常に正しいことを意味するわけではありません。
型安全性が保証するのは出力構造が崩れないことであり、ビジネス判断が間違わないことを保証するものではありません。
型定義に合致した誤った判断は、依然として誤って返金したり、誤って故障工事依頼を配信したりする可能性があります。
正確な理解はこうです:Jevはコード契約を破壊しないことを保証しますが、それでも間違った選択肢を選ぶ確率があります。
Jevはシステムのどの位置に最適か?
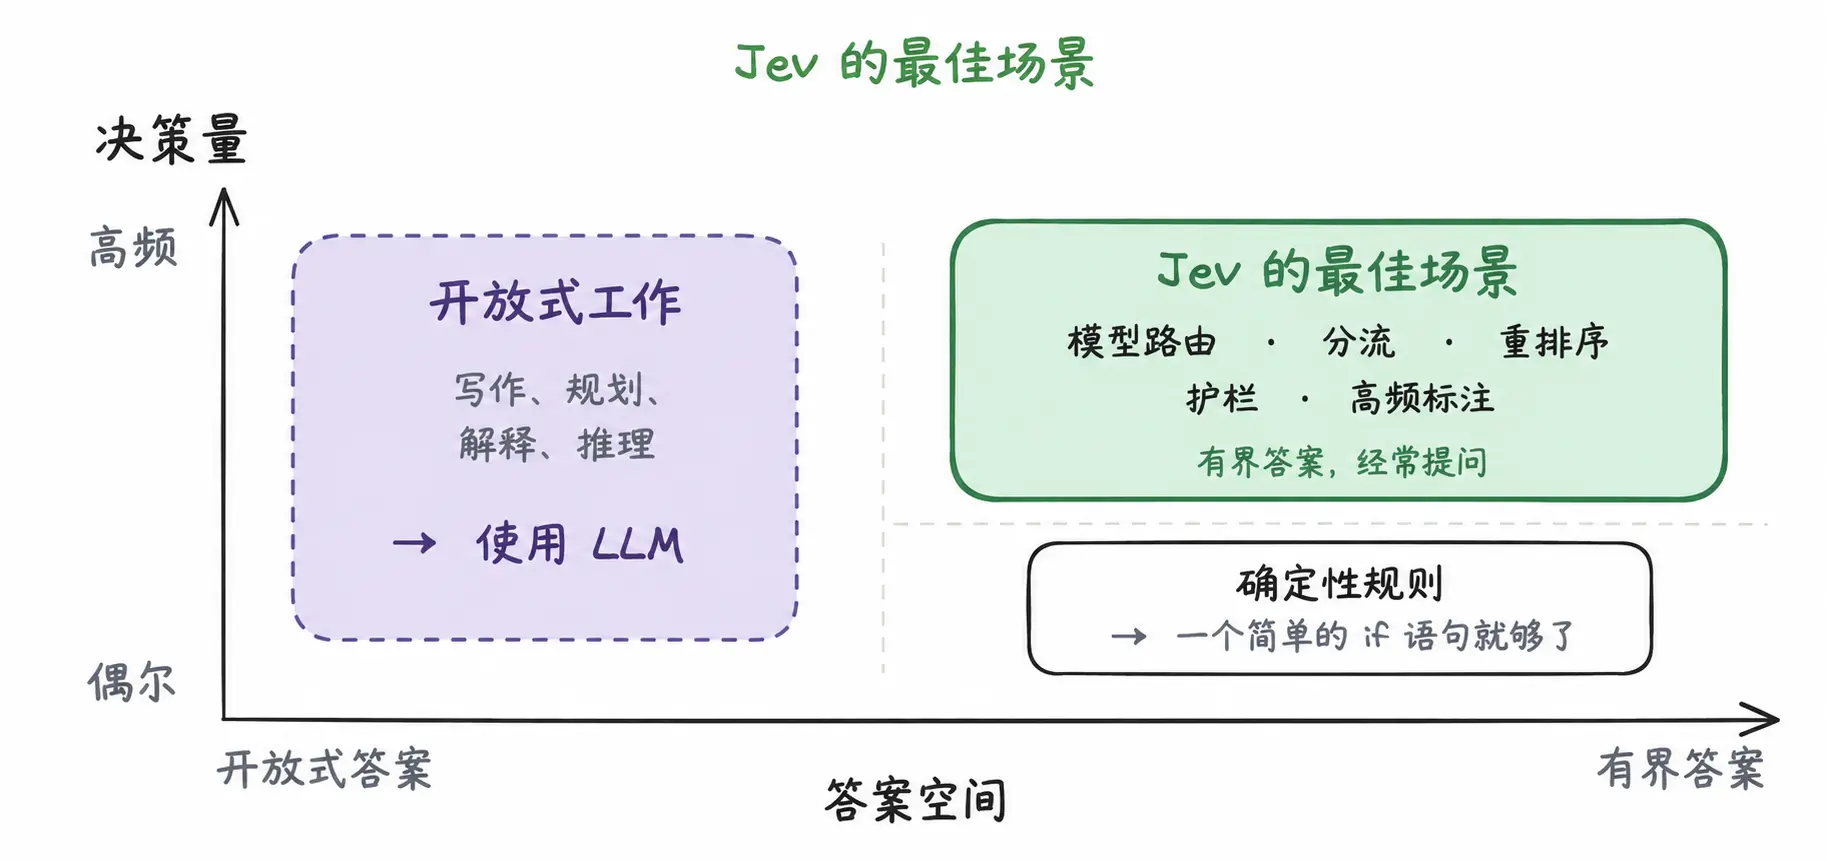
Jevの位置付けは非常に明確です:それは大モデルと連携するために設計されており、大モデルを置き換えるつもりはありません。
大モデルはコードを書く、プランを書く、長文推論とコミュニケーションを行います。
Jevはその周りで、高頻度で迅速な境界制御を行います。
現在、最も成熟した実用シーンは3つあります:
モデルルーティング(Model Routing)
ユーザーのリクエストに対して、まずJevがタスクの難易度を判断します。簡単な検索や書き換えは安価な小モデルに直接割り当て、高難度のアーキテクチャ設計は高価な推論モデルにルーティングします。
ツール実行リスク管理(Tool Risk Gating)
エージェントが端末コマンドを呼び出す前に、Jevを使ってコマンドが読み取り専用、可逆、または破壊的かを判断します。破壊的操作は自動的に一時停止し、人工の承認を待ちます。
結果検証と監視(Verification)
タスクが終了する前に、Jevに迅速にチェックさせます:テストケースは通過しましたか?エージェントは繰り返し呼び出しの無限ループに陥っていませんか?出力は事前に設定したルールに違反していませんか?
Jevを絶対に使わないべき時
必要ない場所には、無理に導入しないこと:
答えの空間が不確定な時 :記事を書く、要約を作成する、コードを生成する場合は、必ず従来の大規模モデルを使用する。
確定的な論理演算 :数学計算、文字数カウント、日付比較は、直接純粋なコードで実装し、純粋なコードは常にモデルよりも安価で、速く、信頼性が高い。
複雑な長い推論が必要な時 :多段階の論理推演は、思考チェーン能力を持つ推論モデルに任せるか、大きな問題を複数の離散的な小問題に分解してからJevに渡すべきである。
どのように始めるか?
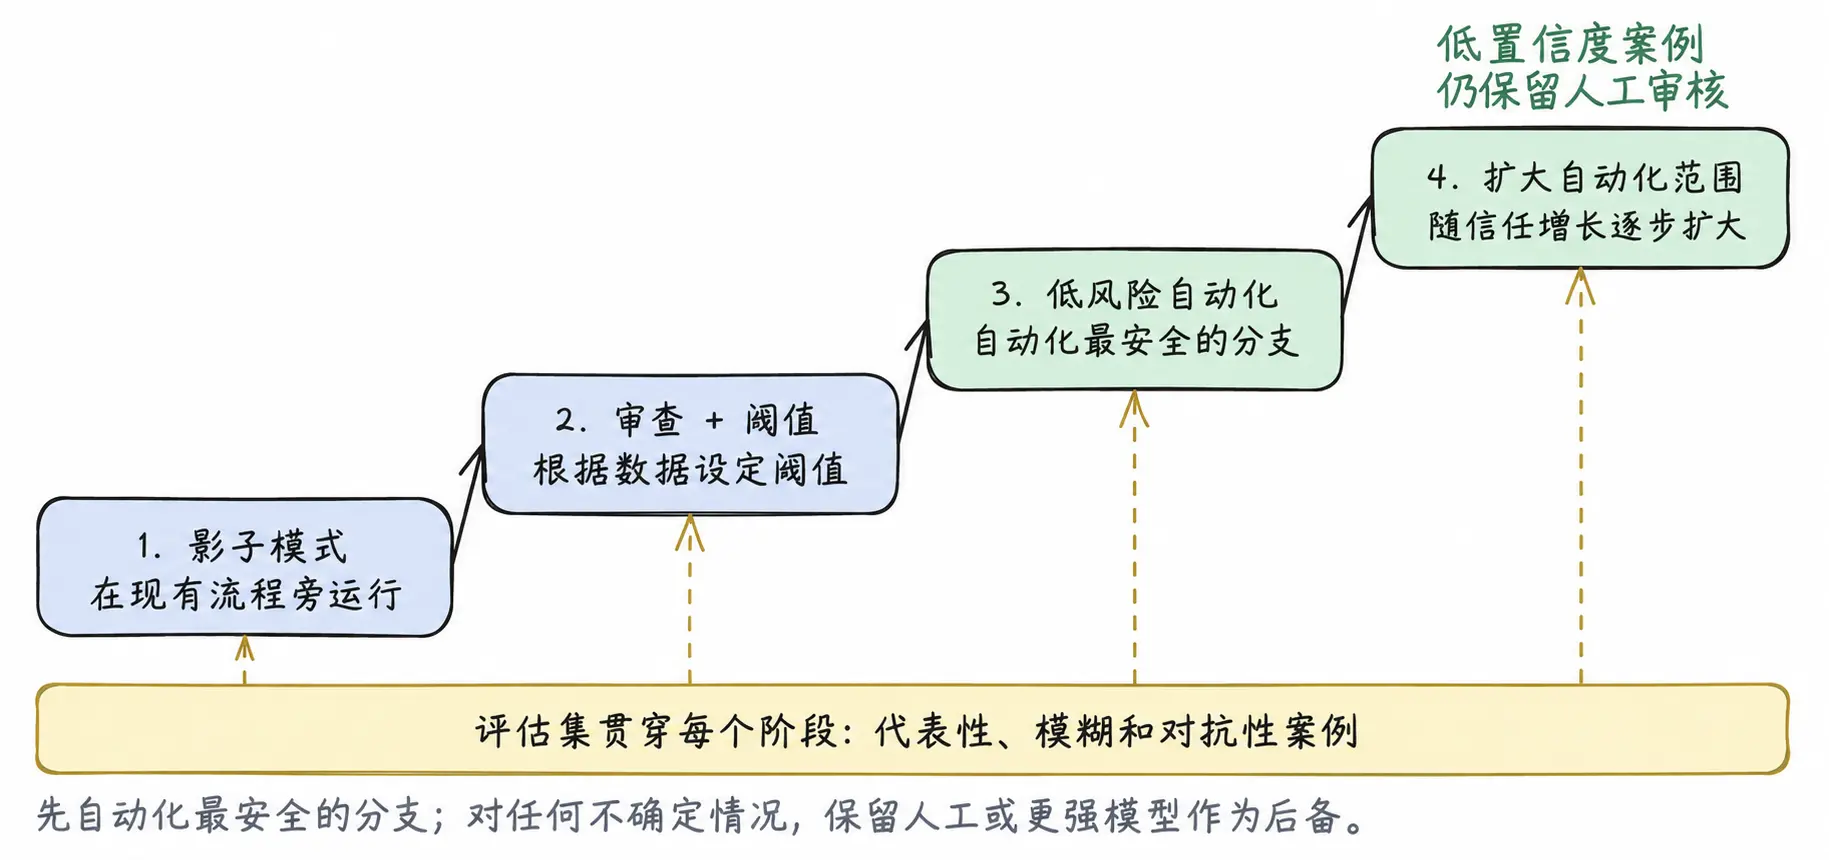
最初からコアビジネスを再構築しないこと。
最も安全な接続方法は:
現在メンテナンスコストが最も高く、エラーが発生しやすい正規表現ルール、または大規模モデルを呼び出して真偽判断を得るためのノードを選ぶ。
このノードのすべての可能なオプション定義を明確に記述する。
Shadowモード(影子モード)を開始し、Jevと既存のロジックを並行して実行し、データを収集して信頼度閾値を調整する。
精度が基準を満たした後、正式にトラフィックを切り替える。
現在、TypeSafeは完全にアクセスを解放しており、待機リストを必要としない。登録すると5ドルのクレジットが贈呈され、約1.2億トークンの入力量を直接テストできる。
ここ数年、業界全体は文字生成を用いてすべての問題を解決することに慣れてきた。
しかし、多くのエンジニアリングシステムでは、コードが必要とするのは、より美しい文字ではなく、ミリ秒単位の応答、フォーマットを壊さず、コストが極めて低い正確な判断である。
これがJevが開発者コミュニティで急速に注目を集める根本的な理由である。
 リスク警告