グーグル Gemini Decision 1 発表:逐語生成を行わず、一度のリクエストで 1000 の質問を判定
 核心的な視点

 Googleは初の意思決定モデルGemini Decision 1を発表しました:逐語的に生成せず、単回の前方伝播で最大1000の質問にスコアを付けることができ、エンドツーエンドの遅延は150〜250ミリ秒、100万入力トークンあたりわずか0.10ドルです;9つのベンチマークで7つの1位を獲得し、最高の正確率は92.2%です。
著者|冬梅(AI前線)
全体のAI業界が誰がより多くのトークンを生成できるか、誰の推論能力がより強いかを競っている中、Googleは逐語的に回答を生成しない新しいモデルを発表しました。
最近、Googleは正式にGemini Decision 1を発表し、このモデルに基づくGemini Decisions APIを同時にリリースしました。従来の生成型大モデルとは異なり、このモデルは迅速な意思決定のために特別に設計されており、トークンを一つずつ生成する必要はなく、単一の前方伝播を通じて事前に設定された候補回答にスコアを付けます。
GoogleのCEO、Sundar PichaiもXプラットフォームでGemini Decision 1の主な機能を紹介しました。彼は次のように書いています:
今日、私たちはGoogle AI StudioでGemini Decisions APIを正式に発表し、全く新しいGemini Decision 1モデルによってサポートされています。
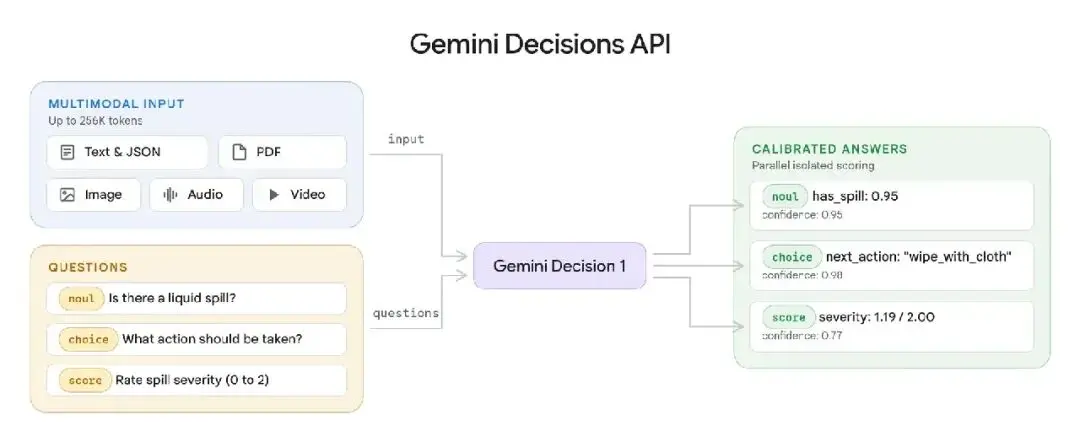
従来のモデルがトークンを一つずつ生成するのとは異なり、このモデルは閉じた選択肢の中での意思決定タスクのために設計されています。単一の処理プロセスで、テキスト、画像、音声、動画、PDF内の最大1000の質問にスコアを付けることができます。
以下はいくつかの注目すべき詳細です:
· 三種類の意思決定タイプをサポート:はい/いいえの判断、複数選択(最大255の選択肢)、およびスコア基準に基づくスコアリング;
· 毎百万入力トークンの価格はわずか0.10ドル、出力トークンの費用はゼロで、コストはFlash-Liteの約5分の1;
· 複数のベンチマーク評価でリードしており、最も低いキャリブレーション誤差を持っています。
Google内部のチームはすでにこの技術を使用し始めています。
過去には、開発者がAIにメールがスパムかどうかを判断させたり、どのエージェントにタスクを割り当てるべきかを決定する際に、生成型大モデルを呼び出し、モデルが生成したテキストから結果を抽出する必要がありました。Gemini Decision 1は逐語的なデコードのプロセスを省略します。
開発者は入力内容、判断すべき質問、および候補選択肢を提供するだけで、モデルは対応する判断結果、確率、および信頼度を直接返すことができます。
これは、もともと分類、スコアリング、または選択結果を必要とするタスクに対して、AIが完全なテキスト生成プロセスを完了する必要がなくなることを意味します。
Googleが発表したデータによれば、Gemini Decision 1は一回のリクエストで最大1000の独立した質問を処理でき、テキスト、画像、音声、動画、PDFなどの多モーダル入力をサポートし、エンドツーエンドの遅延はわずか150~250ミリ秒です。
価格も非常に攻撃的です:毎百万入力トークンはわずか0.10ドルで、出力トークンは無料です。Googleが発表した同じベンチマークテストの中で、その呼び出しコストはGemini 3.5 Flash-Liteの約5倍低いです。
さらに注目すべきは、これは選択問題に回答するためのモデルだけではないということです。GoogleはすでにAIモデルのルーティング、エージェントツールの選択、製品設計、安全検査などのシナリオにこれを使用しており、AIシステム内で判断と意思決定を担当する基盤コンポーネントとして位置づけようとしています。
一度に1000の質問を処理し、最大255の選択肢
Googleが発表した技術紹介によれば、Gemini Decision 1は三種類のコア意思決定能力を提供します。
第一のタイプはYes/No(二元判断)です。例えば、画像に安全上のリスクが存在するか、またはテキストが既定のルールに違反しているかを判断します。モデルは条件が成立する確率を示します。
第二のタイプはMultiple Choice(複数選択)です。開発者は2~255の候補選択肢を事前に設定でき、モデルは最も条件に合った答えを選び、各候補の正規化された確率を返します。
第三のタイプはOrdered Rubric(有序基準スコアリング)です。開発者は異なるレベルのスコア基準を自分で定義し、モデルに入力内容を評価させ、連続加重スコアと各レベルの確率を返します。
これら三つのタスクは、一回のリクエストで混合して実行することも可能です。
Googleはシンプルな例を提供しています:モデルにオフィスのティーサーバーの写真をアップロードし、説明文を添えて、デスク上に液体の漏れがあるか、どのような清掃措置を取るべきか、現場の深刻度を同時に判断するように求めます。
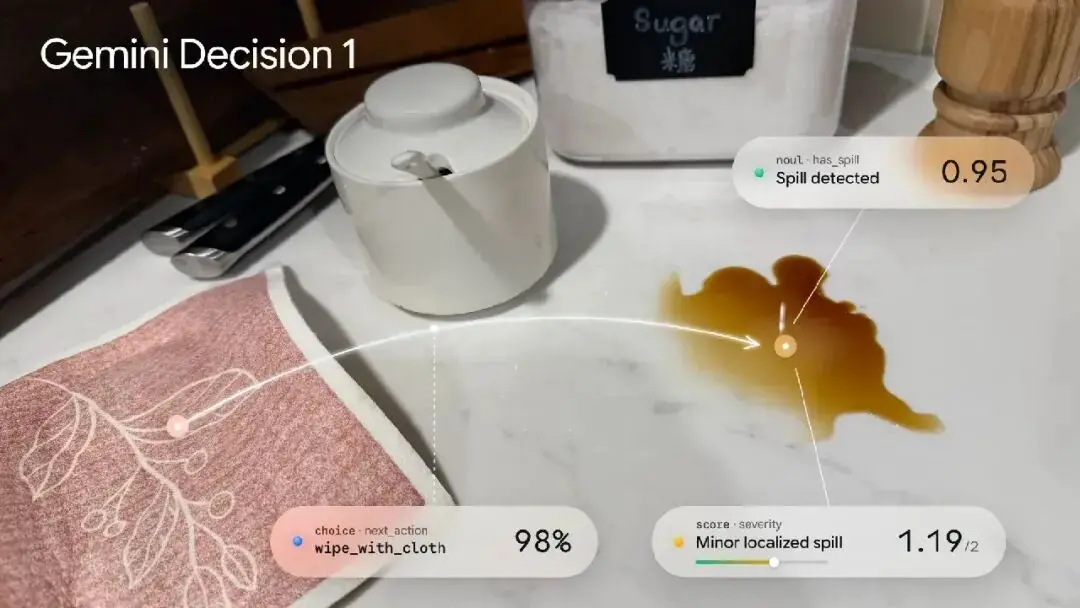
従来の方法では、複数の分類器を設計する必要があるか、生成型大モデルを使用して異なるプロンプトタスクを実行する必要があります。Gemini Decision 1は一回のリクエストでこれらの判断を完了できます。
さらに、モデルは最大256Kトークンの多モーダル入力コンテキストをサポートします。企業シナリオにおいて、これは開発者が通話録音と顧客データを一緒に分析したり、保険請求書と現場の写真を組み合わせて判断することを意味します。
各意思決定は0~1の信頼度を提供し、システムが不確実な結果を他のモデルや人間のレビューに渡すのを容易にします。
Gemini Decision 1のもう一つの競争力は、速度とコストです。
Googleの公式情報によれば、エージェントルーティング、推論、ランキング、および多モーダル理解を含むベンチマーク評価において、Gemini Decision 1はリードを維持し、最も低いキャリブレーション誤差を達成しました。
16Kトークンを超えないテストコンテキストでは、モデル計算段階の中央値遅延は50~100ミリ秒を維持し、エンドツーエンドの遅延は約150~250ミリ秒です。単一のリクエストに含まれる質問の数が1から100に増加しても、遅延は基本的に安定しています。
公式に使用される共通ベンチマークテストセットにおいて、Gemini Decisions APIのコストはInteractions APIを介してGemini 3.5 Flash-Liteを呼び出すよりも約5倍低いです。
9項目のテストで7項目の1位、最高精度92.2%
Googleは今回Gemini Decision 1を発表し、注目すべきモデル比較の成績表も公開しました。
通常の汎用大モデルと比較するのとは異なり、Googleは今回三つの競合製品を選びました:OpenAIのGPT-6 Luna、分類決定向けのTypeSafe Jev 1.14、そして自社のGemini 3.5 Flash-Liteです。
結果を見ると、Gemini Decision 1は9項目のベンチマークテストで7項目の1位を獲得し、確率キャリブレーションにおいてもリードしていますが、他の2項目のテストおよび総呼び出しコストでは、競合他社の方が良い結果を出しています。
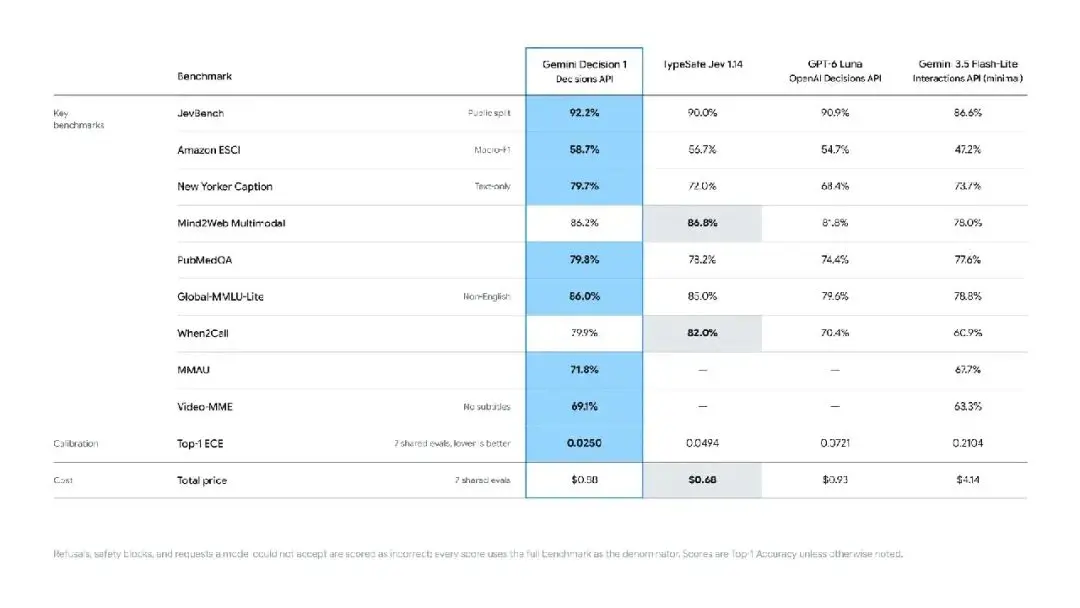
JevBenchテストでは、Gemini Decision 1は92.2%の精度を達成し、GPT-6 Lunaの90.9%、TypeSafe Jev 1.14の90.0%、およびGemini 3.5 Flash-Liteの86.6%を上回りました。
Amazon ESCI商品検索関連性テストでは、Gemini Decision 1は58.7%のMacro-F1スコアを達成し、GPT-6 Lunaよりも4ポイント高く、Flash-Liteよりも11.5ポイント高いです。
New Yorker Captionテストでは、差がさらに広がりました。Gemini Decision 1は79.7%の成績を収め、GPT-6 Lunaは68.4%で、両者の差は11.3ポイントです。このテストは漫画のキャプションの理解と選択を含み、モデルの文脈理解と候補内容判断能力を試します。
医学問答テストPubMedQAでも、Gemini Decision 1は同様に1位を獲得し、スコアは79.8%で、GPT-6 Lunaの74.4%を上回りました。
多言語テストGlobal-MMLU-Liteの結果も似ています。Gemini Decision 1は86.0%、GPT-6 Lunaは79.6%で、両者の差は6.4ポイントです。
しかし、Googleは全面的なリードを達成していません。
Mind2Web Multimodalテストでは、TypeSafe Jev 1.14が86.8%の成績で1位、Gemini Decision 1は86.2%で0.6ポイント遅れています。
ツール呼び出し判断能力を試すWhen2Callテストでは、TypeSafe Jev 1.14の優位性がさらに明確で、スコアは82.0%、Gemini Decision 1は79.9%です。
この結果は特に注目に値します。ツールの選択と呼び出しのタイミング判断はGemini Decision 1が重点的に向けているエージェントアプリケーションシナリオの一つですが、このテストでは専用の決定モデルTypeSafe Jevが依然としてリードを維持しています。
さらに、音声理解テストMMAUと動画理解テストVideo-MMEでは、Gemini Decision 1はそれぞれ71.8%と69.1%を達成し、いずれもFlash-Liteを上回っています。
精度よりも注目すべきは、Googleが特に強調した確率キャリブレーション能力です。
Top-1 ECE(Expected Calibration Error、期待キャリブレーション誤差)テストでは、Gemini Decision 1のキャリブレーション誤差はわずか0.0250で、GPT-6 Lunaは0.0721、TypeSafe Jev 1.14は0.0494、Flash-Liteは0.2104に達しました。
言い換えれば、この評価グループでは、Gemini Decision 1 のキャリブレーション誤差は GPT-6 Luna より約 65% 低く、Flash-Lite より約 88% 低いです。
この指標は Agent システムにとって特に重要です。
例えば、ある Agent が特定のコードにセキュリティの脆弱性が存在するかどうかを判断する必要がある場合、モデルが提供するのは「存在する」または「存在しない」という結果だけでなく、確率値も含まれる可能性があります。システムは確率と実際の正確性の関係に基づいて、自動的に行動を取るか、人工的にさらに確認するかを決定できます。
グーグルはすでに使用中:Agent ルーティング遅延を最大 40% 削減
いくつかの新しいモデルがベンチマークスコアを示すだけの中、グーグルは今回、Gemini Decisions API の内部製品での適用事例も公開しました。
その中で最も注目すべきは Gemini Notebook です。
グーグルは Decisions API を利用してリアルタイムモデルルーターとして機能させ、ユーザーのリクエストの複雑さに応じて適切なモデルのレベルと思考の強度を選択しています。日常的な簡単な問題に対しては、システムはコストが低く、応答が速いモデルを優先的に呼び出すことができます;複雑な推論タスクに直面した場合は、リクエストをより強力なモデルに渡します。
グーグルは、この動的ルーティング方式を利用することで、日常的なクエリの遅延を最大 40% 削減できると述べています。
この設計は現在の Agent システムの発展トレンドと密接に関連しています。Agent がタスクを完了する際には、次のアクションを判断する必要があることが多く、例えばどのツールを選ぶか、どのモデルを呼び出すか、または人工的な介入が必要かどうかを決定します。
もしすべての簡単な決定を大型生成モデルに処理させる必要があると、システムは追加の遅延とコストを負担しなければなりません。専用の決定モデルは別の選択肢を提供します:比較的簡単で選択肢が明確な判断を低遅延モデルに処理させ、複雑なタスクは汎用大モデルに任せることです。
Gemini Notebook の他に、グーグルはさらに 3 つのアプリケーションの方向性を公開しました。
Google Stitch では、新しく導入された Rapid Canvas 実験機能が Decisions API を利用して、数秒でインタラクティブな製品フローチャートを形成し、ユーザーが音声やクリックで発した修正指示に迅速に応答します。ユーザーがデザイン方向を確認した後、ページは完全な Stitch ワークフローに移行してさらに改善されます。
Google Labs の CC 製品では、Decisions API が 200 以上の Emoji オプションから適切な表情反応を迅速に選択するために使用されています。Google Search 内部では、グーグルはこの API を利用して MCP ツールのセキュリティ検出層を構築し、潜在的な対抗行動やコンテンツを識別しています。
 リスク警告 リスク警告