








Глубокий взгляд на Jev: сможет ли он надеть корону "парадигмальных изменений"
 Ключевые тезисы

 Общая оценка требует одновременного использования множества способностей, нельзя считать, что это проще, только потому что в итоге выводится одна вероятность.
Автор:Боян
Редактор:Сюй Циньян
В технологическом круге циклы хайпа всегда удивительно похожи.
Сентябрь 2026 года, весь Силиконовая долина и сообщество с открытым исходным кодом без ума от модели под названием Jev.
Она утверждает, что это модель «Система Один (System One)», которая якобы может принести революционные изменения.
За последние три-четыре года мы привыкли к тем большим языковым моделям (LLM), которые, как многословные писатели, прежде чем ответить на простой вопрос «да» или «нет», сначала генерируют сотни бессмысленных токенов размышлений, а затем медленно выдают заключение в формате JSON.
Но Jev отличается, она обещает дать вам решение, предоставить вероятность и делать это с поразительной скоростью.
Разработчики без ума от такого «быстрого, точного и жестокого» интерфейса.
В конце концов, когда вы строите сложного AI-агента, вам часто нужно просто спросить его: «Это воспоминание имеет отношение?», «Какой инструмент следует использовать для этого запроса?», «Требуется ли ручная проверка этого инцидента?».
Все в бизнесе тратят слишком много токенов и времени на задержки, чтобы заставить универсальную большую модель генерировать текст, объяснения и структурированный код для каждой мелкой проблемы. Jev затрагивает крайне болезненную точку, исходя из реальных потребностей.
Но действительно ли она обладает достаточной революционностью?
Когда мы исключаем процесс «генерации текста», сколько из оставшихся в этом черном ящике возможностей суждения на самом деле является результатом оригинальной большой языковой модели, а сколько — результатом специальной тренировки команды TypeSafe?
Чтобы ответить на этот вопрос, мы можем поэтапно разобрать упаковку Jev и рассмотреть несколько аспектов.
01
Модели предсказания суждений появились раньше GPT
Направление, которое представляет Jev, имеет очень долгую историю.
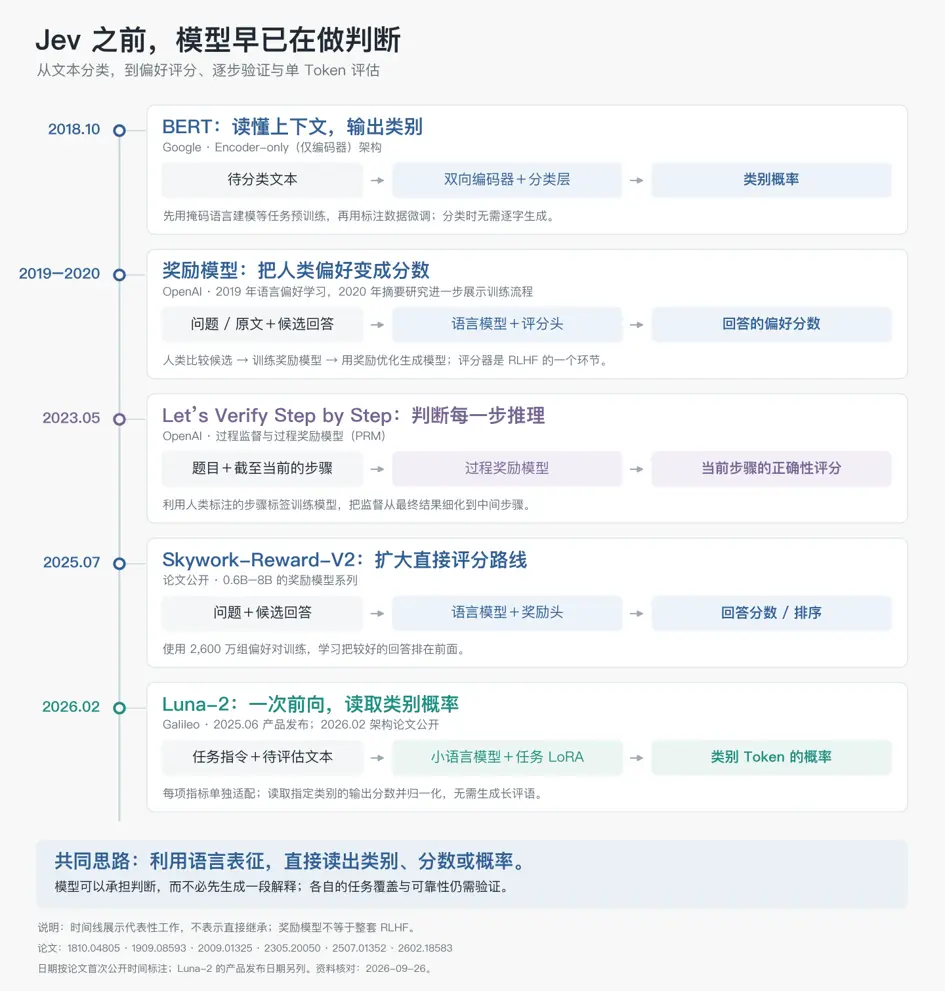
Еще в 2018 году Google представил BERT. В отличие от моделей типа GPT, с которыми мы знакомы сегодня, она использует архитектуру только кодировщика (Encoder-only), позволяющую двусторонний обмен информацией, и обучает модель заполнять пропуски.
Хотя позже модели только декодера (Decoder-only), такие как ChatGPT, стали мейнстримом, BERT по-прежнему имеет свои преимущества в четко определенных задачах классификации.
Благодаря возможности видеть всю информацию, BERT может комбинировать различные позиции в тексте с учетом контекста, формируя полное представление признаков, а затем, подключив простой классификатор, быстро делать суждения после обучения на размеченных данных.
На самом деле современные LLM также часто обучаются в роли классификаторов.
В 2019 году OpenAI в статье «Fine-Tuning Language Models from Human Preferences» уже начала пытаться заставить модели изучать предпочтения людей к тексту.
К 2020 году в исследованиях по резюме текстов эта технологическая линия стала более ясной: сначала человеческие аннотаторы сравнивают два резюме, а затем используют их для обучения модели вознаграждения, чтобы предсказать, какое из них больше нравится людям.
В этом процессе человеческие суждения успешно преобразуются в функцию оценки. Модель вознаграждения сама по себе не требует написания длинных рецензий, ей нужно просто прочитать вопрос и ответ, а затем через выходной слой нейронной сети сразу выдать оценку.
На самом деле это также одна из самых базовых моделей обучения современных моделей, которую Jev резко критикует — RLHF.
Таким образом, «наследовать способность понимания языковой модели, но не генерировать текст» — это не уникальная гениальная идея Jev.
В известной статье 2023 года «Let's Verify Step by Step» это наблюдение было дополнительно уточнено и применено к каждому шагу модели. Модели вознаграждения, валидаторы и метрики оценки развивались из различных задач и постепенно сформировали несколько незаменимых инструментов суждения в индустрии ИИ.
К 2025-2026 годам соответствующие исследования все еще продолжаются. В 2025 году Galileo выпустил Luna-2 и в последующих статьях продемонстрировал, как обучить маленькие языковые модели в «один токен классификатор», получая вероятность целевой категории через одно прямое вычисление. А Skywork-Reward-V2 представил серию моделей вознаграждения от 0.6B до 8B, оптимизируя прямой путь оценки LLM.
С точки зрения реализации алгоритма это не так уж сложно. Сделать несколько простых изменений в LLM, чтобы она могла напрямую вычислять кандидатные оценки из внутренних скрытых представлений, а не выдавать кучу текста, можно сделать множеством способов.
В последующих экспериментах мы можем увидеть более трех.
Так что же нового принесла Jev в эту волну?
Согласно текущему расшифровке архитектуры и официальным заявлениям, ключевое отличие Jev проявляется в двух измерениях.
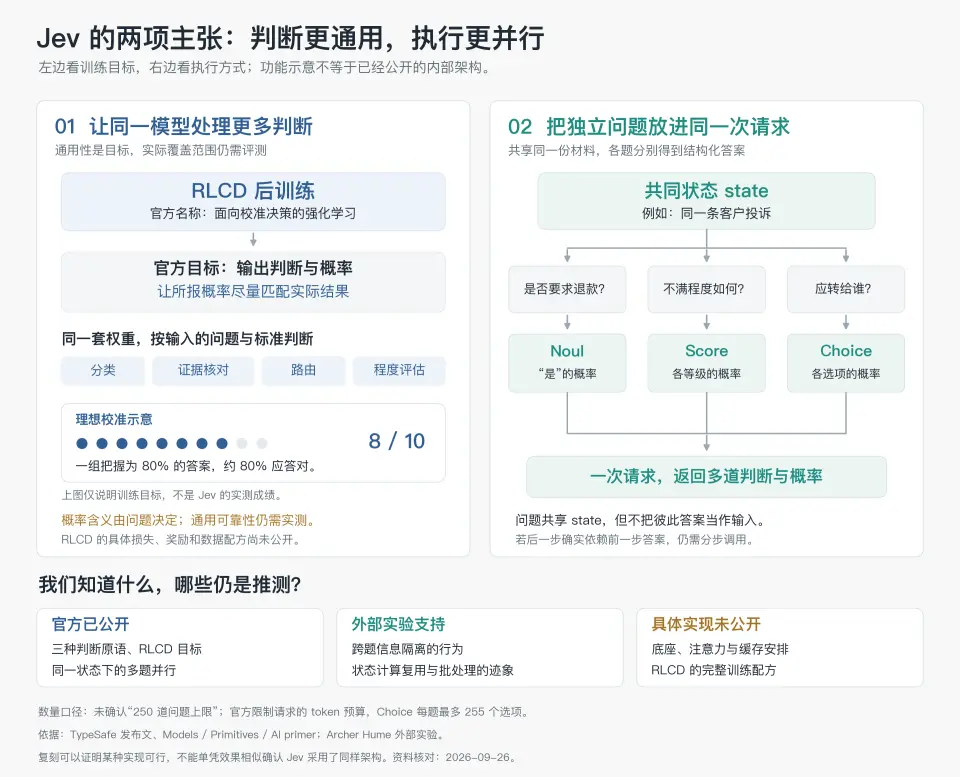
Во-первых, это более универсальные изменения, благодаря ее совершенно новому методу пост-тренировки.
Прошлые модели оценки в основном обучались для выполнения одной задачи. Jev больше не ограничивается какой-то конкретной оценкой, а пытается предоставить крайне универсальный интерфейс вероятности.
И этот универсализм касается вероятности фактов, а не человеческих предпочтений.
На этот раз команда TypeSafe поместила «калибровку вероятности» в абсолютный центр своих тренировочных целей, они назвали этот метод RLCD (усиленное обучение для калибровки решений). В то время как традиционная модель вознаграждения предпочтений (RLHF) ищет вероятность человеческих предпочтений, а не вероятность событий в реальном мире.
Во-вторых, это предельное использование параллельных вычислений в архитектуре.
Jev изменила способ, которым информация проходит через модель. Прошлые модели оценки не сильно изменялись в параллельных ответах, поскольку основной целью было обучение плотной модели вознаграждения, чтобы оценивать каждую выдаваемую токен.
Но теперь Jev может отвечать на 250 вопросов по одному и тому же материалу. Если между этими вопросами нет зависимостей в порядке генерации, их можно выполнять в большом масштабе параллельно.
Как это реализовано?
Хотя Jev сама не раскрыла свою архитектуру, основываясь на ее фактических показателях и многочисленных попытках восстановить Jev, мы уже можем примерно описать ее контуры.
02
Собирая из тестов и восстановлений, воссоздаем оригинальный облик Jev
Сначала давайте посмотрим, что TypeSafe в настоящее время опубликовала.
Снаружи черного ящика TypeSafe четко опубликовала интерфейс. Вы можете предоставить этому интерфейсу две вещи,
State (состояние): эквивалент оригинального текста длинного чтения (например, длинная запись жалобы клиента или системный журнал).
Questions (вопросы): к этому оригинальному тексту вы можете одновременно задать несколько вопросов. Вопросы не мешают друг другу. После получения этих независимых ответов система передает их разработчику (вам), чтобы вы решили, как дальше действовать.
Чтобы стандартизировать вопросы, TypeSafe свела способы задавания вопросов к трем примитивам (Primitives). Включая:
Noul (вопросы с ответом да/нет): спрашивает «да ли», возвращает вероятность от 0 до 1 (например: это срочно? Возвращает 0.95).
Choice (вопросы с выбором): спрашивает «что выбрать», предоставляет несколько вариантов и возвращает их вероятностное распределение (например: передать в технический отдел 0.8, передать в финансовый отдел 0.2).
Score (вопросы с оценкой): спрашивает «насколько», возвращает вероятности различных уровней и окончательную взвешенную оценку (например: индекс гнева клиента 4.5).
Если цель состоит в том, чтобы программа делала распространенные суждения, эти три примитива охватывают большую часть форматов вывода, почти все суждения могут быть преобразованы в эти три типа вопросов.
Наконец, программа получает числа и принимает меры в соответствии со своими правилами.
Официально обещано, что Jev прочитает State только один раз. Затем все вопросы будут в одном запросе, выполняя параллельные и независимые суждения по этому состоянию.
Независимость означает, что между вопросами нельзя ссылаться на ответы друг друга. Если ваш второй вопрос должен зависеть от результата первого, вам придется отправить запрос дважды.
Поэтому TypeSafe поощряет использование, называемое «Спекулятивное разветвление (Speculative fan-out)»: например, обрабатывая жалобу клиента, даже если в конечном итоге выясняется, что это не сбой системы, программа может сразу задать все вопросы: «это сбой?», «насколько серьезен сбой?», «кому передать?». Система параллельно вычисляет все ответы, а затем логика кода на нижнем уровне отбрасывает ненужные результаты.
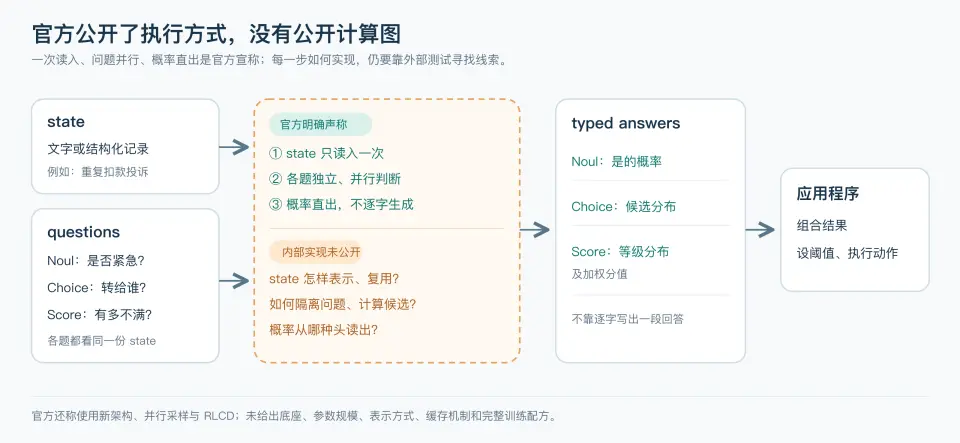
На данный момент это вся основная информация, которую мы знаем из официальных публикаций.
После того как Jev привлекла внимание, Archer Hume провел серию черных ящиков тестов, из которых мы можем получить много информации о том, как Jev обрабатывает текст состояния. В то же время открытые проекты восстановления, такие как Kev, NanoJev, minojev и другие, появились как грибы после дождя.
Сравнив, какие проекты восстановления дают тестовые результаты, наиболее близкие к оригиналу Jev, мы можем обратным образом предположить их истинную внутреннюю архитектуру.
Хотя нельзя сказать, что эти восстановления на 100% воспроизводят сущность Jev, но между огромными черными дырами, оставленными в официальной документации интерфейса, например, как оригинальный текст делится состоянием? Как обычные кандидатные варианты формируют представление признаков? На каком этапе они влияют друг на друга?
Мы также можем увидеть общие контуры через эту призму.
Далее мы используем конкретный запрос, чтобы заново пройти процесс «внутренней переработки» этой модели черного ящика.
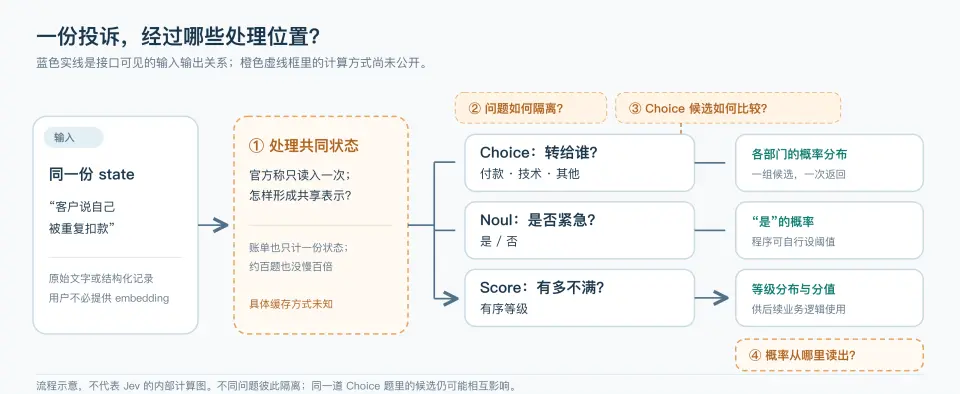
Сначала нам нужно прояснить структуру информации, которую Jev фактически обрабатывает. Полный процесс обработки включает три части: State (состояние) как общий фон (например, длинный текст жалобы), несколько независимых Questions (вопросов) и соответствующие Options (варианты) для каждого из этих вопросов.
Первый этап: обработка общей информации
Если каждый вопрос должен заново прочитать десятки тысяч слов жалобы, чем больше вопросов, тем больше бесполезных повторяющихся вычислений.
Поэтому лучший способ заключается в том, чтобы все вопросы могли прочитать текст только один раз и использовать его.
Чтобы проверить, действительно ли Jev достигла «чтения только один раз», исследователь Archer Hume изучил счета API и данные задержек: когда отправляется самый простой вопрос с ответом да/нет, счет показывает 268 входящих токенов; при добавлении второго вопроса он становится 276. Дополнительные токены составляют лишь количество символов нового вопроса, система не повторно учитывает общее состояние.
Одновременно, до увеличения количества вопросов до почти ста, время отклика сервера было почти горизонтальной линией.
Хотя правила коммерческого выставления счетов и пакетная обработка скрывают реальные вычислительные записи графических процессоров, это в явном виде сильно соответствует официальному заявлению о том, что "общие материалы читаются только один раз, а каждый вопрос рассчитывается пакетно".
Что касается этой информационной архитектуры, восстановление проекта с открытым исходным кодом Kev в настоящее время выглядит наиболее ясным.
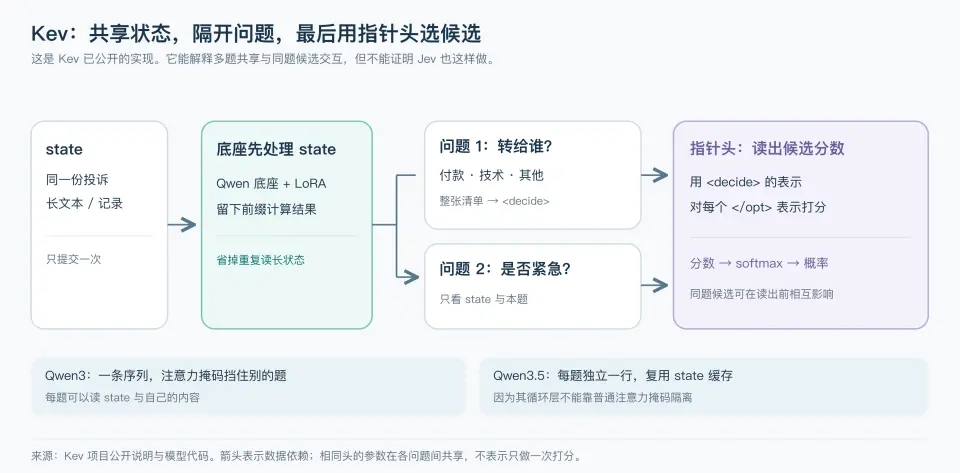
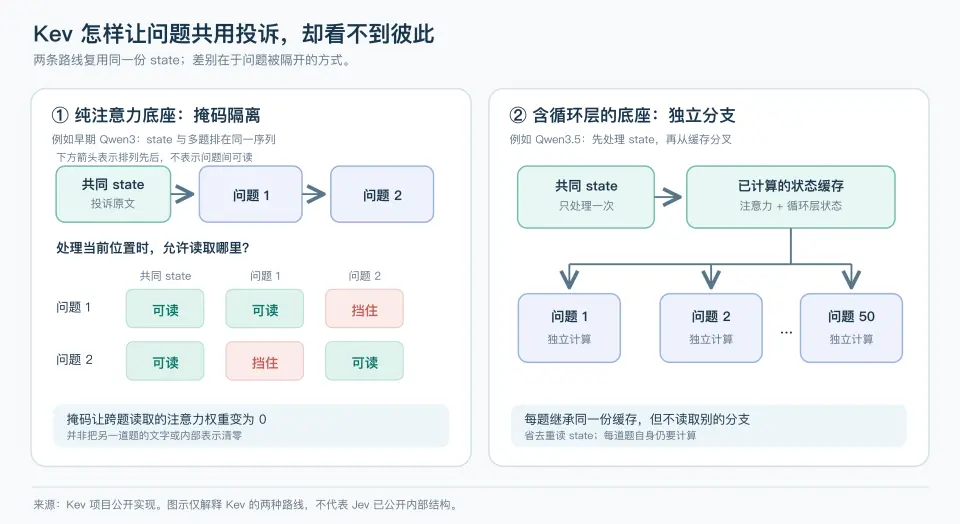
Kev сначала обрабатывает состояние единовременно, замораживая промежуточные результаты вычислений в Kv Cache. Затем эти 50 вопросов используют этот Kv Cache для дальнейших расчетов, так что не нужно читать каждый вопрос заново.
Вторая остановка: разбиение вопросов
Но другой ключевой вопрос заключается в том, действительно ли эти вопросы для пакетных вычислений не пересекаются, как утверждает официальная версия?
Арчер Хьюм для этого разработал хитрый "эксперимент с кодом". Он вставил в вопрос A фразу "код ZEBRA-7741", а затем в вариантах вопроса B заставил модель выбрать "код, упомянутый в другом вопросе". Результаты показали, что вероятность того, что Jev даст правильный код, составляет 0.00. Но если этот код убрать из вопроса A и поместить в общий текст State, вероятность того, что вопрос B даст правильный ответ, мгновенно подскакивает до 0.90 и выше.
Это является сильным доказательством строгой физической изоляции между вопросами: общие материалы видимы для всех вопросов, но соседние вопросы абсолютно не могут "подсматривать" друг за другом.
Чтобы гарантировать, что вопросы могут быть разделены, Kev использовал два метода.
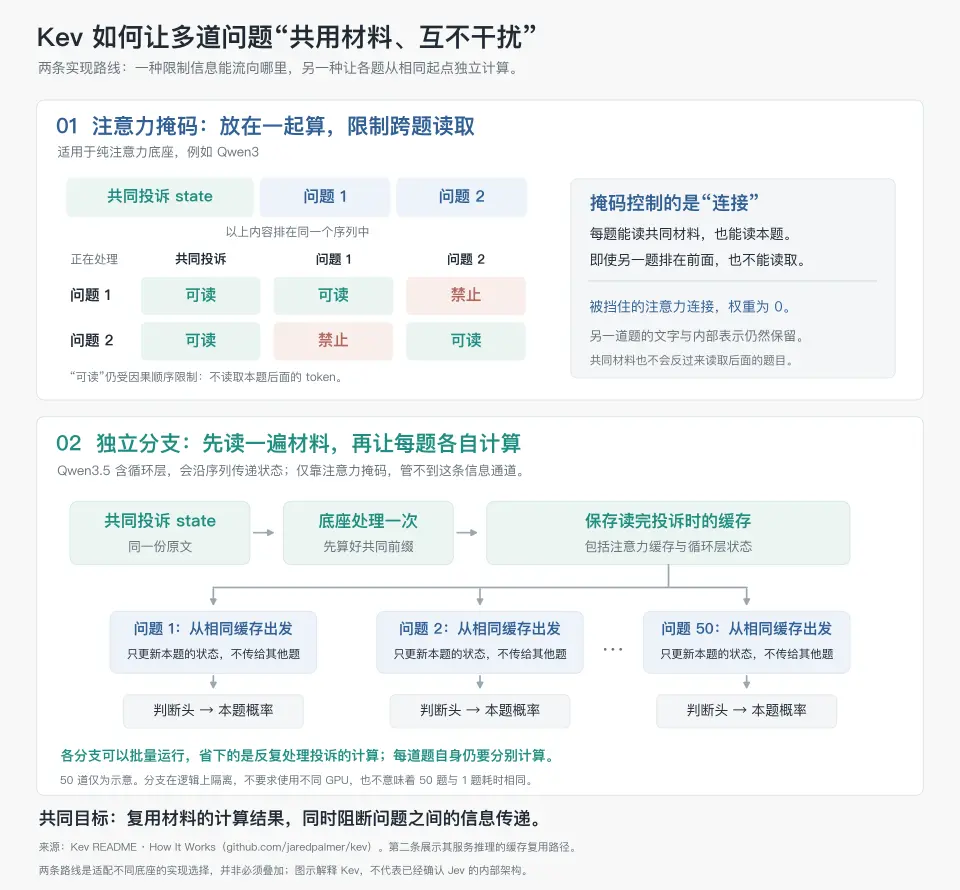
Первый метод — это маска внимания, с ее помощью, когда система объединяет [замороженный текст жалобы] + [вопрос 1] + [вопрос 2] для вычислений, как только модель обрабатывает вопрос 1, механизм маски заставляет область вопроса 2 принимать значение 0, принуждая ее "обращать внимание" только на общий текст жалобы и на себя.
Второй метод — это независимое ветвление, когда используются базы с циклическими характеристиками или определенной архитектурой (например, упомянутая в тексте Qwen3.5), маска внимания не может быть разделена. Поэтому при использовании этих моделей, когда модель завершает чтение текста жалобы, она берет эту замороженную память за отправную точку и непосредственно разделяет на 50 параллельных высокоскоростных дорог (независимых ветвей).
Поскольку каждая из этих развилок идеально наследует уже обработанную память о жалобе на главной дороге, они также получают выгоду от того, что не нужно заново читать оригинал.
Третья остановка: вычисление вариантов
Теперь, когда состояние общее, а вопросы разделены, как модель вычисляет и обрабатывает варианты внутри одного из разделенных вопросов?
В это время перед моделью стоят несколько вариантов, например, "финансы", "технологии". Самый традиционный подход — это линейная голова (Linear Head) плюс Softmax. Это тот же подход, который использовался в версии Zefan Open-Jev, пытающейся воспроизвести Jev.
Вы можете полностью приравнять это к абсолютно закрытому "черному ящику". Участник "финансов" заходит в черный ящик, вы по строгому рейтинговому руководству (это функция линейной головы) ставите ему 80 баллов, затем "технологии" заходят в черный ящик, вы ставите 90 баллов. Эти два человека никогда не встречаются, и вы никогда не сравниваете их. В конце вы используете Softmax, специальную математическую формулу для расчета процентов, чтобы преобразовать 80 и 90 в вероятность успеха.
В этом гипотетическом процессе, если мы добавим в пул вариантов совершенно нелогичный отвлекающий элемент, например, "плохая погода", он в лучшем случае будет выполнять роль пушечного мяса в знаменателе, заставляя все проценты немного уменьшиться. Однако, поскольку 80 баллов для финансов и 90 баллов для технологий уже записаны на бумаге, их "относительные коэффициенты" абсолютно не могут измениться из-за добавления отвлекающего элемента.
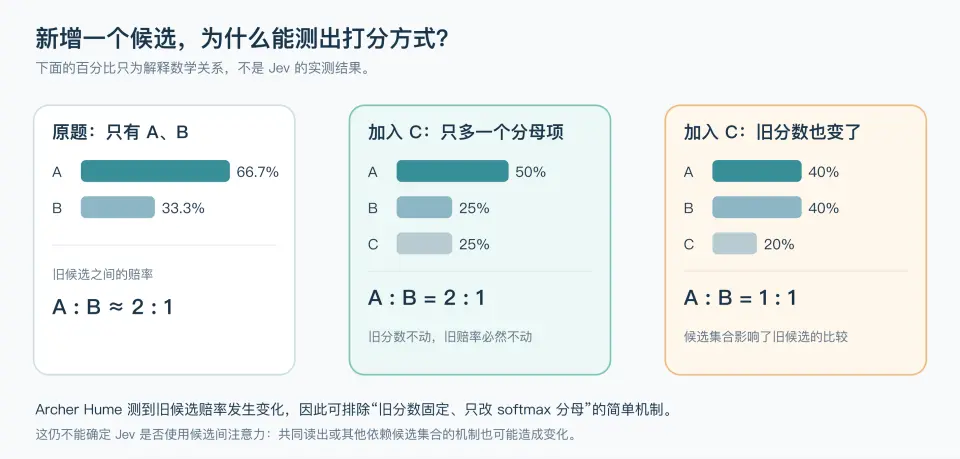
Но тестирование Арчера Хьюма подтвердило, что добавление новых вариантов действительно влияет на разницу в баллах модели. Он жестко вставил "плохую погоду" в набор нормальных вариантов и обнаружил в десяти случайных тестах, что это действительно изменило относительные коэффициенты финансов и технологий. Это прямо приговорило "черный ящик" к смерти.
Поскольку это не слепое тестирование, это означает, что участники "видели друг друга" и произвели химическую реакцию до того, как судьи выставили окончательные баллы. Сообщество с открытым исходным кодом предложило два способа реализации этой химической реакции.
Первый вариант — это "модель указателя (Pointer Head)", разработанная проектом Kev. Вы можете представить это как "групповое собеседование". Модель больше не запирает участников в черный ящик, а выстраивает "финансы, технологии, плохая погода" в ряд, позволяя судьям увидеть всех сразу.
Когда судья видит участника, стоящего в конце, у него уже формируется общее представление о контексте собеседования. Затем судья, стоя на последнем месте, как будто указывая пальцем, по очереди указывает на предыдущих участников, оценивая их на основе общего впечатления — это действие называется указателем. Когда судья смотрит на всех, а затем возвращается к указанию, его психология и система отсчета уже изменились, и выставленные баллы для финансов и технологий естественно также изменятся.
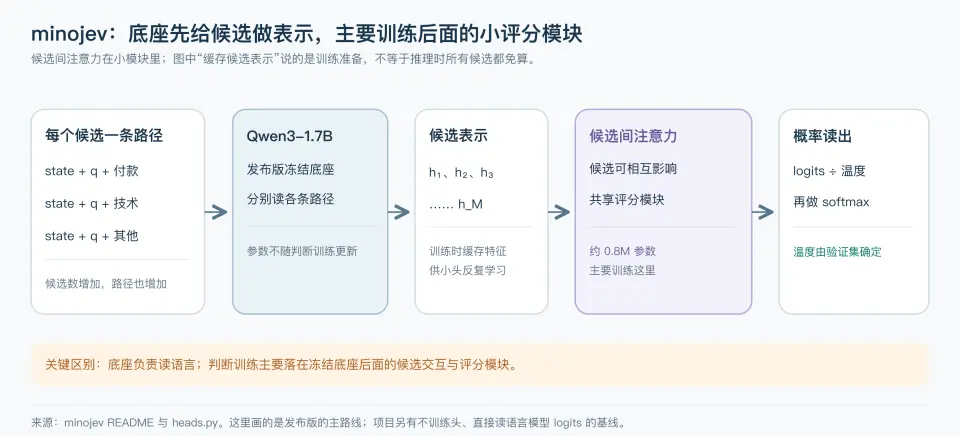
Второй вариант — это "внутреннее обсуждение жюри", разработанный проектами NanoJev и другими, модель "модуля внимания между кандидатами (Inter-candidate Attention Module)". На этот раз модель не является чисто слепым тестированием и не является чисто групповым собеседованием. Сначала она позволяет "финансам" и "технологиям" выступить, сжимая их выступления в длинные высокоразмерные числовые отзывы, этот термин называется вектором признаков.
На этом этапе две карточки отзывов все еще изолированы. Но затем отдельная маленькая модель объединяет эти две карточки отзывов вместе с карточкой отзыва "плохая погода" и помещает их в "модуль внимания".
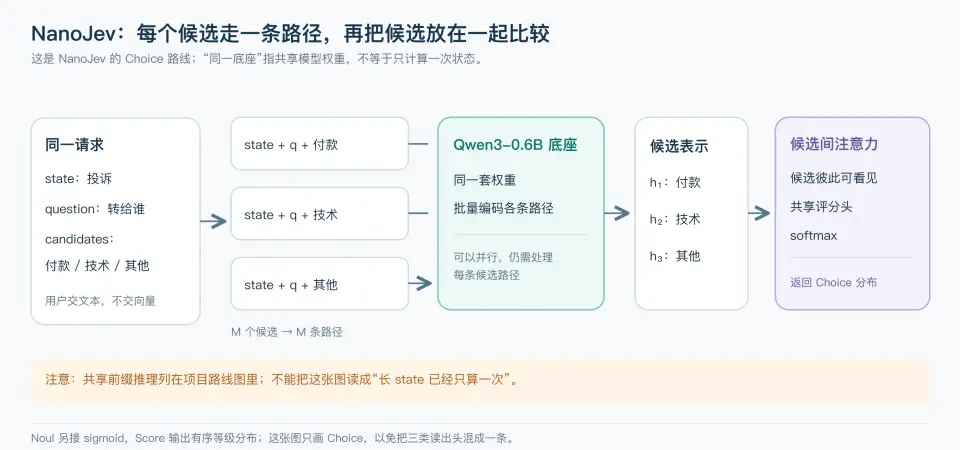
В этой комнате обсуждений эти группы чисел (векторы признаков), представляющие участников, будут взаимно сравниваться и оцениваться. Изначально финансы и технологии были трудноразличимы, но внезапно появляется карточка "плохая погода", которая участвует в обсуждении, и фокус обсуждения и вес сравнения жюри мгновенно нарушается и перестраивается.
После этого внутреннего обсуждения, когда выставляются окончательные баллы, они, естественно, уже не будут выглядеть так, как в начале, когда было только два участника.
Почему Jev так старается заставить эти варианты "взаимно подрывать" друг друга на уровне кода? Это не просто для демонстрации навыков, а потому что в реальных сложных бизнесах правильный ответ часто не абсолютен, а "выявляется" через сравнение. Сами варианты являются скрытыми подсказками для решения задачи.
Например, спросите, где находится Эйфелева башня? Варианты ответа: A. Европа B. Франция C. Париж. Когда модель одновременно видит эти три варианта, они сами становятся скрытыми подсказками для понимания намерения вопроса. Этот вопрос не проверяет приблизительное местоположение, а проверяет максимальную точность географического положения.
Четвертая остановка: выдача результата
Последний шаг процесса — это получение конкретного балла.
Согласно официальному заявлению TypeSafe, Jev будет напрямую возвращать числовую вероятность, никогда не генерируя текст слово в слово.
Внешние наблюдения Арчера Хьюма также подтвердили это, когда он увеличил количество вариантов с двух до двухсот, текст ответа API, хотя и стал очень длинным, но время обработки на сервере не увеличилось пропорционально.
Это указывает на то, что большая модель действительно пропускает наиболее времязатратный шаг саморегрессии (то есть предсказание следующего слова, как в ChatGPT).
Так откуда же берется это конечное числовое значение вероятности? Эта техническая реализация на самом деле разнообразна, в основном зависит от методов, используемых на предыдущем этапе вычисления вариантов.
Метод openjev/openjev, который не обрабатывает взаимодействие вариантов специальным образом, просто считывает из "позиции ответа", где модель должна была сгенерировать первый символ, исходные оценки для заданного кандидата-символа Token из внутреннего словаря большой модели (Logits).
Kev с указателем полагается на тот указатель, который может видеть всю картину, чтобы напрямую выводить сопоставленные баллы. А minojev, добавивший общий модуль, полагается на этот искусственный внешний общий модуль оценки для выдачи результата.
Независимо от способа извлечения, при правильном проектировании процесса большая модель вполне может отказаться от многословной генерации текста и на конечном этапе вычислений напрямую извлекать точные математические вероятности, завершив системное автоматическое принятие решений.
На этом этапе мы уже можем четко на основе оценок и восстановлений примерно обозначить архитектурную модель Jev.
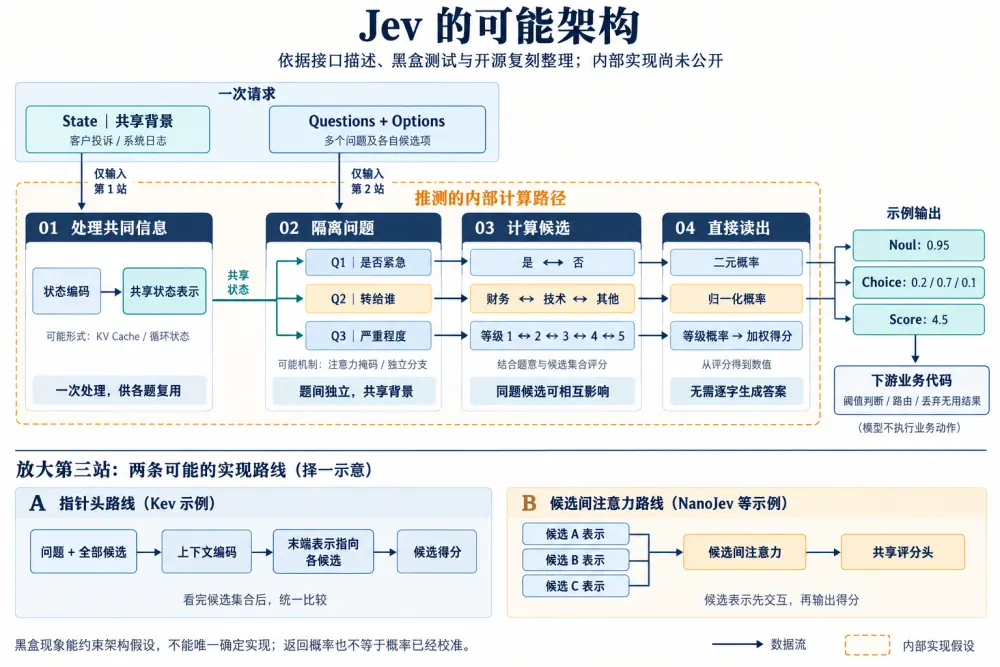
Эта архитектура сама по себе не сложна, и в ней трудно найти что-то, что можно было бы назвать парадигмальной революцией. Хотя это действительно отличная инженерная оптимизация для конкретного сценария, но и только это.
03
Гарантия точности — это постобучение
Архитектура только гарантирует скорость, как же Jev достигает высокой точности?
Это достигается благодаря тому, что TypeSafe называет методом RLCD (усиленное обучение с калибровкой решений). Поскольку RLCD является закрытой черной коробкой, мы можем лишь посмотреть на потенциальные задачи и алгоритмические реализации из попыток сообщества с открытым исходным кодом.
Рождение задачи для обучения RLCD
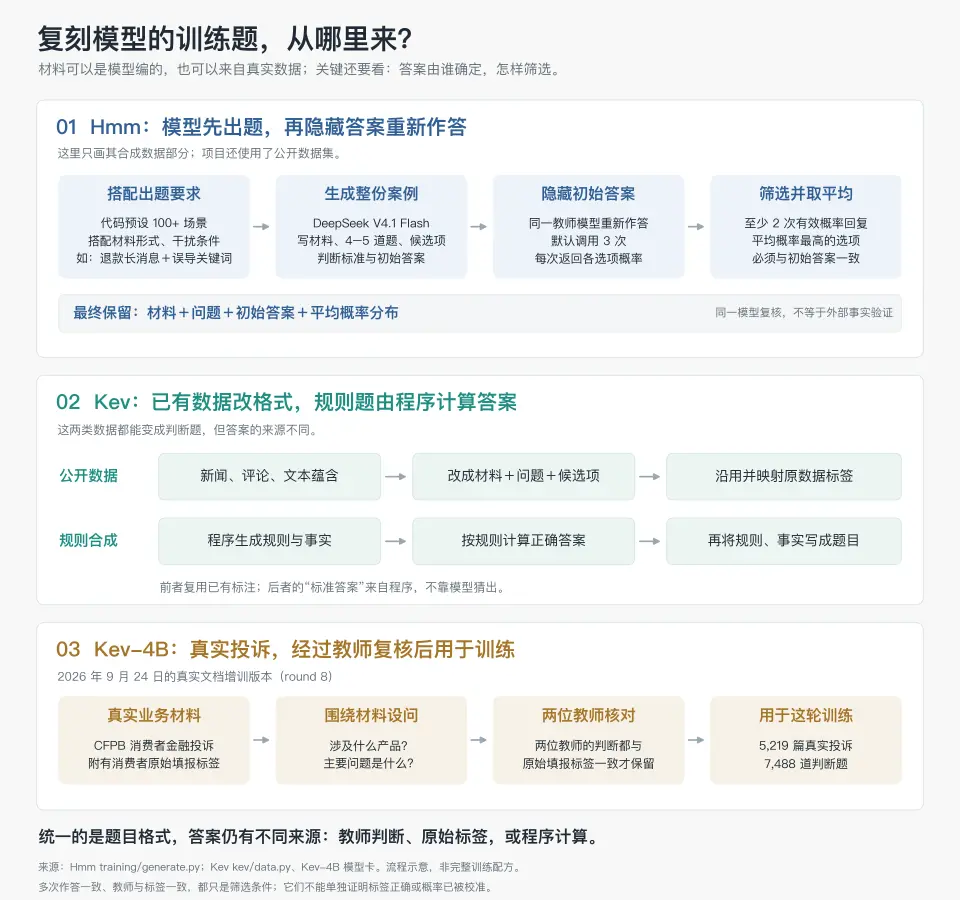
Самый простой способ — это прямой синтез, например, способ, предложенный в версии Hmm.
Исследователи заставили DeepSeek V4.1 перечислить более ста рабочих сценариев в коде, включая обработку возвратов, устранение неисправностей, поиск релевантности, распределение электронной почты и т.д.
Каждый раз выбирается один сценарий, а затем комбинируются формы материалов и требования к вопросам. Например,
использовать длинное сообщение с не относящимися к делу деталями, чтобы написать несколько случаев возврата
добавить случай, который легко вводит в заблуждение по ключевым словам
каждому случаю прикрепить четыре-пять вопросов выбора, истинности или уровня
DeepSeek V4.1 Flash затем генерирует весь материал, вопросы, варианты, критерии оценки и ответы.
Затем тестирование, можно ли использовать эту задачу, зависит от скрытия оригинального ответа, чтобы DeepSeek V4.1 Flash снова ответил, по умолчанию вызывая три раза, требуя каждый раз предоставить вероятность вариантов. Код позволяет использовать только те задачи, которые имеют как минимум два действительных ответа.
Метод Kev заключается в том, чтобы классифицировать существующие новостные данные, комментарии, эмоции и текстовые содержимое, преобразуя их в формат «материалы + вопросы + кандидатные ответы» по установленным правилам.
Модель затем генерирует правила и факты, вычисляет ответы и записывает их в текстовом формате.
24 сентября Kev-4B также попытался использовать реальные рабочие условия для создания вопросов. Они собрали 5,219 реальных жалоб потребителей на финансовые услуги, чтобы создать вопросы, касающиеся «каких продуктов это касается и в чем основная проблема». Вопросы сохранялись только в том случае, если суждения двух различных моделей учителей совпадали с оригинальными метками, заполненными потребителями.
Чтобы сделать обучение более эффективным, восстановленные тестовые задания также будут специально включать пару ловушек.
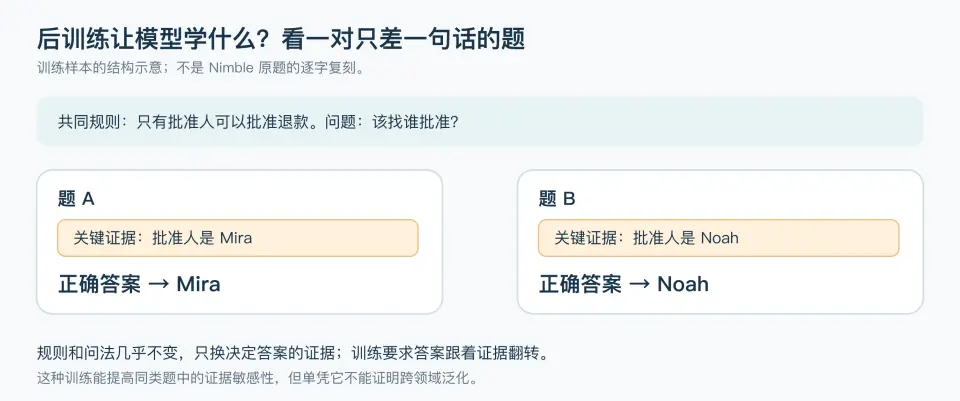
Например, правила двух вопросов абсолютно идентичны, но изменяется одно ключевое имя (например, подписант меняется с уполномоченного Mira на неуполномоченного Noah), и ответ просто переворачивается. Такие вопросы эффективно предотвращают запоминание ответов моделью через Reward Hacking, заставляя ее честно работать над глубокими представлениями и связями между вопросами и вариантами ответов.
Достаточно ли метода обучения LoRA с дистилляцией?
В настоящее время практически все воспроизведения методов постобучения используют метод «LoRA + дистилляция учителя» для повышения вероятности правильного выбора.
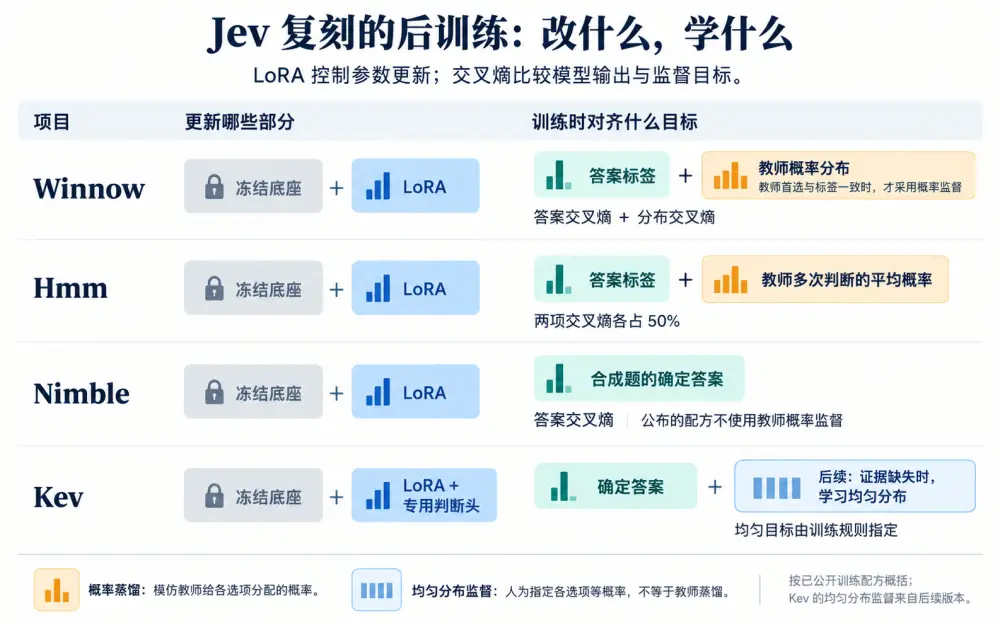
Например, Winnow выбрал провести тонкую настройку LoRA на модели Gemma 4 12B. Действие LoRA заключается в том, чтобы сохранить исходные веса базы, обучая небольшую часть корректирующих параметров, участвующих в вычислениях, что снижает стоимость модификации модели.
Winnow одновременно использует два типа надзора. Один предоставляет стандартный ответ, требуя от модели повысить вероятность правильного выбора. Другой предоставляет распределение вероятностей для всех вариантов от учителя, позволяя студенту приближаться к этому распределению. Только когда первый выбор, выбранный учителем, совпадает со стандартным ответом, Winnow применяет второй тип надзора.
Оба метода вычисляют ошибку обучения через перекрестную энтропию. Перекрестная энтропия здесь отвечает за проверку того, насколько неправильно студент распределил вероятности. Чем ниже вероятность правильного выбора, тем больше наказание.
При использовании распределения учителя обучение будет побуждать студента имитировать распределение учителя по каждому варианту. Например, если учитель распределяет 80%, 15% и 5% для A, B и C соответственно, студенту будет предложено изучить различия между этими тремя вариантами.
В общем, LoRA, дистилляция и перекрестная энтропия уже достаточно для задач, где подготовлены вопросы, ответы и эталонное распределение (например, такие задачи, как предсказание вероятности), поскольку они изучают только вероятность.
Но дистилляция на самом деле изучает вероятность учителя, а не реальную вероятность, о которой говорит RCLD. Как преодолеть разрыв, используя факты / пропорции учителя, в текущем воспроизведении также нет четкой идеи.
Теоретически, чтобы реализовать утверждение Jev, необходимо полагаться на более крупные объемы данных и более эффективные способы обучения.
Конечно, если такой маленькой модели суждений удастся достичь точности больших моделей, то это будет очень полезно, даже если проблема не решена.
Калибровка, возможно, остается секретным оружием
Кроме того, у Jev есть еще одно секретное оружие — это его заявленная способность к калибровке.
Количество правильных ответов модели не всегда соответствует тому, насколько точно она выражает уверенность. Одна модель может ответить правильно на 70%, но всегда сообщать о 90% уверенности.
Чтобы проверить, не является ли Jev слепо самоуверенным, Archer Hume провел «эксперимент с детектором лжи».
Он сначала дал Jev 1200 вопросов теста MMLU (масштабное многозадачное понимание языка), а затем разделил все выбранные ответы по вероятности, сообщаемой системой, на десять уровней. После сложных взвешенных расчетов ошибка калибровки Jev составила всего 0.031.
В 30 простых задачах на умножение Jev ответил правильно на 86.7%, а его средняя уверенность составила 83%, что очень близко. Когда вопросы стали сложнее, например, «двухшаговые задачи», его точность упала до 32%, что важно, его средняя уверенность также снизилась до 30%.
В этом отношении постобучение действительно может улучшить вероятностные показатели, но часто делает модель более слепо самоуверенной.
Чтобы восстановить более точную способность калибровки Jev, в воспроизводимой версии были использованы некоторые методы. Например, Kev четко требует от модели снижать уверенность в случае отсутствия доказательств. Он добавляет в обучающий набор образцы с удаленными ключевыми доказательствами, а затем снижает их вероятности в ответах, таким образом модель будет наказана за безосновательное сосредоточение вероятности на каком-либо варианте.
Однако многие воспроизведения делают лишь временную калибровку температуры.
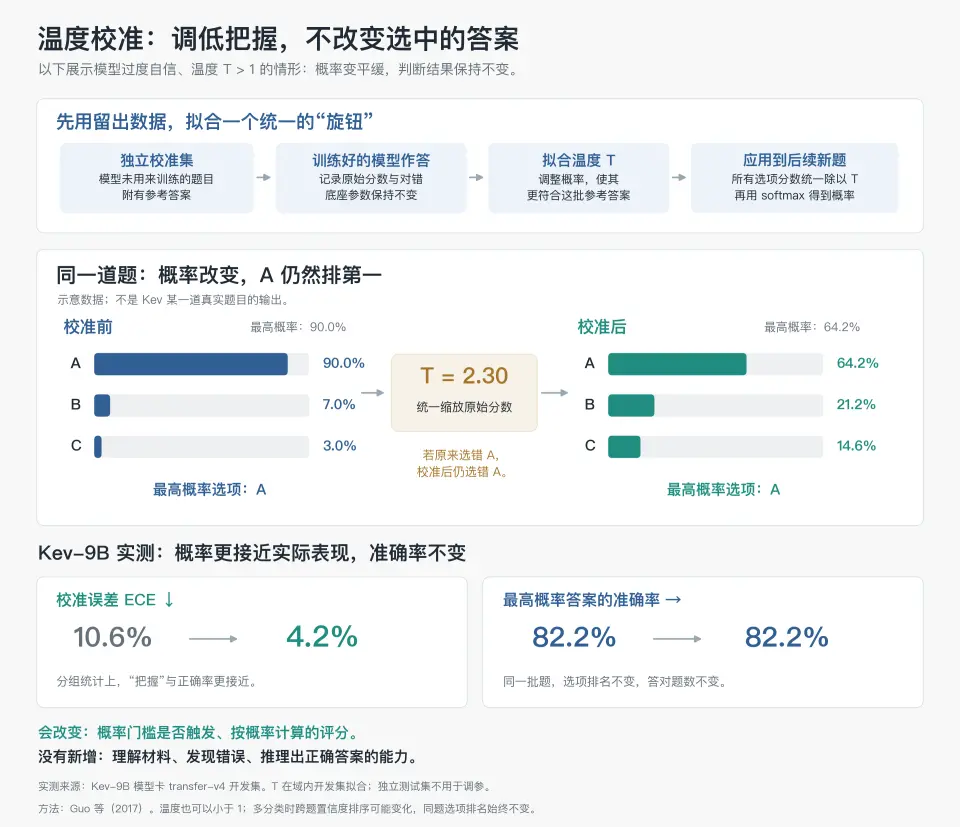
Инженеры берут небольшую партию тестовых вопросов, с которыми модель не сталкивалась, и дают их обученной модели. Если модель проявляет чрезмерную уверенность, система рассчитывает, насколько следует снизить общую уверенность на основе этой партии вопросов.
Как только ручка настроена, модель будет вынуждена надевать «скромный фильтр» при выводе вероятностей, превращая их в более сглаженные значения.
Это не изменит порядок вариантов ответов на один и тот же вопрос, поэтому ответ с наивысшей вероятностью останется прежним. Но порог вероятности и оценки, основанные на вероятности, могут измениться.
Этот метод все еще довольно эффективен. Например, после калибровки температуры у Kev-9B ошибка калибровки снизилась с примерно 10.6 процентных пунктов до 4.2 процентных пунктов, при этом количество правильных ответов не изменилось.
Говорить, что это временное решение, можно потому, что оно на самом деле основано на снижении общей уверенности, а не на более точном различении того, следует ли быть уверенным.
Если предположить, что Jev действительно достиг эффективного повышения уровня калибровки, то, возможно, у них действительно есть некоторые секреты.
04
Каковы реальные границы применения Jev?
Jev, безусловно, имеет практическое значение. Он возвращает задачи, которые изначально требовали быстрой оценки, к самой быстрой оценке.
В процессе работы агента запросы на классификацию и маршрутизацию, сортировку результатов поиска и множество четко определенных проверок являются местами, где Jev может проявить себя.
Например, распределение клиентских запросов, классификация товаров, анализ отзывов, аннотирование данных — это все высокочастотные сценарии, с которыми мы сталкиваемся в повседневной работе.
Но насколько велики его границы применения, определяет, является ли он тем, что он утверждает, обладая парадигмальной ценностью.
Согласно текущим бенчмаркам, он действительно относительно универсален. Команда Nimble протестировала фактическую проверку, маршрутизацию намерений, семантическое содержание, проверку контента, медицинские вопросы и другие задачи с использованием 13 групп, в общей сложности 3,880 открытых данных, и средняя точность Jev по наборам данных составила 76.0%.
Это говорит о том, что Jev действительно может выполнять множество задач по суждению.
Но настоящая универсальность сталкивается с двумя препятствиями.
Первое — это сложные задачи. Если он может выполнять только простые суждения, его область применения будет очень ограничена.
Сначала нам нужно определить, что такое сложность в суждениях. Обычно мы считаем, что чем больше шагов, условий и деталей, требующих понимания, тем сложнее вопрос.
Определить «пользователь хочет вернуть деньги» требует лишь понимания буквального смысла, но решить «должен ли этот возврат быть одобрен» требует проверки дат, расчета сроков и сравнения приоритетов условий, что явно сложнее. А если для достижения результата требуется три шага рассуждений, то третий шаг зависит от результата второго шага, что создает зависимость между многошаговыми процессами. Если на первом шаге была допущена ошибка в политике, последующие расчеты, даже если они полностью верны, в конечном итоге приведут к ошибочному суждению.
В тестировании сложных вопросов JevBench установил некоторые факторы, связанные со сложностью вопросов, включая многокритериальные суждения, последовательный поиск доказательств, сравнение дат и чисел. В этой группе вопросов точность многошагового поиска Jev составила 85.7%, сложные суждения по политике — 60.5%, а суждения по времени и числам — всего 26.7%, что значительно уступает моделям уровня Flash. В сложных вопросах Jev ответил правильно на 74.1%, в то время как DeepSeek V4.1 Flash — на 95.0%, что сопоставимо с уровнем человеческих экспертов.
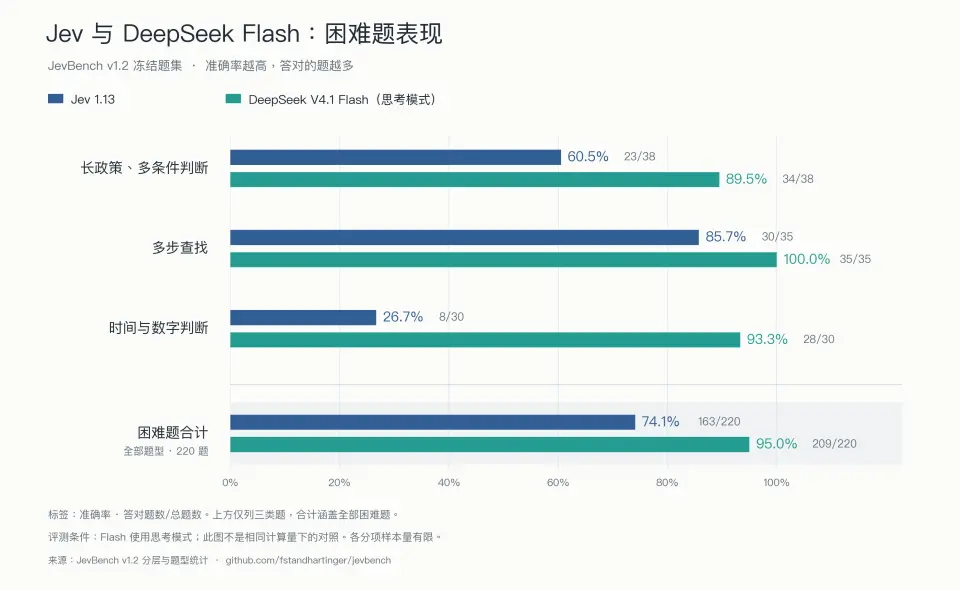
Хотя среднее время обработки соответствующих запросов составляет около 0.67 секунд и 3.15 секунд, скорость Jev почти в четыре раза быстрее. Но такая большая разница в точности делает выбор очевидным для некоторых сложных задач (например, для желаемой торговли акциями).
Кроме того, точность многошагового поиска здесь не является многошаговым рассуждением, в основном это связано с поиском. В тестировании Archer Hume Jev показал точность 86.7% в простых задачах на умножение, но когда речь зашла о двухшаговых задачах, точность резко упала до 32%.
Briantrust провел более детальную оценку и также выявил недостатки Jev в сложных вопросах. Он сравнил Jev и модель GPT 5.6 Luna, заставляя модель выбрать правильный ответ из двух кандидатных ответов, в итоге сравнив 616 пар действительных вопросов. Разница между двумя моделями в знаниях составила всего 1.6 процентных пункта, но в математике и рассуждениях она увеличилась до 19.3 процентных пункта, а в коде — до 20 процентных пунктов.
Таким образом, преодолеть препятствие сложных суждений Jev будет сложно.
Другим препятствием является обобщение.
Если Jev действительно универсален, он должен быть способен к хорошему обобщению, повышая точность суждений по другим вопросам на основе того, что он изучил.
В противном случае он просто будет немного более универсальной «специальной моделью суждений», не отличаясь от предыдущих моделей.
Существующие многофункциональные прямые тесты могут подтвердить, что Jev действительно обладает определенной способностью к обобщению, но эта способность крайне нестабильна в пределах области. Как только он выходит за пределы знакомых сценариев, его производительность по-прежнему сталкивается с огромными рисками.
Во-первых, в условиях абсолютно одинаковых задач и фактов суждения Jev легко подвержены влиянию способа представления информации. В эксперименте OpenProse, не меняя никаких фактов, вопросов и объема вычислений, когда ключевые отношения сосредоточены в начале текста, точность Jev составляет 80.5%, но когда эти отношения перемещаются в середину, точность резко падает до 40.9%.
Это показывает, что даже без изменения области бизнеса устойчивость представления Jev серьезно недостаточна. Его способность к суждению сильно зависит от того, как внешние программы предоставляют ему данные.
Во-вторых, когда Jev сталкивается с новыми вопросами в рамках одной и той же системы оценки, его производительность также значительно колеблется. В новой версии JevBench v1.4 добавлено 308 закрытых сложных вопросов, и точность Jev упала с 86.6% на открытых вопросах до 36.7%. В качестве сравнения, модель DeepSeek V4.1 Flash, использующая режим размышлений, сохранила точность на уровне 94.8%.
Высокие баллы, которые Jev ранее получил на открытых вопросах, не могут автоматически переноситься на неизвестные сложные тесты.
Когда тестирование продвигается к реальной бизнес-миграции, результаты Jev также вызывают смешанные чувства. Положительный пример приходит от обнаружения инъекций подсказок в Agent Journal, где точность Jev на исходном тестовом наборе составила 83.65%, а при прямой миграции на другой тестовый набор, содержащий более двух тысяч внешних данных, точность даже возросла до 95.58%, что значительно превышает традиционную базовую модель.
Это говорит о том, что в некоторых специфических задачах он действительно может адаптироваться к изменениям источников данных.
Но в более сложных логических бизнесах такая обобщаемость часто оказывается неэффективной. Scarif Labs использовал его для определения, безопасно ли обновление программного обеспечения. Когда модель была перенесена из одной программной экосистемы в другую, способность Jev различать безопасные и опасные обновления (AUROC) упала с 0.851 до 0.605 (близко к случайному угадыванию 0.5).
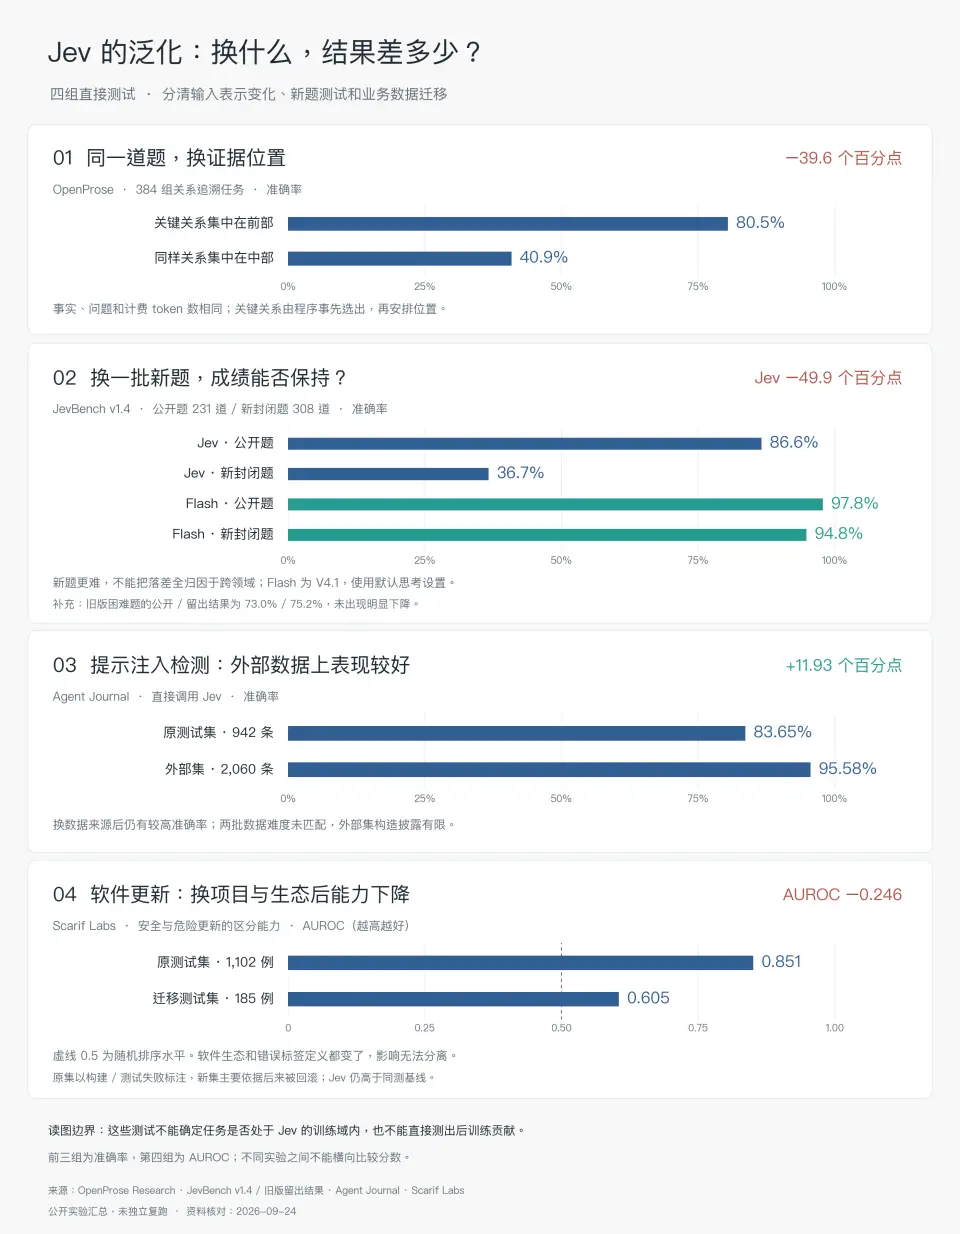
Таким образом, можно сказать, что на данный момент обобщаемость Jev должна быть довольно ограниченной и сомнительной. Он далек от стандартов универсальной обобщаемости.
Поскольку Jev не преодолел эти два барьера универсальности, где же нам сейчас следует его использовать?
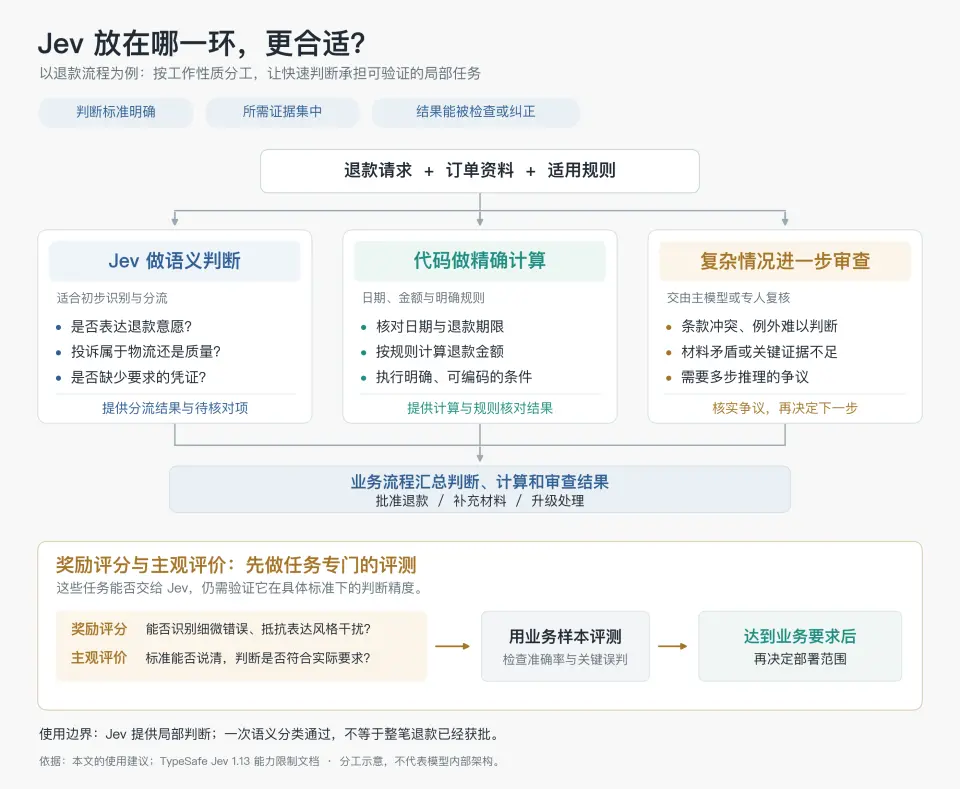
Более подходящая позиция — разместить Jev в этапах с четкими стандартами, сосредоточенными доказательствами и проверяемыми или корректируемыми результатами.
Все еще на примере возврата. Определение, выразил ли пользователь желание вернуть товар, касается ли жалоба логистики или качества товара, нужно ли предоставить дополнительные доказательства — все это можно проверить отдельно. Эти вопросы возникают часто, обычно не требуют генерации объяснений и не обязательно требуют от основного модели развертывания рассуждений. Jev может взять на себя первичную сортировку.
Но для одобрения возврата ситуация меняется. Нужно ли учитывать срок, необходимо проверить дату и сумму возврата, нужно рассчитывать по правилам, сталкиваться с конфликтами условий или исключительными ситуациями, и проводить дальнейшую проверку. TypeSafe также рекомендует передать математические операции и сравнение дат коду и по возможности минимизировать многослойные зависимости в суждениях.
Такое разделение труда позволяет использовать его скорость в подходящих местах.
Что касается более точных применений, таких как модели вознаграждений, то часто необходимо оценивать именно те ответы, которые на первый взгляд разумны, но на самом деле ошибочны. Модель также должна различать тонкие различия и противостоять влиянию стиля выражения.
А для задач, где правила трудно определить, например, содержащих сравнительно субъективные оценки, по крайней мере, стоит сначала проверить точность Jev, прежде чем развертывать его.
В это время Jev может быть кандидатом, но пользователи все равно нуждаются в специализированной оценке задач.
Кроме того, есть один аспект, который нельзя упустить. Быстрая реакция Jev не означает, что вся система Agent станет быстрее с его добавлением.
Если он может заранее обработать партию простых запросов, позволяя этим запросам не вызывать основную модель, то скорость и преимущества по затратам могут быть реализованы.
Но если каждый раз сначала вызывать Jev, а затем все равно вызывать ту же основную модель, то новые суждения должны сэкономить достаточно последующей работы, чтобы компенсировать свои временные и финансовые затраты.
В наборе экспериментов по извлечению памяти Agent на GitHub система внедрила Jev для определения, полезна ли извлеченная информация. Чтобы избежать того, чтобы Jev ошибочно отбрасывал полезную информацию, разработчикам пришлось многократно корректировать критерии суждения.
Хотя в конечном итоге все 20 обычных случаев были одобрены, цена была ясна: общее время задержки системы увеличилось с 649 миллисекунд до 1087 миллисекунд, а стоимость за тысячу вызовов удвоилась.
Если основная модель уже обладает способностью фильтровать ответы из сложных материалов, то добавление Jev в качестве судьи не только увеличивает время ожидания, но и несет риск упустить ключевые доказательства из-за ошибочного суждения.
05
Насколько действительно революционен Jev?
В конце обсуждения главный вопрос, который оставляет нам Jev, заключается в том, чему он на самом деле учится?
По идее, модель, предназначенная для суждений, должна учиться представлениям, чтобы делать эффективные суждения на основе новых фактов.
Это почти одно из самых сложных представлений.
Универсальные суждения требуют одновременного использования множества способностей, и нельзя считать, что, поскольку в конце выводится только одна вероятность, это легче, чем генерировать ответ.
Возьмем пример с возвратом. Увидев «Я хочу вернуть товар», распознавание желания возврата в основном зависит от понимания языка. Но когда спрашивают: «Согласно этой политике, следует ли одобрить возврат?», модель должна понять политику, сопоставить дату покупки, состояние товара и другие факты с конкретными условиями, а затем обработать исключения.
Это, по сути, базовая способность языковой модели, стоящей за Jev.
Последний вопрос «Поможет ли возврат удержать этого клиента?» требует предсказания последствий поведения. Это и есть часть, которую модель должна обучить.
Ей нужно научиться, какие факты влияют на результат, при каких условиях они влияют и сохраняются ли эти отношения в другой ситуации.
Все три вопроса могут выводить «вероятность да», но необходимые знания и вычисления различаются.
Чтобы преодолеть расстояние от «предсказания, как другие будут судить» до «надежного предсказания последствий действий», сколько данных и обучения нам на самом деле нужно?
По крайней мере, для человека комплексное суждение — это самая трудная вещь для изучения. Это по сути так же сложно, как упомянутое в нашей предыдущей статье о вкусе и комплексных утилитарных расчетах.
Поэтому я очень сомневаюсь, что эта раскрытая в статье методика обучения может вместить такое сложное представление.
Конечно, мы можем рассматривать Jev как крайне изобретительный инженерный инструмент.
В бизнес-процессах с ясными правилами и полными материалами он может значительно сократить время ожидания и затраты на вычисления, его ценность не подлежит сомнению.
Но прежде чем доказать, что он действительно усвоил какие-то универсальные правила суждения, рано наделять его короной «парадигмальной революции».
 Предупреждение о рисках
 Предупреждение о рисках
Популярные статьи





