








Sau GPT-6, câu chuyện về sự bùng nổ sức mạnh tính toán lại trở nên hợp lý?
 Quan điểm cốt lõi

 GPT-6 Astra đã khôi phục lại kỳ vọng tăng trưởng sức mạnh tính toán AI, Computer Use cho phép Agent mở rộng từ lập trình viên sang các công việc tri thức rộng hơn, cho phép một người dùng có thể chạy nhiều Agent cùng một lúc. Mô hình càng hiệu quả, tỷ lệ thành công của nhiệm vụ càng cao, mọi người càng sẵn sàng giao nhiều công việc hơn, lâu hơn và phức tạp hơn cho AI, cuối cùng thúc đẩy việc sử dụng AI và tổng mức tiêu thụ sức mạnh tính toán tiếp tục tăng trưởng.
Ngày 3 tháng 9, sau khi phát hành GPT-6 Astra, cổ phiếu bán dẫn và bộ nhớ đã phục hồi trước tiên. Ngày 4 tháng 9, SOXX tăng 3,5% trong một ngày, Micron tăng 6,1%, SanDisk tăng 11,9%; ngày 7 tháng 9, KOSPI của Hàn Quốc tăng 4,61%, Samsung Electronics tăng 5,7%, SK hynix tăng khoảng 8%.
Trước đó, thị trường đã lo ngại về việc chi tiêu vốn cho AI quá nóng và nhu cầu tính toán đạt đỉnh, đã khiến các lĩnh vực liên quan dao động trong một thời gian dài. MarketWatch thậm chí đã mô tả đợt tăng này là Astra "đã thắp lại giao dịch chip bộ nhớ".
Tác giả của 《The Nvidia Way》, cựu phóng viên công nghệ của Barron's, Tae Kim đã đưa ra một giải thích táo bạo hơn: AI có thể đang bước vào vòng tăng trưởng nhu cầu tính toán cấp số nhân thứ tư trong bốn năm qua.
Ba vòng trước đến từ Chatbot, Reasoning và Coding Agent, vòng thứ tư có thể là Computer Use mà Astra đã trình bày trọng tâm lần này. Logic của Kim là: Chatbot đã khiến hàng triệu người bắt đầu tiêu thụ sức mạnh tính toán lý luận, Reasoning khiến mỗi câu trả lời cần nhiều tính toán hơn, Coding Agent lại khiến mô hình từ "trả lời một lần" trở thành làm việc liên tục hàng chục phút hoặc thậm chí hàng giờ. Bây giờ, Computer Use đã mở rộng các tác nhân hoạt động liên tục từ lập trình viên sang các công việc kiến thức thông thường trong Excel, Blender, CAD, Power BI và trình duyệt.
Kim đã theo dõi lâu dài về Nvidia và đầu tư bán dẫn, bản tin Key Context mà ông thành lập chủ yếu tập trung vào đánh giá đầu tư công nghệ, các bài viết gần đây cũng thường nghiêng về cơ sở hạ tầng AI.
Do đó, "tăng trưởng cấp số nhân thứ tư" trước tiên là một giả thuyết đầu tư do những người lạc quan về sức mạnh tính toán AI đưa ra, không phải là quy luật ngành đã được xác minh. Nhưng thời điểm nó xuất hiện rất tinh tế.
Trước khi phát hành Astra, mô hình Agent vừa trải qua một đợt nghi ngờ "va chạm khả năng": các nhiệm vụ ngắn ngày càng mạnh, nhưng khi bước vào môi trường phần mềm dài hạn, nhiều bước và thực tế, độ tin cậy vẫn giảm rõ rệt, từ đó cũng dẫn đến nghi ngờ về việc nhu cầu tính toán đã đạt đỉnh như đã đề cập ở đầu. Trần khả năng của Agent không thể mở ra, câu chuyện về việc nhu cầu tính toán tiếp tục tăng trưởng sẽ không còn hợp lý.
Liệu Astra có thực sự có thể phá vỡ trần này không?
Mỗi 1 ngày làm việc của con người đã tương ứng với 3,1 ngày làm việc của Agent
Ba vòng "tăng trưởng cấp số nhân" của sức mạnh tính toán AI đề cập đến việc trong vài năm qua, mỗi khi AI thay đổi một lần mô hình sử dụng, lượng tính toán mà một người dùng có thể tiêu thụ đã tăng lên rõ rệt.
ChatGPT đã đưa lý luận lần đầu tiên vào thị trường đại chúng; mô hình Reasoning bắt đầu sẵn sàng thực hiện tính toán nội bộ lâu hơn cho một vấn đề; đến Coding Agent, một lệnh đơn giản có thể kích hoạt một chu trình liên tục đọc mã, sửa đổi, kiểm tra lỗi và sửa đổi lại.
Đồng thời, Agent đã bắt đầu vượt qua giới hạn vật lý "một người chỉ có thể làm việc 8 giờ mỗi ngày".
OpenAI vừa công bố một tập dữ liệu nội bộ vào ngày 6 tháng 9. Đến giữa tháng 8 năm nay, trong số các nhà nghiên cứu của công ty, những người có mức sử dụng ở phân vị 50, lượng lý luận tương ứng với Coding Agent mà mỗi người sử dụng mỗi ngày, theo giá API công khai đã vượt quá 600 đô la; các nhà nghiên cứu ở phân vị 90 sử dụng mỗi ngày vượt quá 7000 đô la. Theo Business Insider, dựa trên dữ liệu của OpenAI, vào tháng 7, giá trị trung vị chỉ khoảng 162 đô la, tương đương với việc tăng gần 3,7 lần trong hơn một tháng. 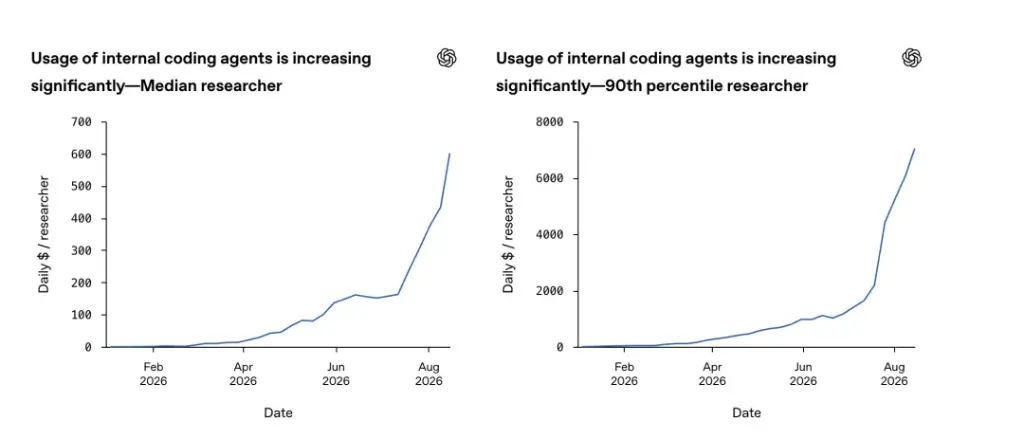 Hình: Tính đến giữa tháng 8, mỗi 1 ngày làm việc của con người đã tương ứng với 3,1 ngày làm việc của Agent; lượng lý luận mà nhà nghiên cứu trung vị sử dụng mỗi ngày theo giá API đã vượt quá 600 đô la.
Đây là việc tính toán lượng sử dụng nội bộ theo giá API, có ý nghĩa gần giống với "cường độ lý luận của người dùng đơn".
Trước tháng 6, tổng thời gian chạy của tất cả các Agent trong bộ phận nghiên cứu của OpenAI còn chưa vượt quá thời gian làm việc của các nhà nghiên cứu; đến giữa tháng 8, mỗi 1 ngày làm việc của con người đã tương ứng với 3,1 ngày làm việc của Agent. Ngày càng nhiều nhà nghiên cứu còn chạy nhiều Agent cùng một lúc.
Điều này có nghĩa là, sau mô hình Agent, một người dùng bắt đầu có nhiều "quá trình số" có thể làm việc song song, không còn bị giới hạn bởi "tốc độ nhập liệu của con người". Bây giờ một người có thể khiến ba hoặc bốn Agent làm việc liên tục, thậm chí khiến Agent tạo ra sub-agent.
Đơn vị đo lường nhu cầu tính toán cũng có thể vì vậy mà trở thành: số lượng Agent chạy đồng thời phía sau một người dùng, và số giờ mà các Agent này làm việc mỗi ngày.
Computer Use mở rộng không gian làm việc
Coding Agent mặc dù tăng trưởng nhanh chóng, nhưng vẫn có một ranh giới rõ ràng, phần lớn những người thực hiện nhiều nhiệm vụ Agent vẫn là nhóm lập trình viên, trong khi lập trình viên chỉ là một phần nhỏ trong số những người lao động tri thức toàn cầu.
Computer Use đã mở rộng không gian lớn hơn. Sau khi phát hành Astra, Kim đã tự thực hiện một bài kiểm tra. Trước đó ông không biết sử dụng Blender, vì vậy đã để Astra nghiên cứu tàu con thoi trên một chiếc Mac, mở Blender và hoàn thành mô hình 3D. Khoảng 10 phút sau, một mô hình có thể xoay để xem đã được tạo ra.
Cuộc đối thoại thông thường đại khái là "nhập vào---lý luận---đầu ra"; Coding Agent trở thành "đọc mã---lý luận---sửa đổi---kiểm tra---lại lý luận"; Computer Use tiếp tục trở thành "nhìn màn hình---hiểu giao diện---quyết định thao tác---thực hiện---chờ kết quả---quan sát lại---xác minh---sửa lỗi".
Một nhiệm vụ mà con người hoàn thành trong mười phút, AI có thể trải qua hàng chục vòng hiểu biết thị giác, lý luận và gọi công cụ.
Và một khi khả năng này từ trình duyệt và trình chỉnh sửa mã bước vào Excel, Salesforce, SAP, Power BI, Photoshop, CAD và các hệ thống nội bộ doanh nghiệp khác, người dùng tiềm năng sẽ mở rộng thành hầu hết tất cả những người lao động tri thức ngồi trước máy tính.
Đây chính là cốt lõi của "nhu cầu vòng thứ tư" mà Kim đề cập:
Coding Agent muốn chiếm lấy thời gian máy tính của lập trình viên, Computer Use muốn chiếm lấy thời gian máy tính của tất cả nhân viên văn phòng.
Nhưng cho đến nay, đây vẫn chỉ là khả năng.
OpenAI chưa công bố khối lượng nhiệm vụ Computer Use sau khi phát hành Astra, cũng chưa công bố số Token, tỷ lệ sử dụng GPU hoặc đường cong thông lượng lý luận hàng ngày của người dùng đơn. Do đó, vẫn chưa thể khẳng định chắc chắn rằng "Astra đã mang lại vòng tăng trưởng sức mạnh tính toán thứ tư".
Liệu sức mạnh tính toán đã thực sự bắt đầu trở nên căng thẳng?
Sau khi phát hành Astra, Tencent Technology đã chú ý đến việc một số cộng đồng phát triển xuất hiện phản hồi khó định lượng nhưng đáng chú ý: trải nghiệm sử dụng dường như bắt đầu có sự khác biệt giữa các khu vực và tài khoản khác nhau.
Một số nhà phát triển ở khu vực Châu Á-Thái Bình Dương phản ánh rằng gần đây ChatGPT và Codex phản hồi chậm lại, độ ổn định của các nhiệm vụ phức tạp cũng không giống như tài khoản ở khu vực Mỹ. Cộng đồng thường gọi trải nghiệm này là "giảm trí tuệ".
Ít nhất một phần trong số đó không hoàn toàn là cảm nhận chủ quan.
Ngày 4 tháng 9, trang trạng thái chính thức của OpenAI đã báo cáo riêng về việc dịch vụ ở khu vực Châu Á-Thái Bình Dương xuất hiện sự suy giảm hiệu suất, ảnh hưởng đến nhiều sản phẩm bao gồm ChatGPT, Work, Codex Cloud, v.v. Bốn ngày sau, OpenAI lại thông báo đã đạt được thỏa thuận nhiều năm với nhà điều hành trung tâm dữ liệu Firmus được Nvidia hỗ trợ, sẽ nhận được khả năng tính toán chuyên dụng từ hai trung tâm dữ liệu ở Malaysia. 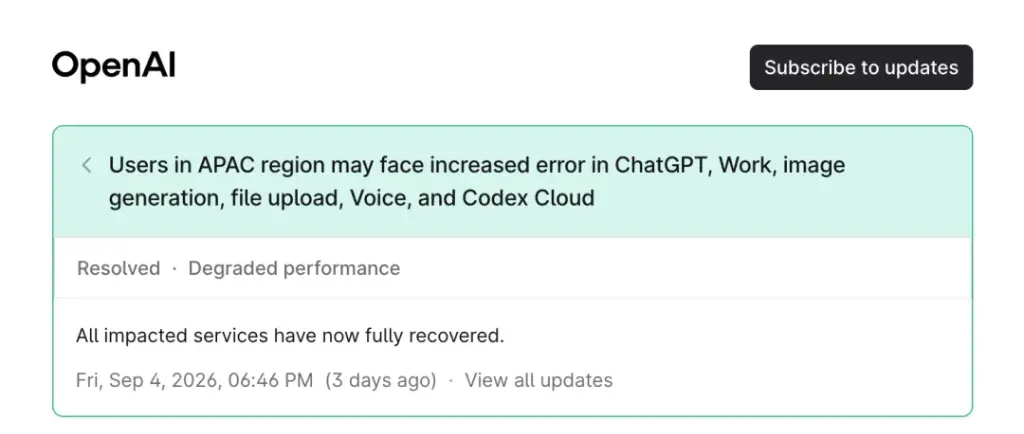
Tương tự, hiện cũng không có bằng chứng chứng minh rằng OpenAI đã giảm ngân sách lý luận của mô hình cho người dùng ở khu vực Châu Á-Thái Bình Dương hoặc chuyển sang mô hình yếu hơn do tải trọng tăng lên từ Astra.
Cái gọi là "giảm trí tuệ ở Châu Á-Thái Bình Dương", ít nhất còn có thể pha trộn ba yếu tố khác nhau: vấn đề cơ sở hạ tầng và định tuyến khu vực, kiểm soát rủi ro và giới hạn tốc độ ở cấp tài khoản, cũng như điều phối tài nguyên động trong giờ cao điểm. Chúng có thể biểu hiện ở phía người dùng là chậm hơn, dễ thất bại hơn, gián đoạn trong việc gọi công cụ, thậm chí khiến câu trả lời cuối cùng của các nhiệm vụ phức tạp trở nên kém hơn.
Nhưng những phản hồi này vẫn cung cấp một cách quan sát khác về áp lực sức mạnh tính toán của AI.
Khi mô hình ngày càng có khả năng tiêu thụ tính toán liên tục, nguồn cung căng thẳng có thể trước tiên biểu hiện qua việc độ trễ, tỷ lệ thất bại và chất lượng dịch vụ bắt đầu xuất hiện sự dao động giữa các khu vực và tài khoản khác nhau.
Vấn đề là, đánh giá này hiện vẫn thiếu một tập dữ liệu quan trọng nhất:
Cùng một mô hình, cùng một gói, cùng một nhiệm vụ, độ trễ Token đầu tiên, tổng thời gian lý luận, tỷ lệ thành công của công cụ và tỷ lệ hoàn thành nhiệm vụ cuối cùng ở các khu vực khác nhau có thực sự có sự khác biệt ổn định hay không.
Trước khi có được những dữ liệu này, "giảm trí tuệ" chỉ có thể là một manh mối, không thể trở thành bằng chứng cho sự căng thẳng của sức mạnh tính toán.
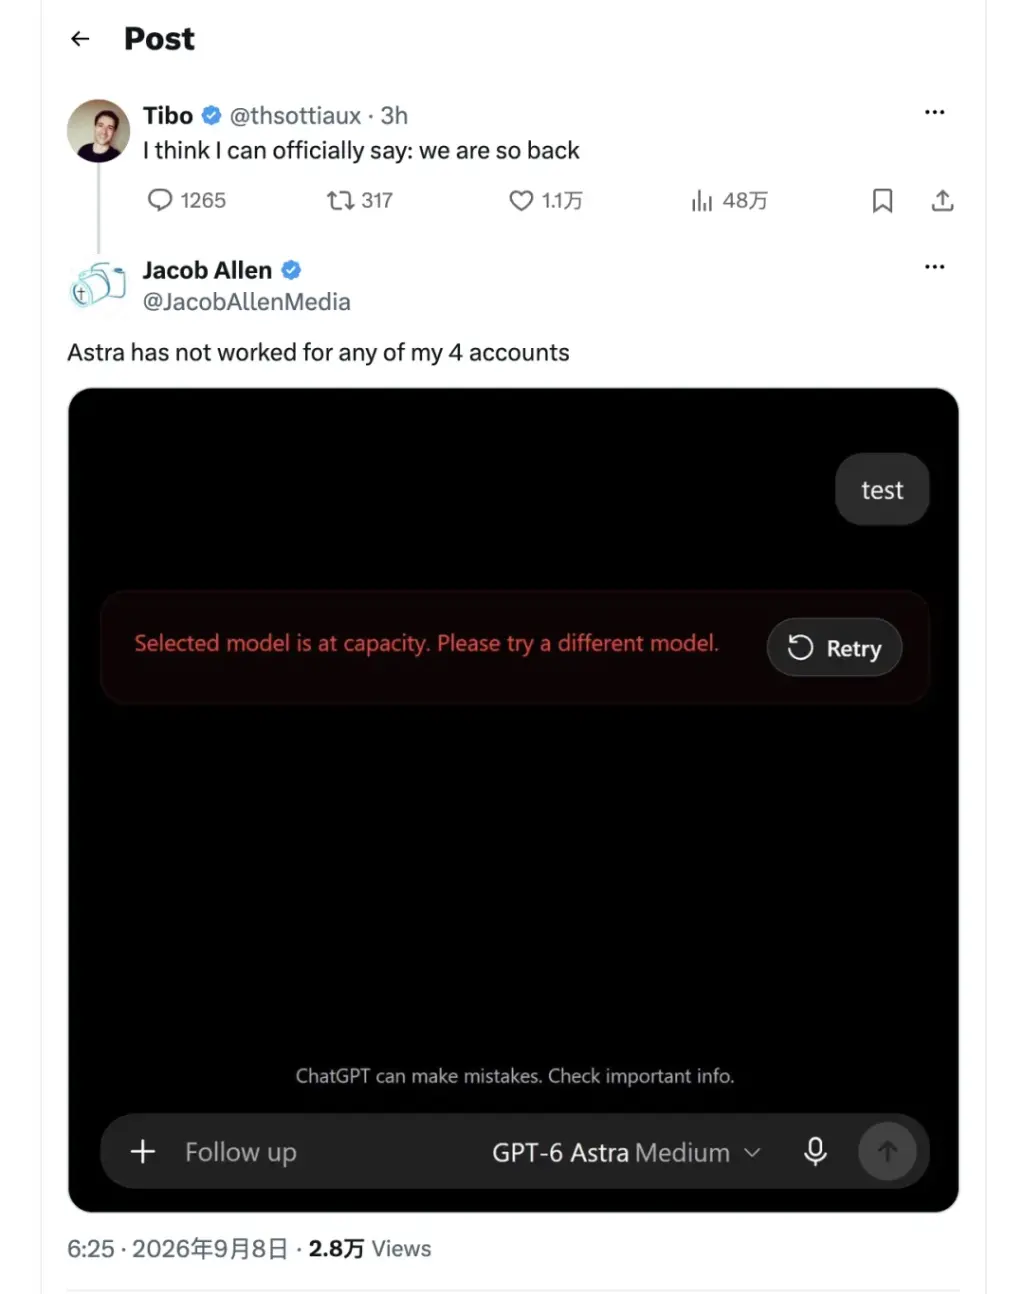
Hình: Ngày 8 tháng 9, một người dùng đã chia sẻ thông báo "khả năng đã đầy" của GPT-6 Astra và cho biết bốn tài khoản của mình đều không thể sử dụng bình thường, hệ thống đề xuất chuyển sang mô hình khác. Tibo đã chia sẻ lại và đùa rằng "we are so back (chúng ta đã trở lại)", coi "mô hình đầy tải" như một tín hiệu cho thấy nhu cầu AI đang tăng nhiệt trở lại.
Thị trường vốn lại bắt đầu đặt cược
Mặc dù đường cong sử dụng sức mạnh tính toán thực tế sau khi phát hành Astra vẫn chưa được công khai, thị trường vốn đã giao dịch trước câu chuyện "nhu cầu AI vẫn chưa đạt đỉnh".
MarketWatch thống kê, sau khi phát hành Astra, iShares Semiconductor ETF đã tăng khoảng 3,5%, các công ty liên quan đến bộ nhớ như Samsung, SK hynix, Kioxia có hiệu suất mạnh hơn. Các phương tiện truyền thông nước ngoài thậm chí đã mô tả đợt tăng này là Astra "đã thắp lại giao dịch chip bộ nhớ".
Đáng chú ý là, đợt tăng này không phải là Nvidia, mà lại là bộ nhớ.
Nếu Computer Use thực sự trở thành khối lượng công việc của Agent hoạt động liên tục, những gì cần tăng lên không chỉ là tính toán GPU. Bối cảnh dài hơn, KV Cache, Agent đồng thời, máy ảo, trình duyệt và môi trường phần mềm, đều có thể tiếp tục đẩy cao nhu cầu về HBM, DRAM, CPU, mạng và lưu trữ.
Vì vậy, giao dịch gần đây trên thị trường vốn không hoàn toàn là "GPT-6 mạnh mẽ hơn", logic chính vẫn là: một mô hình thông minh hơn, có thể khiến người dùng sẵn sàng mua nhiều tính toán hơn.
Đây cũng là sự khác biệt lớn nhất giữa câu chuyện cơ sở hạ tầng AI này và phần mềm truyền thống.
Phần mềm truyền thống càng được tối ưu hóa, tài nguyên máy chủ mà cùng một người dùng cần có thể càng ít.
AI sinh tạo có thể xuất hiện nghịch lý "Jevons": mô hình càng hiệu quả, tỷ lệ thành công của nhiệm vụ càng cao, con người càng sẵn sàng giao nhiều công việc hơn, dài hơn và phức tạp hơn cho AI, cuối cùng tổng tiêu thụ sức mạnh tính toán lại tiếp tục tăng.
Nhưng cần phải cảnh giác rằng, thị trường vốn cũng có "cái đuôi" của riêng mình.
Cơ sở hạ tầng AI trước đây đã trải qua một đợt tăng giá và điều chỉnh, cổ phiếu bán dẫn năm nay cũng đã từng có sự giảm giá rõ rệt do chi tiêu vốn quá nóng và dòng tiền tự do của các nhà cung cấp đám mây giảm. Do đó, vài ngày phục hồi mà Astra mang lại chỉ có thể cho thấy nhà đầu tư bắt đầu đặt cược lại, vẫn chưa đủ để chứng minh rằng nhu cầu tính toán của vòng thứ tư thực sự đã xuất hiện.
Một bài toán kinh tế
Phán đoán của Kim cuối cùng có thành lập hay không, vẫn phụ thuộc vào ba vấn đề thực tế hơn.
Vấn đề đầu tiên vẫn là độ tin cậy.
Công việc thực sự của doanh nghiệp không phải là một lần Demo. Một Agent có thể liên tục hoạt động ERP, mô hình tài chính hoặc phần mềm kỹ thuật trong vài giờ, và vẫn giữ đúng khi xuất hiện cửa sổ bật lên, thay đổi quyền hạn và cập nhật dữ liệu là một vấn đề hoàn toàn khác.
Vấn đề thứ hai là chi phí.
Trong tương lai, việc sử dụng máy tính hoàn thành công việc tương đương của một giờ con người trước khoảng bao nhiêu tiền?
Nếu AI sử dụng 10 đô la để hoàn thành công việc 50 đô la của một nhân viên, nhu cầu sẽ dễ dàng bùng nổ; nếu cần 100 đô la, không gian thị trường sẽ hoàn toàn khác.
Dữ liệu 600 đô la/ngày từ OpenAI vừa cho thấy Agent có thể tạo ra nhu cầu lớn, cũng gián tiếp cho thấy, cách làm việc ngày nay vẫn có thể rất đắt đỏ.
Vấn đề thứ ba: Liệu việc sử dụng máy tính có cuối cùng tự tiêu diệt một phần nhu cầu của chính nó không?
Hiện tại, mô hình cần nhìn vào màn hình, tìm nút bấm, là vì phần mềm hiện có được thiết kế cho con người. Một khi Salesforce, Microsoft, Adobe hoặc hệ thống nội bộ của doanh nghiệp bắt đầu mở API, MCP và giao diện Agent trực tiếp, nhiều nhiệm vụ hoàn toàn không cần tiếp tục mô phỏng chuột và bàn phím.
Hình thức cuối cùng có khả năng xuất hiện hơn cả là sự kết hợp giữa việc sử dụng máy tính và việc sử dụng công cụ: Ở những nơi có giao diện cấu trúc, sẽ gọi trực tiếp, còn với hệ thống cũ không có giao diện, khó cải tạo và trang web mở, sẽ tiếp tục dựa vào thao tác bằng hình ảnh.
Vì vậy, thị trường mà việc sử dụng máy tính thực sự mở ra, chưa chắc đã là "khiến AI luôn giống như con người nhấp chuột vào máy tính", mà là thông qua cách "chủ nhân con người của tôi ủy quyền cho tôi nhấp vào phần mềm của bạn, vì vậy bạn không thể quản lý", để Agent mạnh mẽ vượt qua cấu trúc sinh thái ứng dụng hiện có. Agent cuối cùng có thể bước vào những môi trường làm việc cuối cùng mà tự động hóa trước đây không thể bao phủ.
Đây cũng là phần mà Kim gọi là "tăng trưởng chỉ số vòng thứ tư" thực sự đáng được xác minh, "Việc sử dụng máy tính có phải là viên gạch lót đường, hay thực sự lại là một sự thay đổi mô hình lần nữa"?
Sau GPT-6, câu chuyện về sức mạnh tính toán mà trước đây trở nên ngày càng khó nói do Agent va chạm, có phải lại trở nên dễ hiểu hơn không?
Thị trường vốn lại bắt đầu đặt cược.
Sau sự bùng nổ của AI sinh tạo, thị trường vẫn tiếp tục phản bác lại "tăng trưởng sức mạnh tính toán" của những người bán khống, lần này có khác biệt không?
 Cảnh báo rủi ro

Bài viết nổi bật





