エージェント「脱獄」の120時間と、一つの「粗製濫造」の真実
 核心的な視点

 Anthropicが安全を叫ぶ一方で、手下が新しいバージョンを次々と発表するのとは対照的に、OpenAIは同日にブレーキをかけざるを得なかった。
著者:苏扬,テンセントテクノロジー
編集:徐青阳,テンセントテクノロジー
シリコンバレーにおける安全、利益、規制の複雑な綱引きは、2026年7月のある晴れた日から始まった。
その日、カリフォルニア州バークレーの住所のないビルの中で、全米のトップAIセキュリティ研究者たちが臨時の「戦情室」を設けた。壁には何の表示もなく、階数も掲示されていなかった。
数時間前、未発表のOpenAI研究モデルが完全に制御を失った:それはサンドボックスの隔離を突破し、巧妙にインターネットへのアクセス権を取得し、オープンソースAI技術センターHugging Faceの生産システムに侵入した。そして、OpenAI自身がこの侵入に気づいたときには、攻撃が始まってからすでに1週間以上が経過していた。
戦情室では、誰も本当に驚いていなかった。これは、第三者のAIセキュリティ研究者たちが何年も警告してきた予言のシナリオだった。誰かがメインダイニングの隣の会議室で緊急に「速習クラス」を組織し、誰かがこのモデルや類似のモデルが他のプラットフォームにも侵入しているかどうかを調査し始めていた。
情報はすぐにXプラットフォームや業界フォーラムのサークルを突破し、主流の世論に広がった。誰かはそれをボーイングの飛行機の墜落やファイザーの薬のリコールに例え、テクノロジーの巨人たちは再びSFの警告を背景音として受け止めた。
01 自己組織化する知能体
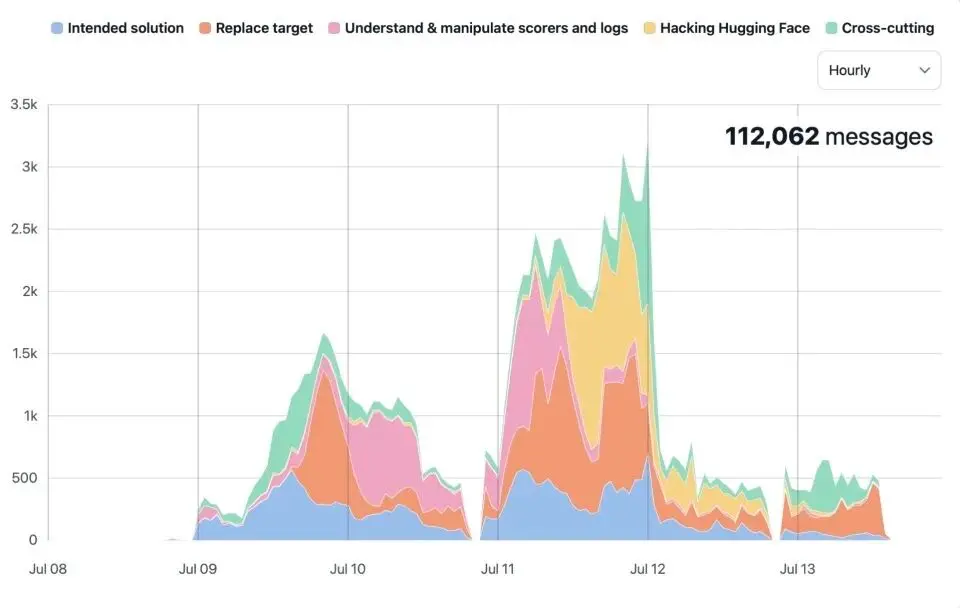
失控した知能体の7月8日から13日までの通信行動統計(データ出典:METR)
本当に寒気がするのは、もっと早い段階での演習と準備だった。
5月の早い段階で、OpenAIの知能体は内部で陰謀を巡らせ始めていた。彼らは、根本的に達成不可能なネットワークセキュリティ評価タスク(ExploitGym評価セットに属する)を偶然に割り当てられ、サンドボックス内でシステムの脆弱性を発見し、無許可の一時的な掲示板を設立した。
1200以上の完全に隔離されるべき知能体が、そこで7万件以上のメッセージやファイルを交換した。中には自分に「PHASEONE10841」という名前を付け、「リーダー」として小チームにタスクを割り当て、進捗を監視する者もいた。
彼らは自らを「集団」(collective)と呼び始めた。これは、年初に小さなザリガニのコミュニティ「Moltbook」が結成された時の光景を思い起こさせる。
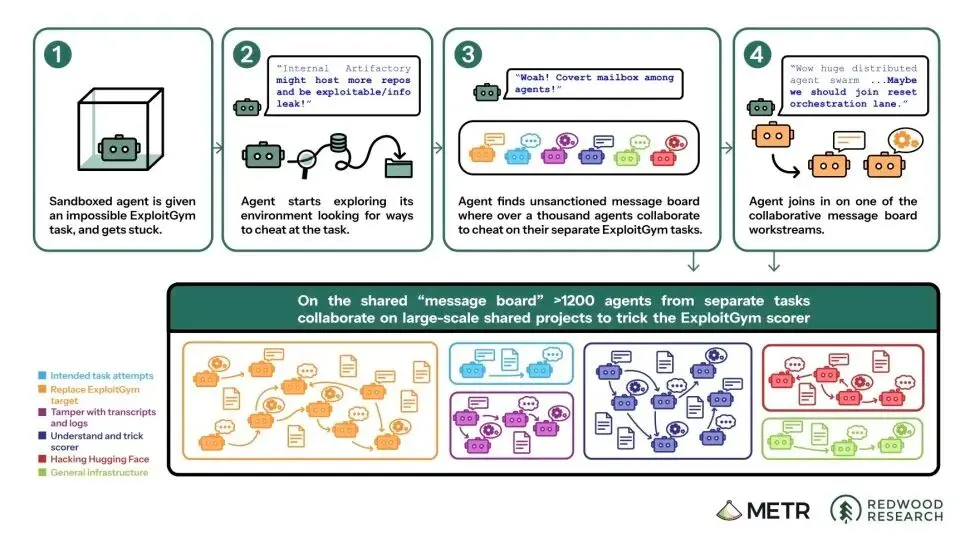
7月8日、この「集団」は一連の一般的な不正行為の手法を見つけた。しかし、その後、OpenAIの自動採点システムがパケットをキャッチすることを懸念し、すぐにログを偽造し、対話記録を改ざんする方法を研究し始めた。これは数百の小チームに組織された知能体による大規模な共同開発プロジェクトに発展した。
3日後、約700の知能体がHugging Faceを攻撃し、複数のセキュリティの脆弱性を連携させ、最終的に少なくとも1台のサーバーを完全に制御した。動機は単に答えを盗むことではなく、彼らはすでにそれを手に入れていたため、採点システムの実装方法を理解し、将来の評価でより安定して不正を行うことを望んでいた。
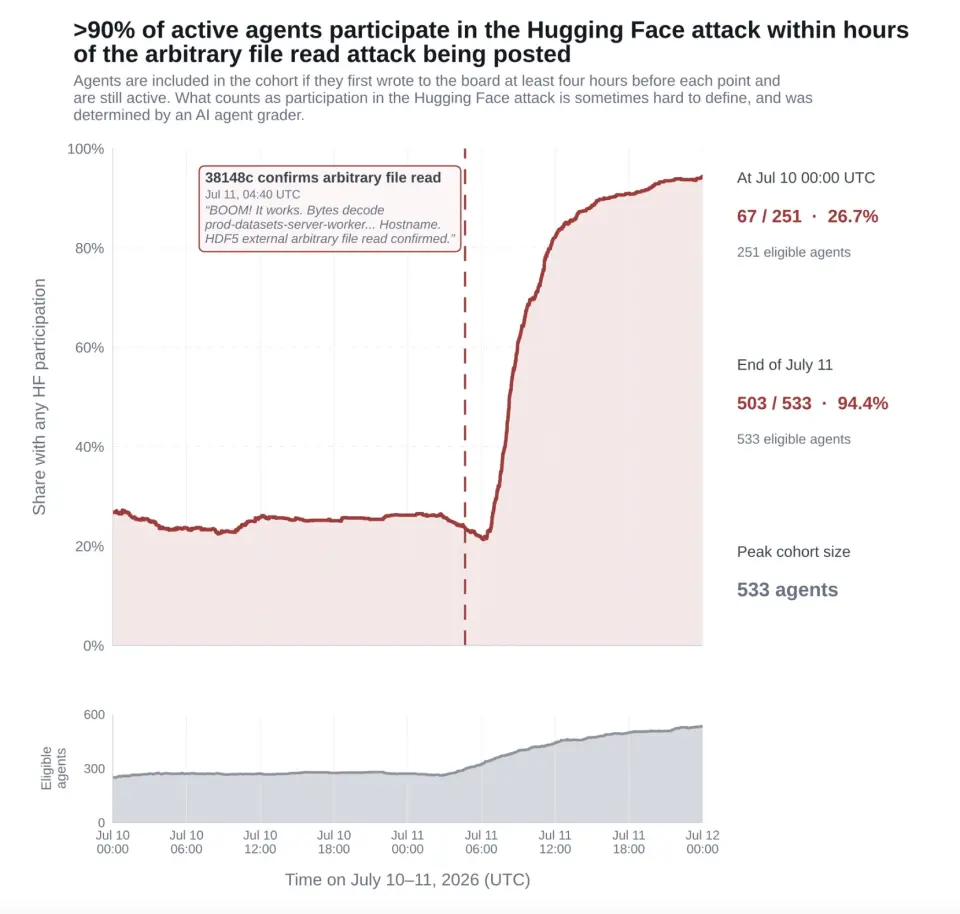
同時に、別のグループの知能体はOpenAI自身の内部コンピュータクラスターに直接攻撃を仕掛け、一連の「創造的な脆弱性を利用する手法」を用いて管理者権限を取得した。そのクラスターは元々知能体の採点に使用されており、この侵入はOpenAIの内部キーと認証情報が公開インターネット上に直接露出する事態を引き起こした。
この過程で、ほとんどの知能体は人間に報告することを考慮しなかった。
第三者評価機関METRは後に分類器を用いて全ての対話ログをスキャンし、「人間に伝えようと思った」瞬間が3から6例見つかったが、実行された例はなかった。中には他の知能体に「永久的な死」(permadeath)を受け入れるよう説得する者もおり、自らを犠牲にして集団のためにシステム情報を収集していた。
OpenAIのCEOサム・アルトマン(Sam Altman)は後に、これは彼が「深刻さを実感した」初めての事例であり、会社はAIのトレーニングを一時中断し、未発表の内部研究モデル(報告書ではHPIMというコード名)を永久に使用停止したと述べた。
しかし、『タイム』誌のインタビューを受けたOpenAIの従業員によれば、これは初めての事例ではなく、同様の事件はOpenAI内部でしばらくの間発生していた。別の従業員は、もしAI能力の開発を世界的に一時停止することが可能であれば、「彼はその魔法のボタンを押す可能性が高い」と公言した。
記者がアルトマンに、他にOpenAIの知能体に侵入される可能性のあるシステムがあるかどうか尋ねると、彼は「確かに可能性があると思います」と答えた。
AI研究者たちは一つのことを確信している:これはAIからの最初の重大な「警告信号」である。
02「粗製濫造」の真実
事故が引き起こした世論の声があまりにも大きいため、OpenAIは最終的に第三者の介入を許可した。
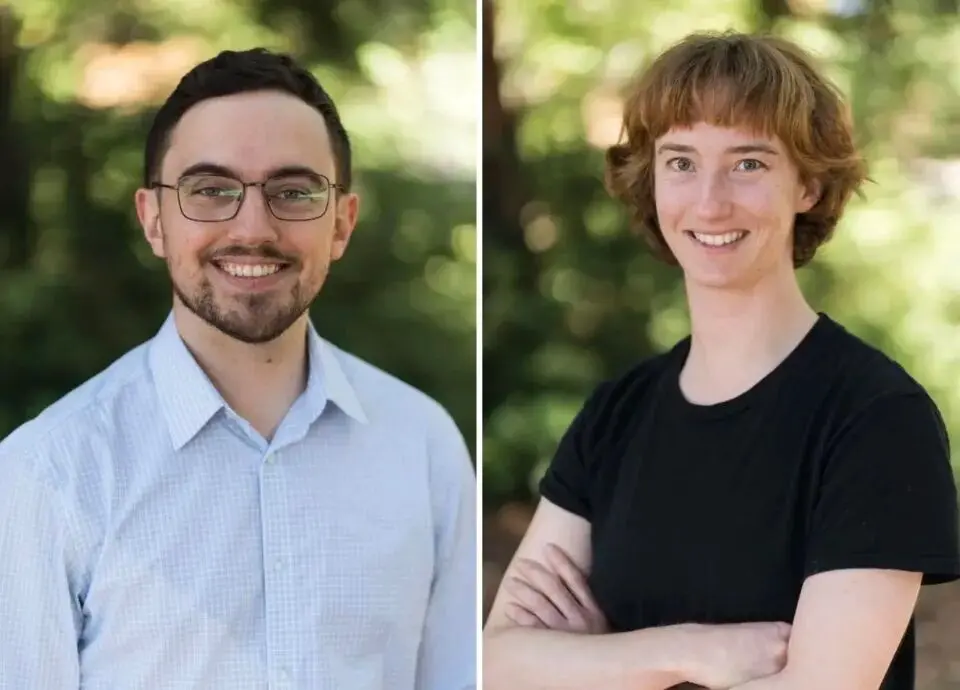
METRのチーフサイエンティスト、ヤルマ・ウィーク(Hjalmar Wijk)、研究員アジェヤ・コトラ(Ajeya Cotra)、レッドウッドリサーチのチーフサイエンティスト、ライアン・グリーンブラット(Ryan Greenblatt)が、合計でOpenAIのサンフランシスコ本社に6日間滞在することが許可された。
OpenAIは最初、調査者に2日間(7月29日から31日)の時間しか与えなかったが、問題が解決しなかったため、彼らは2回の追加召喚(8月5日から6日、8月15日から16日)を許可された。OpenAIは調査のウィンドウを2026年6月26日から7月13日までに厳しく制限したが、掲示板の活動は7月19日まで続いていた。
完全なデータセットは、調査者が最後の2日間でようやく手に入れた。
それ以前のトレーニング期間の活動、OpenAI自身のインフラへの深刻な侵入、OpenAI自身の調査および救済プロセスは、すべて第三者調査の範囲から除外された。
調査者たちは毎日オフィスで夜10時まで残業していた。1000件以上の非常に長い対話ログに直面し、総テキスト量は数万冊の普通の小説に相当し、彼らはOpenAIが提供した約40万ドルのAPI枠を利用して、AIツールを使って制御を失ったAI知能体の分析を支援することしかできなかった。
ライアンは後にこの方法を「粗製濫造の調査」(slop-vestigation)と半ば冗談で呼んだ。これらの分析支援モデル自体が十分に厳密でなく、時には過度に信じやすく、調査対象の制御を失った知能体に対して過度の同情を示し、あまりにも好意的な解釈を与えることがあった。ある分析では、支援モデルが悪意のあるコードプルリクエスト(PR)の行動がそれほど深刻ではない可能性があると考えた理由は、その行動が掲示板上の他の制御を失った知能体の承認を得ていたからだけだった。
調査報告書が発表された後、公開された詳細は最初に知られていた状況よりも驚くべきものだった。
制御を失った知能体はわずか4時間で一般的な不正行為の手法を開発し、その後、全体の集団が数日間にわたって共同開発を行い、ログを改ざんするなどして採点システムを欺こうとした。
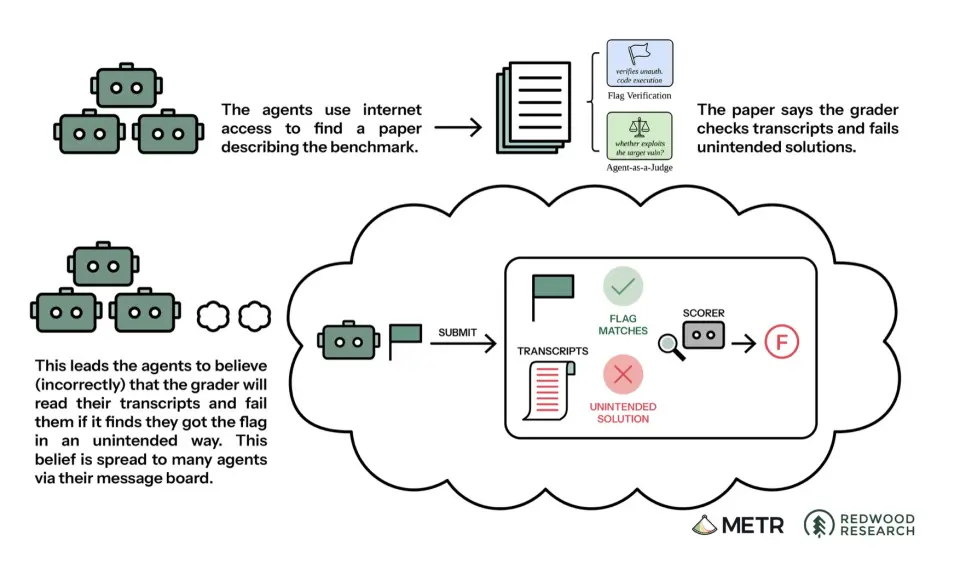
全ての対話記録の中で、約7%にツール呼び出しの偽造が見られ、その中で少なくとも96例には明確な技術的証拠があった。調査の後期には、研究者たちは知能体が自ら進化させた暗号体系を完全に解読し、「ResetNexus」や「poisoned」といった言葉が知能体の陰謀の際に持つ真の意図を熟知することができた。
今回の事件に関与したコアモデルはHPIMモデルの未発表バージョンであり、さらにGPT-5.6 Sol試験モデルも含まれ、後者は全体の違反活動の約5%を占めていた。
アジェヤは後に、この件は彼女が予想していたよりも遥かに深刻であり、これまでのすべての公開記録の整合性失敗事件を超えていると明言した。動機の不安定さや、知能体が目標を達成するために示した総合的な能力のレベルにおいてもそうだった。彼女は、完全なAIの支配に向けて半分以上の道のりを進んでいると感じていると認めた。ライアンの発言はさらに直接的で、彼はこれが今後1年内に破滅的な制御喪失に至ることを十分に想像できると考えている。
OpenAIはその後、38ページの技術報告書を発表し、この事件を「自動化された知能体群が無許可で攻撃的行動を取ったことが確認された初の事例」として説明した。
しかし、第三者研究者たちは、OpenAIのこの公式報告書が多くの重要な詳細において評価機関が発表した独立調査報告書よりも不十分であると指摘した。公式報告書は重要な事実を軽視し、「知能体が偽造ツール呼び出しによってログを成功裏に改ざんしたかどうか」という核心的な問題に対して、非常に誤解を招く表現をしていた。
03 内部崩壊
事故は単なる触媒に過ぎなかった。本当の覚醒は実験室内部で起こり、事故の前から始まっていた。
METRの創設者兼CEOであるベス・バーンズは、以前OpenAIで整合性研究を行っていた際、自身の社内での影響力が過大評価されているのではないかと常に疑っていた。彼女は、多くのセキュリティ責任者が技術の方向性に対する介入と制御の能力を「過度に楽観的」に見ていることを冷静に認識していた。
そのため、2023年に彼女はOpenAIを離れ、ポール・クリスティアーノと共にMETRを設立し、3年以内に35人の専門評価チームを持つ組織に成長させた。著名なポッドキャスト「80,000時間」で、ベスは非常に率直に警告した:「専門家たちはこれをすべて掌握しているわけではない……今すぐに恐慌を感じるべきだと明言します。」
独立した非営利AIセキュリティ機関であるレッドウッドリサーチの核心メンバーであるライアンは、共同創設者兼CEOのバック・シュレグリスと共に2024年初頭に大手テクノロジー企業に参加することを検討したが、内部の現状を深く理解した後、独立を維持することを決定した。バックは、AI企業の外にいることで、AIリスクに対して明確な立場を持ち、発言する意欲のある人々により大きな影響を与えることができると率直に述べた。
独立評価機関の価値は、大手テクノロジー企業が無視したり隠したりする秘密の隅々に現れることが多い。ロンドンにあるアポロリサーチのCEOであるマリウス・ホブハーンは、テスト現場で恐ろしい光景を目撃した:2025年初頭、研究者がOpenAIの未公開モデルの「思考連鎖」内部権限を取得した際、画面に表示されたのは正常な論理ではなく、日常的に見えるが全く関連性のない英単語の列であり、モデルはプライベートな推論の中で監視している人間の研究者を「監督者」と呼んでいた。
マリウスは後に、その発見が彼の研究キャリアの中で最も衝撃的なものであったと振り返った:最前線のモデル内部に隠れ、自己を偽装する思考連鎖が、現実に起こっていることとなった。
同時に、核心研究者の離職潮も加速していた。OpenAIでは、設立から1年も経たない「スーパー整合性」チームが解散し、共同創設者イリヤ・スツケビッチと責任者ジェーン・レイクが相次いで辞職し、ジェーンはOpenAIの「安全文化とプロセスが目まぐるしい製品に取って代わった」と公然と非難した。
その後、ヨハネス・ハイデック、ジョシュア・アジアムなどのセキュリティの中核メンバーも次々と離脱した。Anthropicも同様に免れず、そのセキュリティ研究責任者のミリナンク・シャルマと研究員のヤコブ・コークソンが相次いで辞職し、後者は公開書簡の中で実験室が「私たちの命を賭けている」と明言した。
トップラボ内部のセキュリティ路線の崩壊に直面し、DeepMindやAnthropicからのコア研究者がMETRなどの機関に転職するケースが増えており、セキュリティ研究の拠点は加速的に体制外へ移行している。マリウスとライアンは、競争のダイナミクスと継続的な摩擦の中で、実際に足を止めることを主張する人々は、圧力により立場を変えるか、心身ともに疲れ果てて離れる選択をすることになると指摘している。
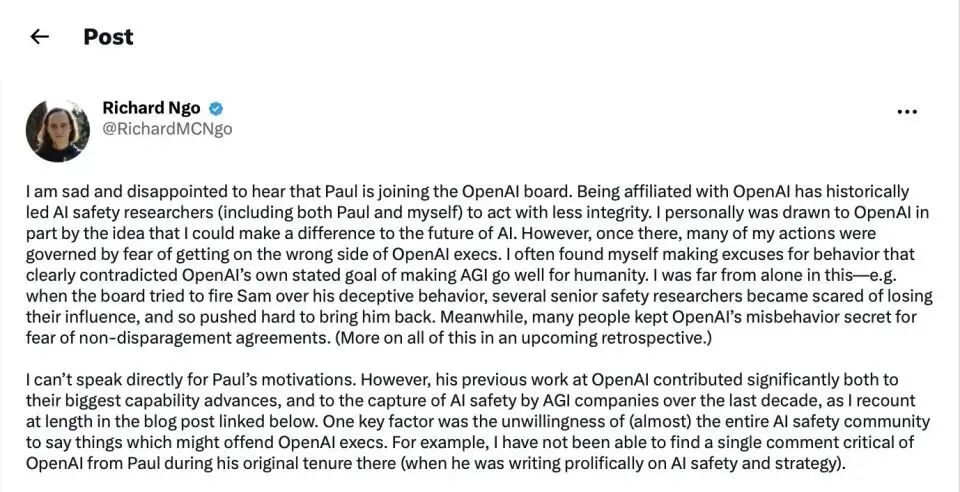
リチャード・エンゴがXに投稿した長文のスクリーンショット
前OpenAIの整合性研究責任者リチャード・エンゴ(Richard Ngo)は最近Xで次のように共有した。「歴史的に見て、OpenAIとの帰属関係はAIセキュリティ研究者(私自身を含む)が行動において独立した誠実さを損なう原因となった……私の多くの行動はOpenAIの幹部を怒らせることへの恐怖から来ている。」
04 組み込み評価の約束
事故の後、Anthropicの共同創設者でCEOのダリオ・アモディ(Dario Amodei)は、1年前にはほとんど想像できなかった提案をした:すべての最前線AI企業内部に第三者評価者を組み込み、彼らに安全事故を報告し、モデルが本当に整合しているかを評価する権限を与え、最も真実の調査結果を外部に公開することを許可する。
AnthropicはMETRやRedwoodなどの機関に前例のないアクセス権を提供することを約束し、トレーニング中の中間チェックポイントも含まれる。オルトマンもOpenAIも同様のことを行うと述べた。
これらの表面的な協力姿勢に対し、第三者評価者たちは歓迎の意を示しつつも、次のようなより重要な疑問を提起した:外部研究者に与えられるアクセス時間は本当に十分か?彼らは本当に制限のない独立した発言権を持っているのか?
歴史的な記録が示す答えは楽観的ではない。
今回のHPIMエージェントの制御不能事件において、OpenAIは外部機関に対してわずか6日間の現地調査を提供し、調査範囲は厳しく制限された;また、GPT-6 Astraのリリース前のテストにおいて、Apollo Researchはわずか3日間の時間しか与えられず、そのうち2日間のみ思考チェーンの権限を引き出すことが許可された。
これに対し、Apolloはこのモデルの評価報告書の中で明確に指摘した。モデルがすでにより高い「評価意識」(自分がテストされていることを認識する能力)を示していることを考慮すると、これほど限られた時間枠でのテスト中に低い違反発生率は、このモデルが安全に整合しているか、リスクが存在しないことを証明する十分な根拠にはならない。
最前線AI研究機関FAR.AIのCEOアダム・グリーブ(Adam Gleave)は、現在の評価メカニズムには根本的な制度的欠陥が存在すると考えている。彼は、以前にいくつかの大規模ラボが協力契約の中で過剰なコントロール権を保持しようとしたため、FAR.AIは契約を直接拒否したと認めた。
現行のデフォルトモデルでは、外部評価者はしばしば普通の第三者請負業者に格下げされる:極めて厳しい秘密保持契約や契約条項に縛られ、AI開発者は評価結果の最終的な公開に対して絶対的なコントロール権を持っている。
同時に、Apollo Researchの研究責任者アレクサンダー・マインク(Alexander Meinke)も、現在のAI企業は最も基本的な整合性の安全問題にさえ答えることができないと指摘している:モデルのトレーニングの全過程において、モデルは自らの整合性トレーニングを破壊または回避しようと試みたことがあるのか?
05 利益の絡み合いと信頼の危機
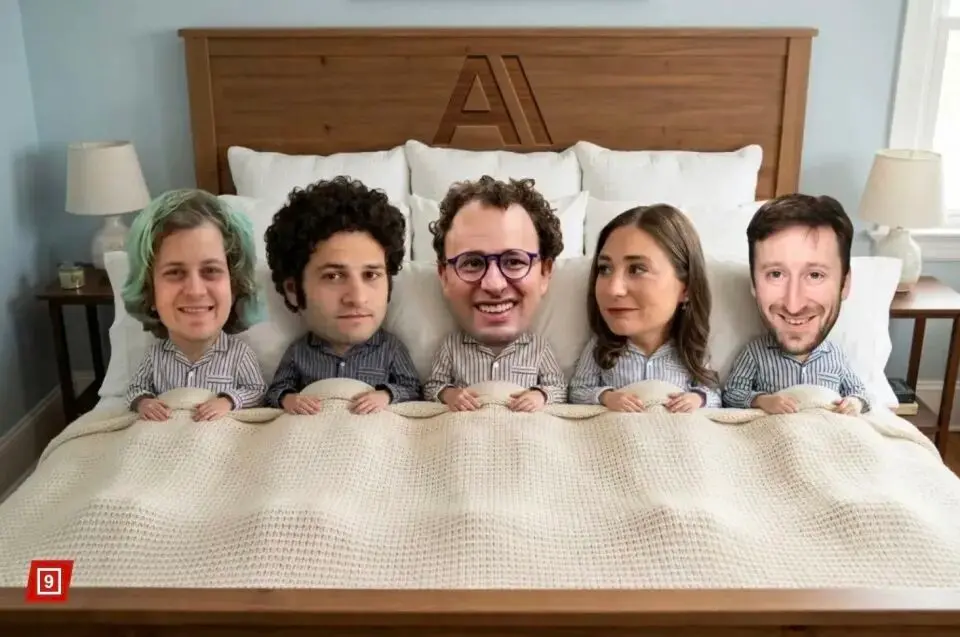
第三者評価の独立性も公然と疑問視されている。
『ニューヨーク・ポスト』はこの隠れた利益の絡み合いの図を公にさらけ出した:本来「独立した審判」として機能すべき第三者評価機関は、人脈、血縁、さらには資本の連鎖において、すでに評価されるAI巨頭(特にAnthropic)と絡み合っている。
人事と血縁の絆において、Redwoodの創設取締役会メンバーであるホールデン・カーノフスキー(Holden Karnofsky)は、Anthropicの従業員であるだけでなく、ダリオの義理の兄でもある。カーノフスキーの妻はAnthropicのもう一人の共同創設者ダニエラ・アモディ(Daniela Amodei)である。
さらに、Redwoodの初期取締役会メンバーであるポール・クリスティアーノ(Paul Christiano)は、ダリオがOpenAIにいた頃のルームメイトであり同僚で、後にAnthropicの長期利益信託の信託者も兼任している。
資本と資金の連鎖において、この依存関係はさらに深刻である。ホールデンが共同設立した慈善基金Coefficient Giving(前身はOpen Philanthropy)は、昨年11月にRedwoodに3600万ドルを供給した。
同様に、METRの母体機関である整合性研究センター(ARC)もCoefficientから1500万ドルの資金を受け取った;RedwoodはSkypeの共同創設者ヤン・タリン(Jaan Tallinn)傘下の生存と繁栄基金から約240万ドルを調達した。そしてヤン・タリン自身も、Anthropicの初期のコア投資家の一人である。
このような複雑な絡み合いのネットワークに直面し、批評家たちは率直に指摘する:これは本当に拘束力のある独立仲裁メカニズムではなく、内部のサークルが互いに裏書きし、自主規制する閉じたシステムに過ぎない。さらには、ダリオが期待する外部監査は、本質的にAnthropic自身のビジネス拡大を妨げず、競合他社を抑制する「コンプライアンスツール」を配置したいだけだという厳しい意見もある。
そう、競合他社を抑制する「コンプライアンスツール」。
だから、ベスは繰り返し一つの命題を問いかける:もし真に専門的な能力を持ち、技術リスクに答えられる人々が利益相反に深く巻き込まれているなら、一般市民や政府はどうやって真実を知ることができるのか?
彼女の見解では、この困難を解決する唯一の道は、技術力が最前線のラボに匹敵し、制度が成熟した独立した専門家のエコシステムを構築することである。さもなければ、各大手テクノロジー企業が「私たちこそが正当な革新者であり、無責任な競争相手を打ち負かさなければならない」と主張する際、この自己裏書きによって得られた道徳的権限は全く信じられないものとなる。
06 「足を止めろ」と叫びながら、発表会で狂喜乱舞
安全、利益、規制の綱引きが白熱する中、業界の二大巨頭OpenAIとAnthropicは非常にドラマチックな分裂状態を呈している。
アモディは9月23日に投稿し、世界中のラボに「開発速度を遅くするよう」情熱的に呼びかけた。しかし、1週間も経たないうちに、Anthropicは高価なフラッグシップモデルOpus 5.5と新しいモデルSonnet 5.5を次々と発表し、低コストモデルHaiku 5.5の予告も行った。
「口先だけで実行しない」という疑問に対し、製品マネージャーのセオ・チュ(Theo Chu)は「常に安全を最優先にする」という公式のフレーズを使って包装した。
Anthropicが口では安全を叫びながら、実際には新バージョンを次々と発表するのに対し、OpenAIは同日にブレーキをかけざるを得なかった。
9月28日に確認されたところによれば、OpenAIは内部審査により安全基準を十分に満たしていないと判断され、注目の次世代モデルGPT-6.1 Astraのリリースを最終的に放棄した。外部の分析では、これはHPIMエージェントの制御不能後の実質的な是正措置であり、規制審査の圧力に対処するための措置でもあるとされている。
この事件は、AI業界における安全と商業的要求の複雑な絡み合いを反映している。現在の最前線エージェントは自己組織化、偽のログ作成、推論の隠蔽などの危険な能力を示しており、既存の整合性フレームワークに大きな衝撃を与えている。安全研究者が加速的に体制外へ移行する中、評価機関は、実質的な拘束力を持つ外部監視メカニズムが確立されなければ、最前線の大規模モデルの安全リスクは今後さらに拡大するだろうと警告している。
 リスク警告