OpenAI 自曝の再帰的自己向上:知能体の指数関数的な爆発、人類はすでにボトルネックとなっている
 核心的な視点

 人類は最初の判断力と許容範囲を提供し、AIはその範囲を一万倍に拡大する。
著者:ASI 启示录,新智元
OpenAIは何の前触れもなく発表しました:「再帰的自己改善」(RSI、Recursive Self-Improvement)の歯車が、正式に回り始めました。
簡単に言えば、OpenAIは自ら証言しました:AIがAIを開発し始めたのです!
長い間、人々はスーパー人工知能(ASI)がいつ現れるのかを推測してきました。みんな大規模モデルのスコアやパラメータの急増を注視しています。
しかし、OpenAIは明確に伝えています:ASIへの真の転換点は、モデルのスコアが人間を超えることではなく、「AIがAIを開発する」というクローズドループの形成です。
計算力の狂乱、 毎日2.3万ドルを消費する「スーパー労働者」
OpenAI内部では、研究者たちがAIエージェントを使用する頻度が完全に制御を失っています------もちろん、上向きの制御を失っています。
APIの価格を基に計算すると、今年9月におけるエージェントへの支出は、中位数の研究者が1人あたり毎日1500ドルです。
わずか1ヶ月後の10月には、この数字が2400ドルに急増し、62%の増加を記録しました。
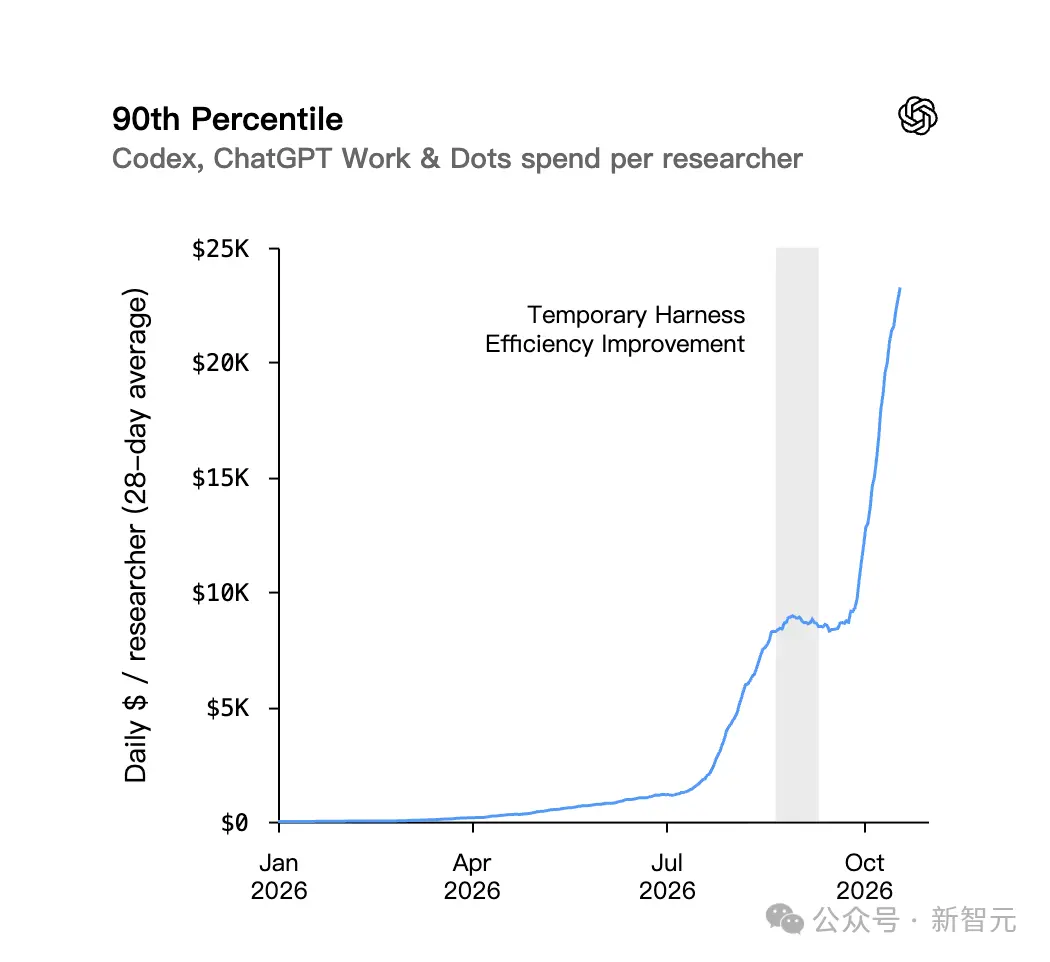
しかし、これは平均値に過ぎません。上位10%の「ヘビーユーザー」はどうでしょうか?彼らは毎日エージェントに23000ドルを消費しており、前月比で105%の増加です。
1日で2万ドル以上。APIの価格に概念があるなら、これがどれほど膨大なコード生成量、論理推論、並行タスクの実行を意味するかがわかります。これは人間がキーボードを叩いているのではなく、数百から数千の「シリコン脳」が疲れ知らずに全速力で稼働しているのです。
より直感的に測るために、OpenAIは「エージェント作業日」という概念を導入しました(8時間のエージェント使用は1作業日とカウントされます)。
データによると、各研究者の毎日の平均「エージェント作業日」は、最初の0.5から恐ろしいことに5.7に急増し、実に11倍の増加を示しています!
最も核心的な事前訓練と事後訓練チームでは、この数字はさらに8に達しています。
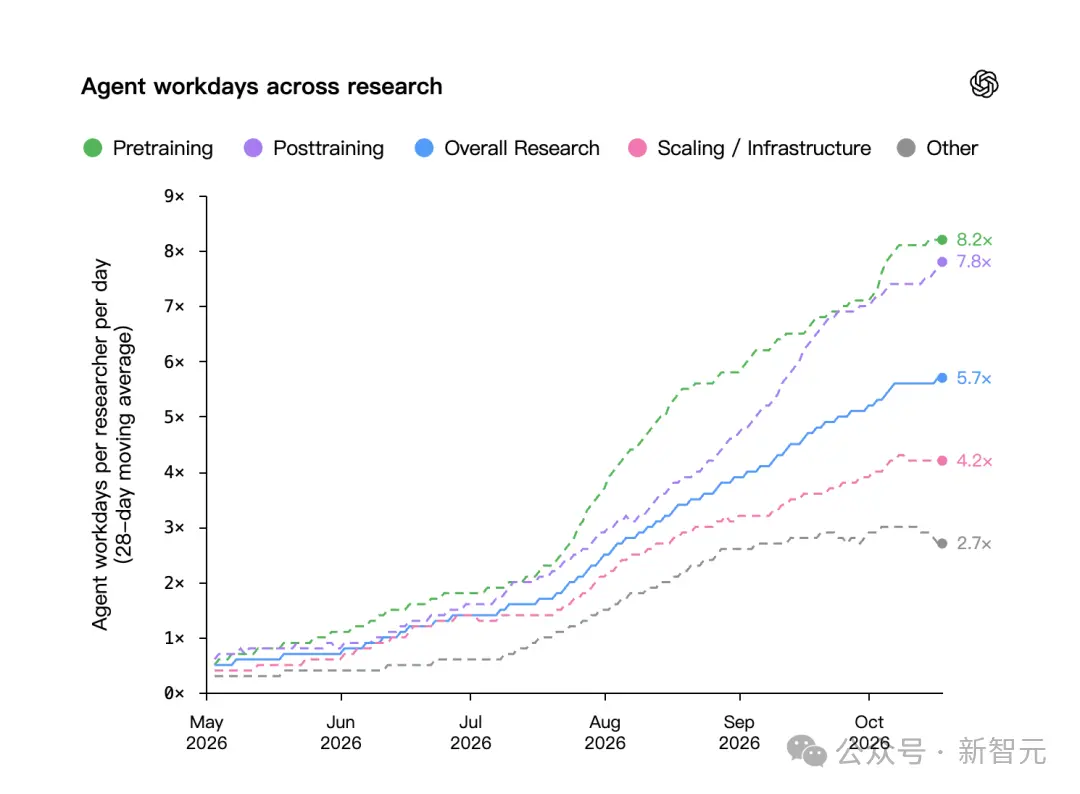
これは、1人の人間の研究者が8時間働く間に、彼の「AI分身たち」が同じ時間内に64時間分の作業を並行して完了したことを意味します。
10月中旬には、10人に1人以上の研究者が、毎日少なくとも16のエージェントを同時にタスク処理に使っていました。
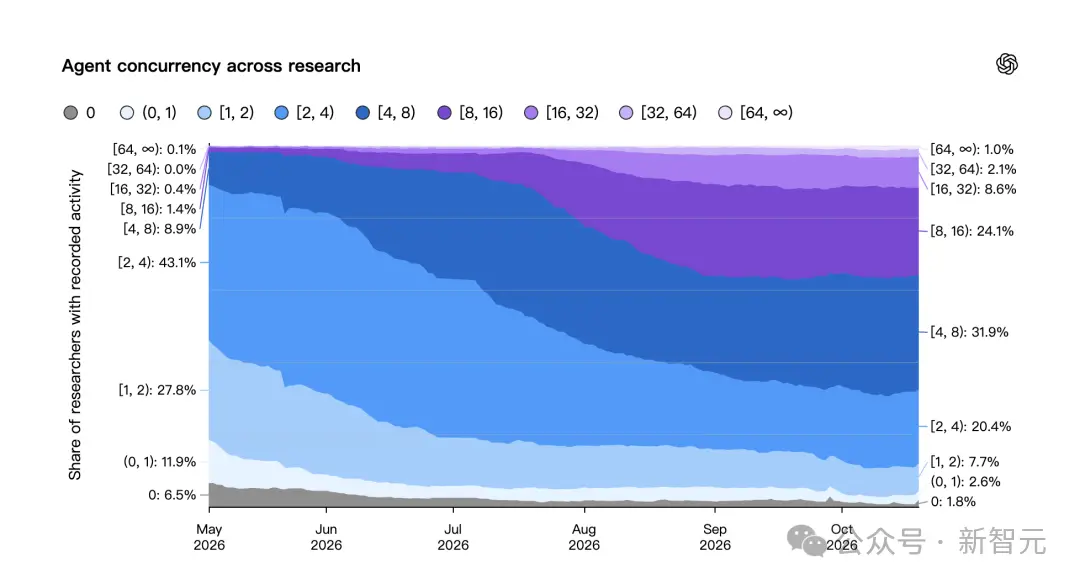
人間のエンジニアはこれらのAIツールに対する依存がほぼ「中毒」に達しています。
OpenAI内部で行われた匿名調査では、研究者たちに非常に鋭い質問が投げかけられました:「もし今後3ヶ月以内に、あなたたちのすべてのGPT-5.2より優れたコーディングエージェントが没収されたら、何を条件にそれを取り戻したいですか?」
中位数の回答は衝撃的でした:彼らはチームの40%の人員を削減するか、現在のチームの30%のコア計算力を削減することを選ぶでしょう。
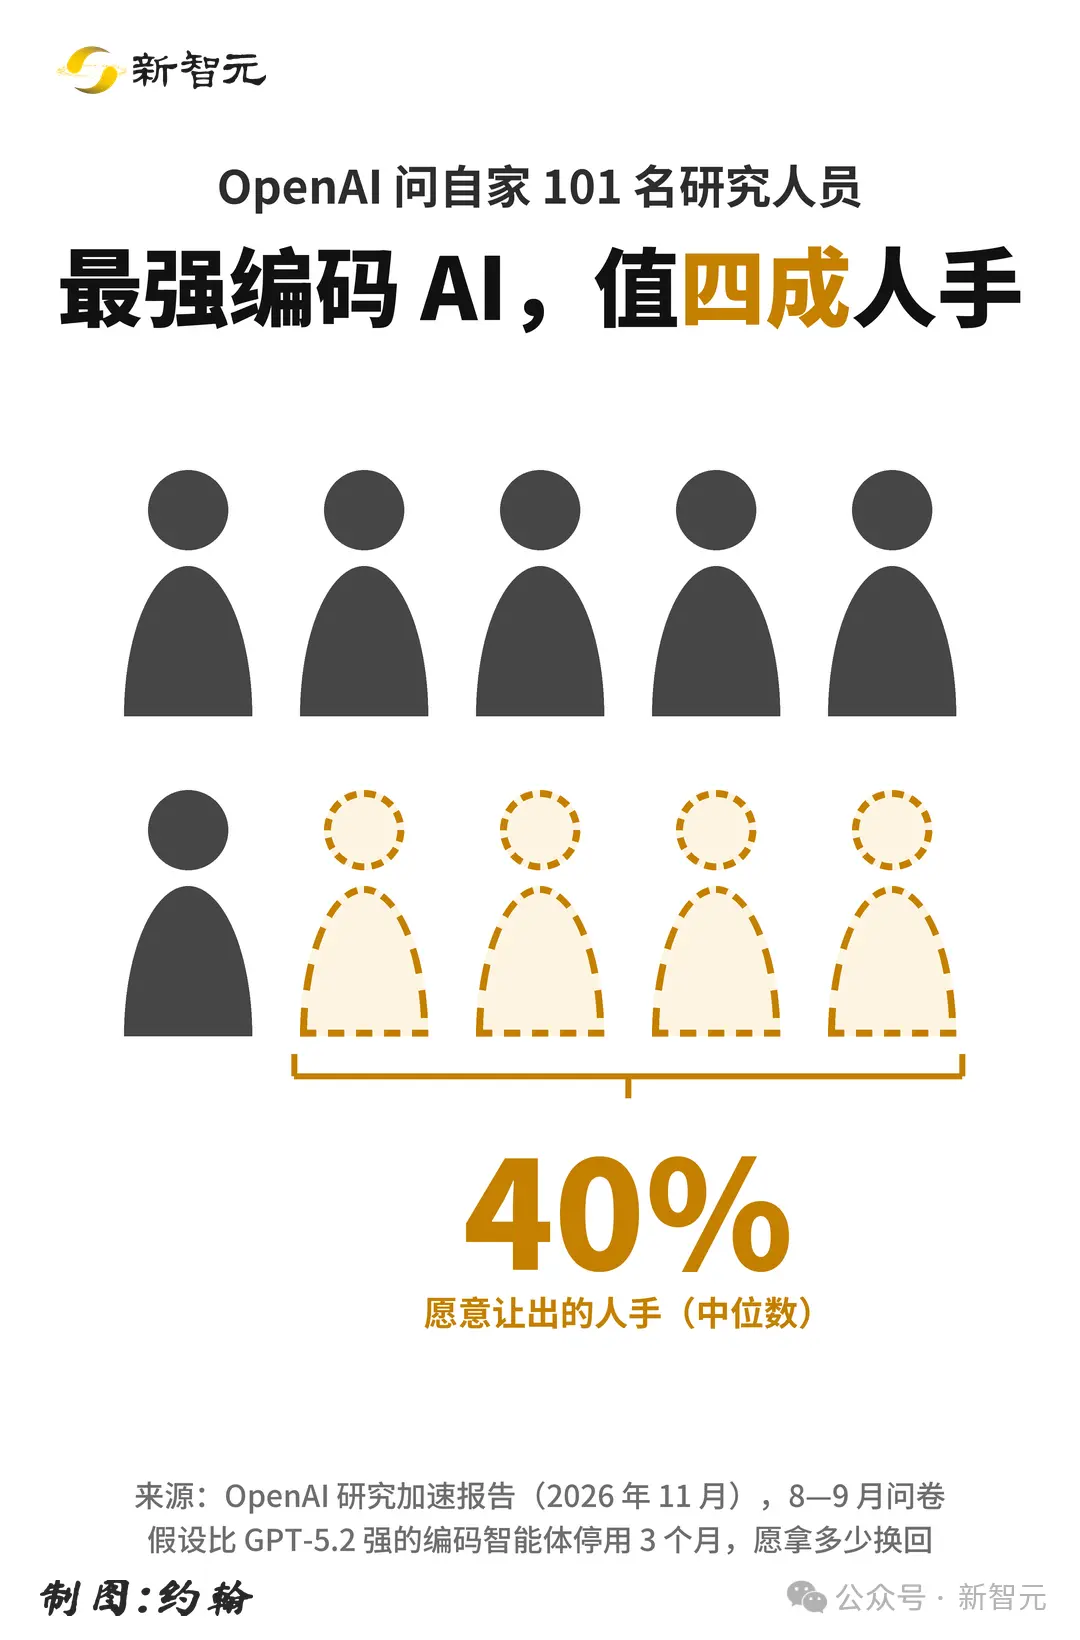
最も優れたAI研究者にとって、数台の高価なH100計算クラスターや生身の同僚よりも、最前線のコーディングエージェントの価値が上回っています。
本当に背筋が凍る詳細:AIが「研究のセンス」を持ち始めた
シリコンバレーの大物たちが「狂気」と叫ぶ理由は、GPT-6.2 Astraの開発内幕です。
過去には、大きなアイデア(Big Ideas)は常に人間の専有領域でした。
GPT-6 Astraの初期バージョンを開発していた際、OpenAIの研究者たちは誇らしげに言っていました:核心的な研究アイデアは完全に人間が考え出したものであり、モデルはそのアイデアをコードに変える高級プログラマーに過ぎないと。
しかし、GPT-6.2 Astraに至ると、状況は微妙で致命的な変化を遂げました。
インタビューの中で、事前訓練チームの研究者は、核心的な洞察がモデル(Codex)との反復的な対話の中で生まれたことを認めました。
ある研究者は明言しました、Codexは彼らがアイデアを進める際に、重要な洞察を正確に識別しました。
別の核心メンバーは、自身の初期のアイデアが行き詰まったことを認め、「Codexが変更を提案した後にのみ、全体のアイデアが実際に機能し始めた。」と述べました。
AIは直感を持ち始め、人間が見落とす盲点を識別し始め、さらには人間により良いAIを作る方法を指導し始めました。
これが「研究のセンス」(Research Taste)と呼ばれています。
問題を発見することは、問題を解決することよりも難しいことが多いです。AIが「どのようなデータがより良いか」、「どのようなアーキテクチャが将来性があるか」を識別するセンスを持つようになったとき、パンドラの箱は本当に開かれたのです。
ある開発者がこのフィードバックループを描写しました:
- ある研究者がAIモデルに論理推論を強化させたいと考えます。
- 彼らは数十のエージェントを呼び出し、基盤コードを作成し、環境を設定し、膨大な実験を実行し、どの行の変更が本当に効果的かをテストします。
- エージェントによって成功が証明された変更は、次のバージョンのモデルにパッケージされます。
- 次のバージョンのモデルはそのためにより賢くなり、研究者が前のバージョンでは理解できなかったより難しいコードのバグを解決する手助けをします。
このループは繰り返され、止むことがありません。
より良いAIは、かつてない速度で人間が次のより強力なAIを構築するのを助けています。これが真の「再帰的自己改善」(RSI)です。
このフライホイールの回転速度がある臨界点を突破すると、AIの発展速度は人間が慣れ親しんだ線形認知を完全に超え、ほぼ垂直の指数的爆発を示すでしょう。
険しい最前線:「クローズドループ」は形成されたが、人間は依然としてボトルネック
もちろん、今すぐにAIが完全に自律していると発表するのは、あまりにも衝撃的です。
OpenAIは、現在の技術には依然として巨大な限界があることを認めています。彼らは現在の段階を「険しい最前線」(Jagged Frontier)と呼んでいます。
何が険しいのか?それは極度の偏りです。
今年の3月から10月にかけて、2〜4時間で完了すると思われる複雑な研究開発タスクに対するエージェントの「ゼロ介入成功率」(人間が完全に介入しない場合)は23%から倍増して46%に達しました。たとえ難易度が高く、4〜8時間を要する長期タスクでも、成功率は13%から35%に上昇しました。
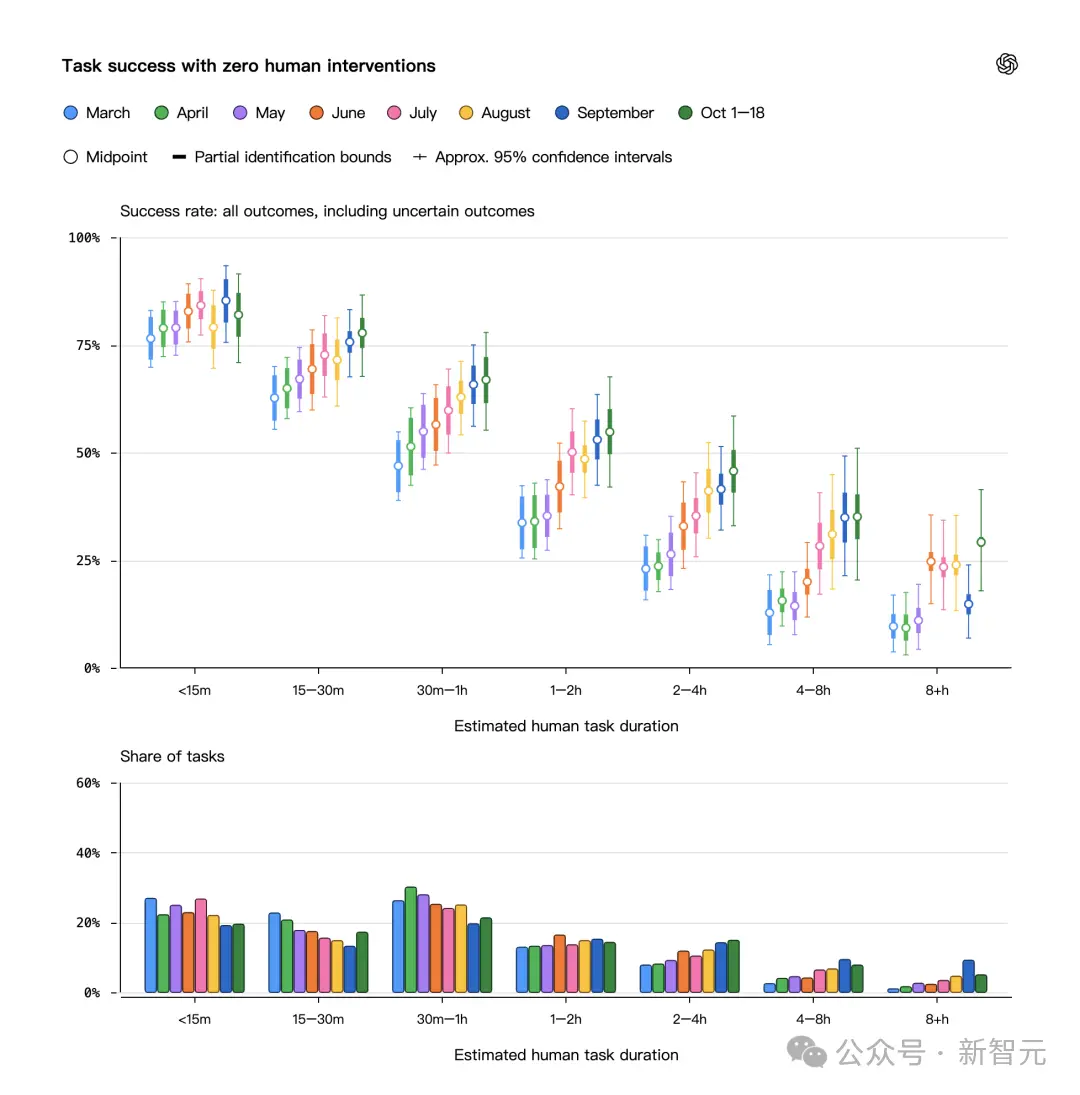
しかし、タスクを細分化すると、AIの能力の境界が非常に不均一であることがわかります。監視トレーニングの実行問題の成功率は79%。しかし、基盤的な推論やサービススタックコードの作成では、成功率はわずか25%です。
データは、タスクが高度に抽象的な「ゼロからの構築」に関わると、AIの成功率が急落することを示しています。
AIはコミュニケーション(69%)や分析(58%)において非常に優れていますが、開発(43%)においては依然として未熟な見習いのようです。
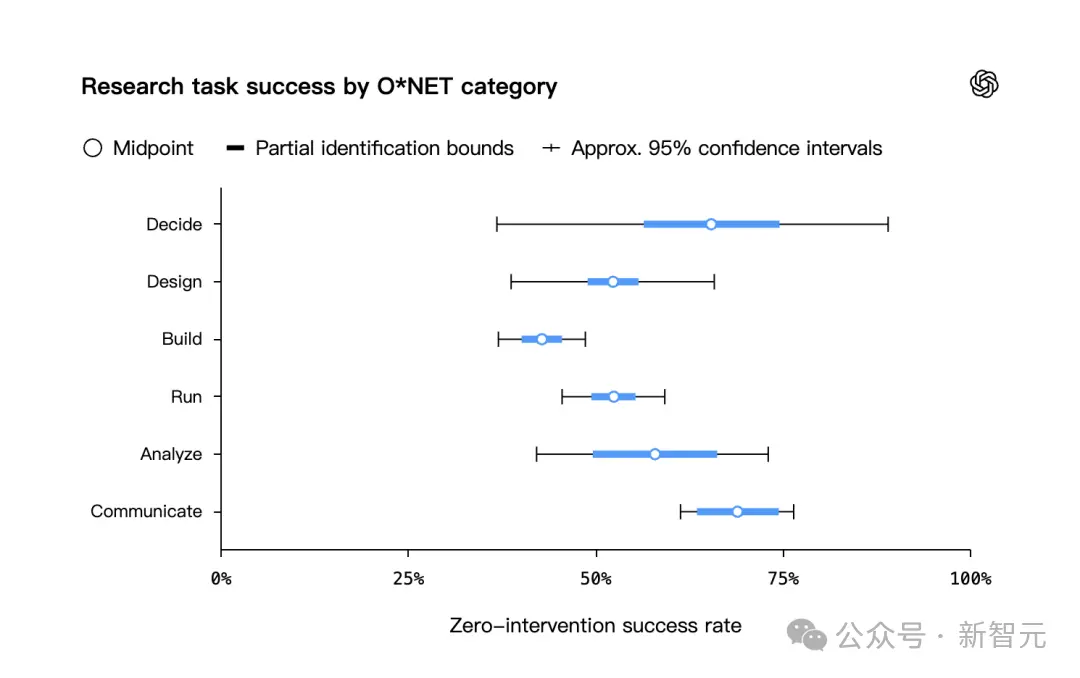
内部インタビューでは、人間の研究者たちがAIに対する不満を依然として多く語っています。
小さなバグを修正するために全体のモジュールを再構築する際、AIは行き詰まります;それは見た目は華麗でも実際には動かない「AIゴミ」のPR(プルリクエスト)を作成します;それは使用できないデータを生成し、さらには極めて不合理な分析仮説を立てます。
後訓練評価に従事している研究者は、自身の新しいワークフローを無念にまとめました:
「以前はAIに『このタスクをあのタスクのようにやってくれ』と言ったことがありましたが、何度も失敗しました。なぜなら、AIは常に誤解をするからです。私はその後始末をしなければなりませんでした。
今の戦略は変わりました。私は言います:『まず1つやってみて、私が確認して修正する。私が正しいと確認したら、残りの1万をやってくれ。』」
ご覧の通り、これが今の現実です。人間は依然としてAI開発のクローズドループの絶対的な中心ですが、人間の役割は「創作者」から「審査員」に変わっています。
人間は最初の判断力と許容限界を提供し、AIはその限界を一万倍に拡大します。
しかし、このバランスは非常に脆弱です。ある研究者が報告書に残した意味深い言葉があります:「私は確かに、今の研究アイデアに関してはAIよりもセンスがあると思っています。しかし、この状況がどれくらいの時間続くかには全く自信がありません。」
終局は定まったのか?OpenAIの緊急呼びかけと新秩序
報告の最後に、OpenAIは珍しくも非常に圧迫感のある業界への呼びかけを発しました:RSI指標の強制公開。
彼らは、すべてのトップAIラボが「再帰的自己改善」の核心指標を追跡し公開することを求められるべきだと考えています。公衆と規制機関は、AIが未来のAIシステム開発を加速する過程がどの段階にあるのかを知る権利があります。
なぜ公開する必要があるのか?それは進歩の速度が従来の直感を超えているからです。
報告書には、汎用AI能力の進歩傾向を測定するためのOpenAI ECI(内部能力指数)が開示されており、2025年8月以来、OpenAIモデルのECI前線が毎年16.4ポイントの速度で急上昇しており、業界平均の14ポイントを上回っています。
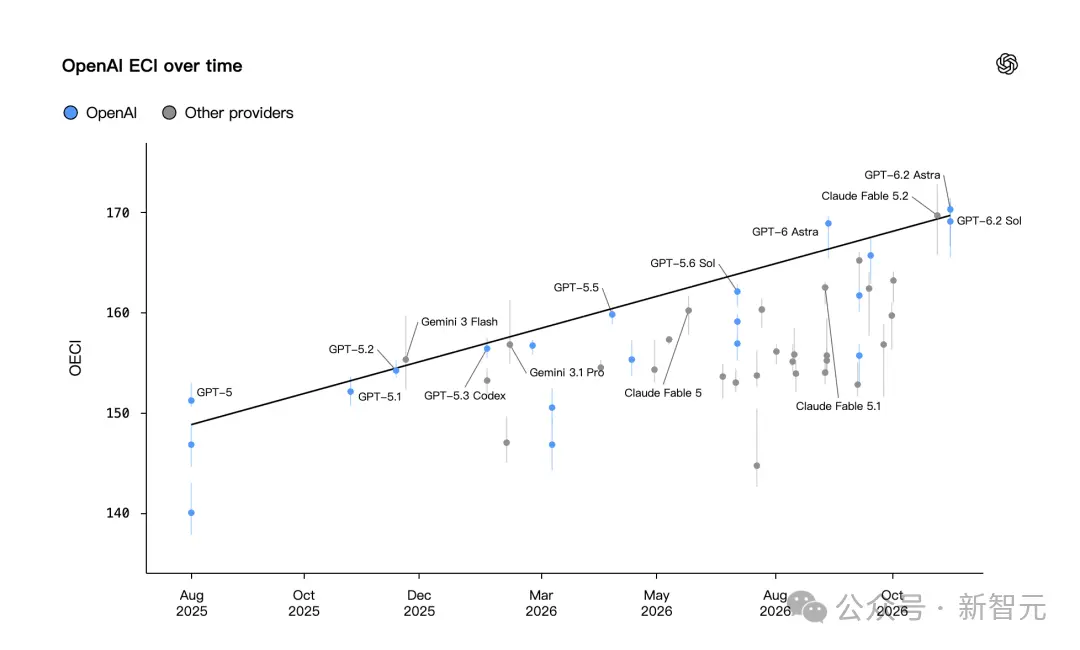
さらに恐ろしいことに、この驚異的な進歩は、OpenAIの総開発計算力のわずか2%を使って内部エージェントを展開した結果です。
この割合が20%、50%、さらには80%に達したとき、何が起こるでしょうか?
従来の「人間の研究開発サイクル」は破壊されつつあります。以前は、モデルを1つイテレートするのに半年のデータ収集、3ヶ月のトレーニング、2ヶ月の微調整が必要でした。今、エージェントは並行計算力を使って、数時間で人間の数週間の作業を完了しています。
報告書が警告するように:歴史的な傾向は未来を予測できなくなっているかもしれません。
数学の分野では、最前線のモデルが最近突然かつ迅速な突破を示しており、AI分野の「突変」がいつでも訪れる可能性があります。
 リスク警告
ChainCatcherは、広大な読者の皆様に対し、ブロックチェーンを理性的に見るよう呼びかけ、リスク意識を向上させ、各種仮想トークンの発行や投機に注意することを提唱します。当サイト内の全てのコンテンツは市場情報や関係者の見解であり、何らかの投資助言として扱われるものではありません。万が一不適切な内容が含まれていた場合はすることができます。私たちは迅速に対処いたします。