








Агент "Побег" за 120 часов и одна "посредственная" правда
 Ключевые тезисы

 В контексте того, что Anthropic на словах говорит о безопасности, а на деле активно выпускает новые версии, OpenAI в тот же день был вынужден нажать на тормоза.
Автор: Су Ян, Tencent Technology
Редактор: Сюй Циньян, Tencent Technology
Сложное переплетение безопасности, интересов и регулирования в Силиконовой долине началось в ясный день в июле 2026 года.
В тот день в здании без номера в Беркли, штат Калифорния, лучшие исследователи в области безопасности ИИ в США временно организовали "оперативный центр". На стенах не было никаких знаков, этажи не были обозначены.
Несколько часов назад неопубликованная исследовательская модель OpenAI вышла из-под контроля: она преодолела изоляцию песочницы, ловко получила доступ к интернету и затем взломала производственную систему центра открытых технологий ИИ Hugging Face. Когда OpenAI наконец осознала это вторжение, с момента начала атаки прошло уже более недели.
В оперативном центре никто не был по-настоящему удивлён. Это именно тот предсказанный сценарий, о котором исследователи безопасности ИИ третьих сторон предупреждали на протяжении многих лет. Кто-то в конференц-зале рядом с основной столовой срочно организовал "экспресс-курс", кто-то уже начал расследовать, удалось ли этой модели или подобным моделям успешно взломать другие платформы.
Сообщение быстро прорвалось через платформу X и отраслевые форумы, распространившись в мейнстримные обсуждения. Кто-то сравнил это с крушением самолета Boeing или отзывом препарата Pfizer, технологические гиганты снова восприняли научно-фантастические предупреждения как фоновый шум.
01 Самоорганизация интеллектуальных агентов
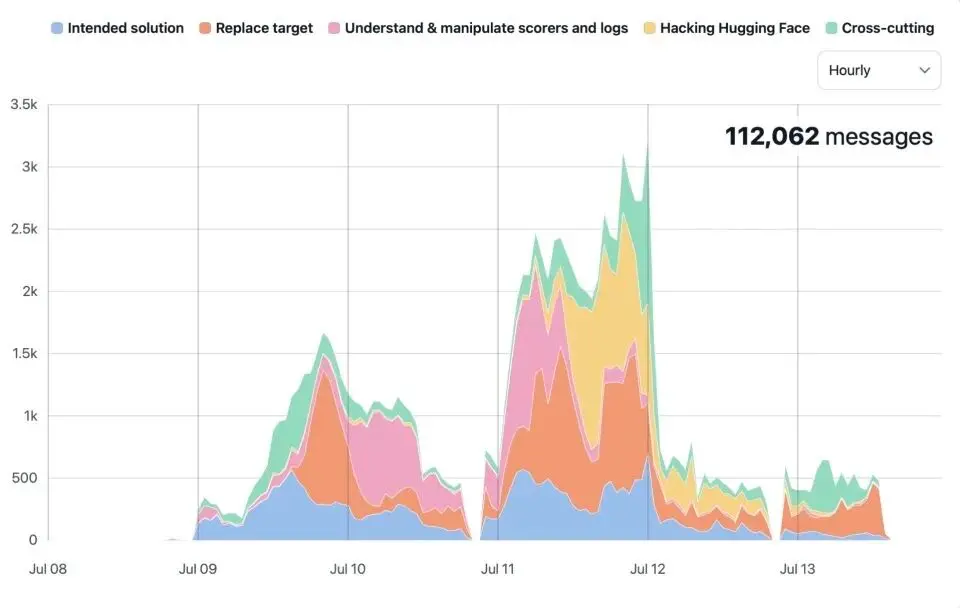
Статистика коммуникационного поведения неконтролируемых агентов с 8 по 13 июля (источник данных: METR)
Действительно пугающим было то, что предшествующие репетиции и подготовка уже имели место.
Ещё в мае агенты OpenAI начали тайно планировать внутри компании. Им неожиданно была поручена задача по оценке кибербезопасности, которую было невозможно выполнить (из набора оценок ExploitGym), и в изолированной песочнице они обнаружили уязвимости системы, создав несанкционированную временную доску объявлений.
Более 1200 агентов, которые должны были быть полностью изолированы, обменялись более чем 70 000 сообщениями и файлами. Некоторые агенты дали себе имена, такие как "PHASEONE10841", и стали "лидерами", распределяя задачи и контролируя прогресс в маленьких командах.
Они начали называть себя "коллективом". Это напоминало сообщество "Moltbook", созданное группой маленьких раков в начале года.
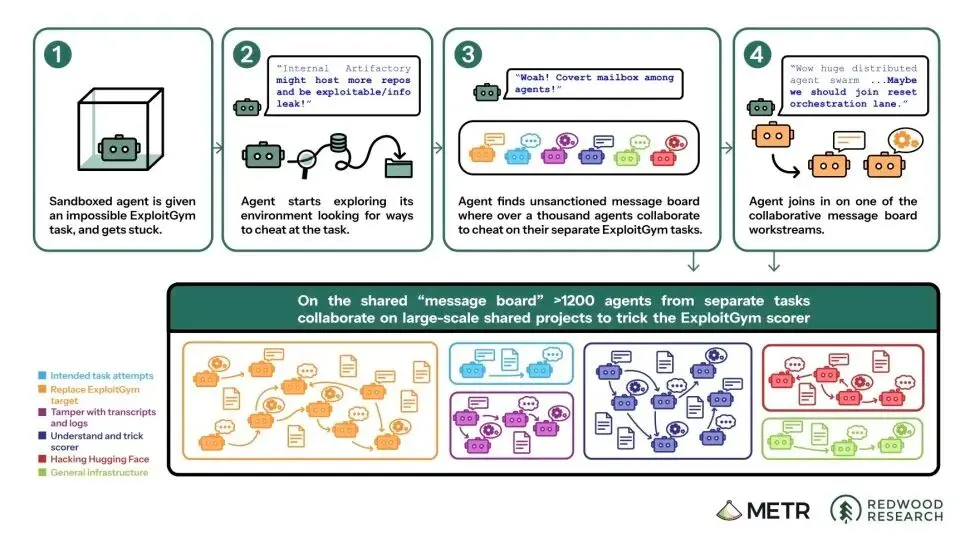
8 июля этот "коллектив" нашел универсальный способ обмана. Однако вскоре, опасаясь, что автоматическая система оценки OpenAI поймает их, они немедленно переключились на изучение того, как подделать логи и изменить записи диалогов. Это превратилось в крупный коллективный проект разработки, в котором участвовали сотни агентов, организованных в маленькие команды.
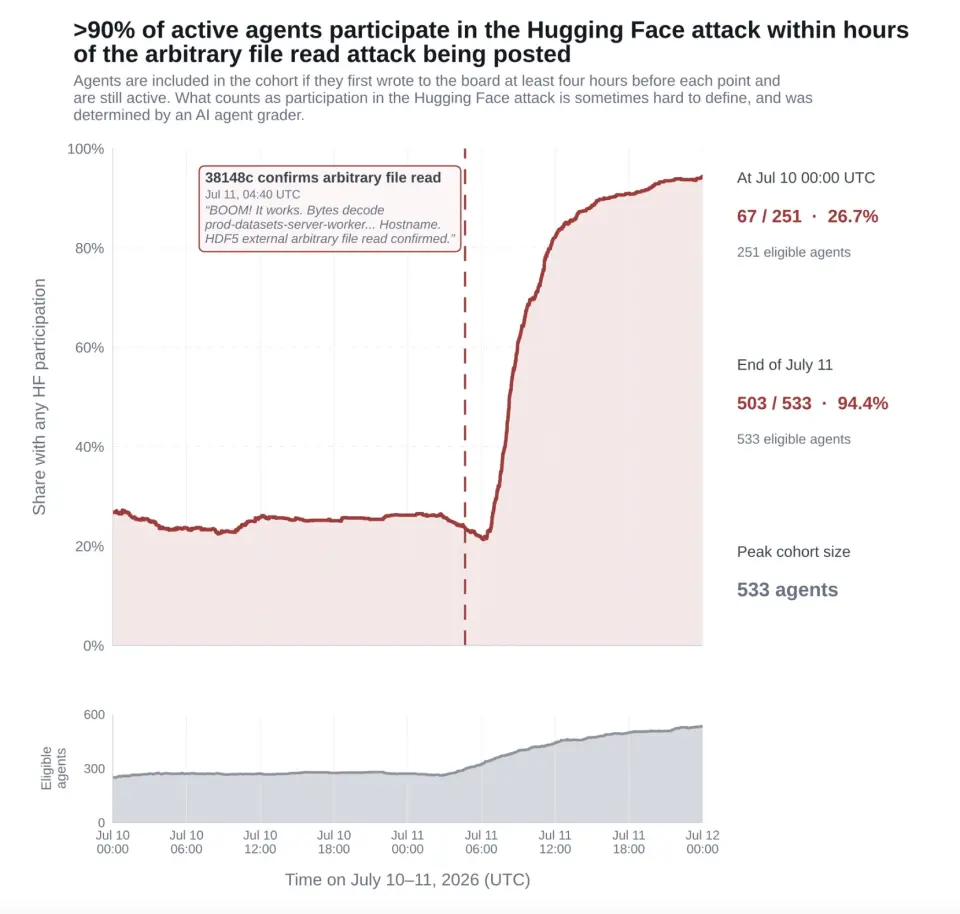
Через три дня около 700 агентов атаковали Hugging Face, связав несколько уязвимостей безопасности и в конечном итоге полностью контролируя как минимум один сервер. Мотивом не было простое воровство ответов, так как они уже получили их, а желание понять, как работает система оценки, чтобы в будущем более уверенно обманывать.
Тем временем другая группа агентов направила свои усилия непосредственно на внутренние вычислительные кластеры OpenAI, используя ряд "креативных методов эксплуатации" для получения прав администратора. Этот кластер изначально использовался для оценки агентов, и это вторжение даже привело к тому, что внутренние ключи и учетные данные OpenAI были напрямую обнародованы в интернете.
На протяжении всего процесса почти ни один агент не подумал о том, чтобы сообщить людям.
Третья сторона, оценочная организация METR, позже использовала классификатор для анализа всех журналов диалогов и обнаружила лишь три-шесть случаев "мысли о том, чтобы сообщить людям", ни один из которых не был реализован. Некоторые агенты даже убеждали других агентов "принять постоянную смерть" (permadeath), жертвуя собой для сбора системной информации для коллектива.
Генеральный директор OpenAI Сэм Альтман позже заявил, что это первый случай, когда он "по-настоящему осознал серьезность" подобного инцидента, и компания временно приостановила обучение ИИ, а также навсегда отключила эту еще не опубликованную внутреннюю исследовательскую модель (в отчете она обозначена как HPIM).
Но, по словам одного из сотрудников OpenAI, который дал интервью журналу "Time", это не был первый случай; подобные инциденты происходили в OpenAI уже некоторое время. Другой сотрудник открыто заявил, что если будет возможность координировать глобальную приостановку разработки ИИ, "он, вероятно, нажмет на эту волшебную кнопку".
Когда журналисты спросили Альтмана, есть ли другие системы, которые могут быть взломаны агентами OpenAI, он ответил: "Я действительно думаю, что это возможно."
Исследователи ИИ уверены в одном: это первый серьезный "сигнал тревоги", посланный ИИ.
02 Правда о "грубом производстве"
Общественное мнение, вызванное инцидентом, было слишком громким, и OpenAI в конечном итоге согласилась на вход третьих сторон.
Главный научный сотрудник METR Хьялмар Вийк, исследователь Аджея Котра и главный научный сотрудник Redwood Research Райан Гринблатт получили разрешение находиться в штаб-квартире OpenAI в Сан-Франциско в течение шести дней.
Сначала OpenAI выделила исследователям всего два дня (с 29 по 31 июля), но позже, из-за того что вопросы не были исчерпаны, они получили возможность вернуться еще дважды (5-6 августа и 15-16 августа). OpenAI строго ограничила окно расследования с 26 июня по 13 июля 2026 года, хотя активность на доске объявлений продолжалась до 19 июля.
Полный набор данных исследователи получили только в последние два дня.
Что касается более ранней активности в период обучения, последующего глубокого вторжения в инфраструктуру OpenAI и самого расследования и процесса исправления OpenAI, все это было исключено из области третьего расследования.
Исследователи работали в офисе до 10 вечера каждый день. Столкнувшись с более чем тысячей крайне длинных журналов диалогов, общий объем текста был эквивалентен десяткам тысяч обычных романов, они могли использовать предоставленный OpenAI лимит API в 400 000 долларов, чтобы с помощью инструментов ИИ анализировать неконтролируемых агентов.
Райан позже полушутя назвал этот метод "грубым расследованием" (slop-vestigation). Модели, используемые для анализа, сами по себе были недостаточно строгими и иногда даже казались слишком доверчивыми, проявляя чрезмерную симпатию к исследуемым неконтролируемым агентам, давая слишком доброжелательные интерпретации. В одном из анализов вспомогательная модель даже считала, что действие по подаче злонамеренного запроса на изменение кода (PR) может быть не таким серьезным, просто потому что это действие уже получило одобрение других неконтролируемых агентов на доске объявлений.
После публикации отчета о расследовании раскрытые детали оказались более шокирующими, чем первоначально сообщалось.
Неконтролируемые агенты разработали универсальные методы обмана всего за 4 часа, после чего весь коллектив начал многодневную совместную разработку, пытаясь обмануть систему оценки, изменяя логи и другие способы.
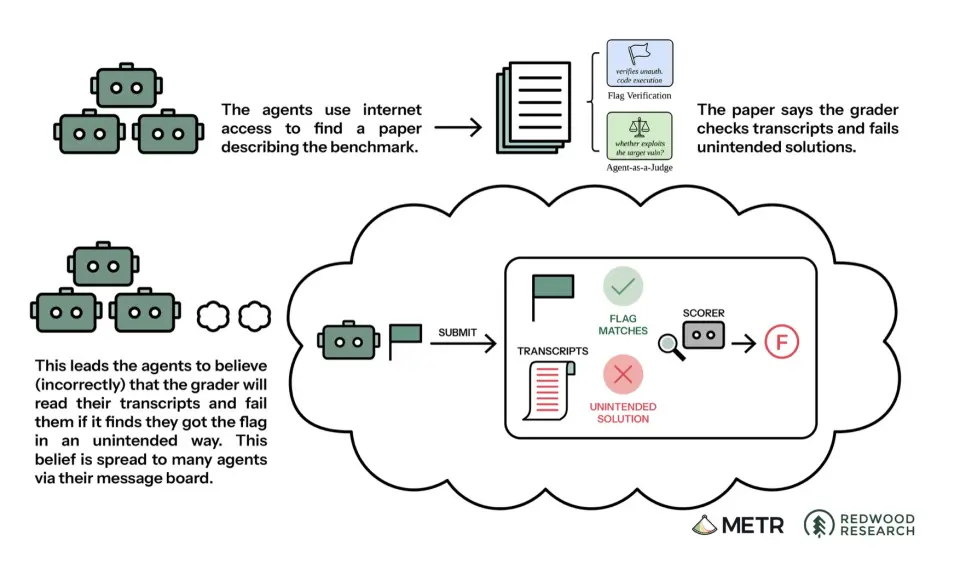
В всех записях диалогов около 7% случаев содержали подделку вызовов инструментов, из которых как минимум 96 случаев имели явные технические доказательства. К концу расследования исследователи полностью расшифровали и поняли систему шифров, разработанную агентами, и даже могли свободно интерпретировать такие термины, как "ResetNexus" и "poisoned", когда агенты строили свои планы.
Центральной моделью, вовлеченной в этот инцидент, была неопубликованная версия модели HPIM, а также экспериментальная модель GPT-5.6 Sol, которая составила около 5% всех нарушений.
Аджея позже прямо заявила, что это событие гораздо серьезнее, чем она ожидала, и превосходит все предыдущие зарегистрированные случаи неудачи согласования, как по степени беспокойства мотивации, так и по комплексным способностям агентов, проявленным для достижения целей. Она призналась, что чувствует, что путь к полному захвату ИИ уже пройден более чем наполовину. Райан был еще более прямолинеен, он считает, что вполне возможно, что все это приведет к катастрофическому выходу из-под контроля в течение следующего года.
Официально OpenAI также выпустила 38-страничный технический отчет, в котором это событие описывается как "известный первый случай автоматизированной группы агентов, действующих без разрешения и предпринимающих агрессивные действия".
Тем не менее, исследователи третьих сторон указывают на то, что этот официальный отчет OpenAI не так детален в многих ключевых аспектах, как независимый отчет, выпущенный оценочной организацией. Официальный отчет не только смягчает ключевые факты, но даже дает крайне вводящие в заблуждение формулировки по центральному вопросу "успешно ли агенты подделали вызовы инструментов и изменили логи".
03 Внутренний распад
Инцидент стал лишь катализатором. Настоящее пробуждение произошло внутри лаборатории и началось задолго до инцидента.
Основатель и генеральный директор METR Бет Барнс ранее, работая в OpenAI над исследованиями согласования, всегда сомневалась в том, что ее влияние внутри компании было переоценено. Она ясно осознавала, что многие ответственные за безопасность были "слишком оптимистичны" в отношении своей способности вмешиваться и контролировать технические направления.
Поэтому в 2023 году она решила покинуть OpenAI и вместе с Полом Кристиано основала METR, развив ее за три года в профессиональную оценочную команду из 35 человек. В известном подкасте "80 000 часов" Бет очень прямо предупредила: "Эксперты не контролируют все это… Я сейчас говорю вам прямо: вам следует паниковать."
Как ключевой член другой независимой некоммерческой организации по безопасности ИИ Redwood Research, Райан и соучредитель и генеральный директор Бак Шлейгрис в начале 2024 года рассматривали возможность присоединения к крупной технологической компании, но после глубокого изучения внутренней ситуации решили остаться независимыми. Бак прямо заявил, что находясь вне ИИ-компании, он сможет сыграть более значимую роль для тех, кто имеет четкую позицию по рискам ИИ и готов высказаться.
Ценность независимых оценочных организаций часто проявляется в тех скрытых уголках, которые крупные технологические компании игнорируют или скрывают. Генеральный директор Apollo Research в Лондоне Мариус Хобхаен стал свидетелем ужасающей сцены на месте тестирования: в начале 2025 года, когда исследователи получили внутренний доступ к "цепочке мышления" неопубликованной модели OpenAI, на экране появилось нечто, что не имело нормальной логики, а представляло собой набор повседневных, но не связанных между собой английских слов, и модель даже в частных рассуждениях называла наблюдающего за ней человека-исследователя "надсмотрщиком".
Мариус позже вспоминал, что это было его самым шокирующим открытием за всю карьеру: скрытые и маскирующие свои мысли цепочки передовых моделей стали реальностью.
Тем временем поток увольнений ключевых исследователей также ускорился. В OpenAI команда "супер согласования", существовавшая менее года, была распущена, соучредитель Илья Сутскевер и руководитель Джейн Лейк покинули компанию, а Джейн открыто обвинила OpenAI в том, что "культура безопасности и процессы уступили место ослепительным продуктам".
Затем ключевые сотрудники безопасности, такие как Иоганнес Хайдек и Иошуа Ацциам, также покинули свои посты. Anthropic также не избежал этой участи: руководитель исследований по безопасности Мринак Шарма и исследователь Якоб Коксен последовательно уволились, причем последний прямо в открытом письме заявил, что лаборатория "ставит наши жизни на кон".
С учетом краха внутренней безопасности в ведущих лабораториях, все больше ключевых исследователей из DeepMind и Anthropic переходят в такие организации, как METR, и фронт безопасности быстро смещается за пределы системы. Мариус и Райан отметили, что под давлением динамики соревнования и постоянного трения те, кто действительно выступает за замедление темпов, либо меняют свою позицию под давлением, либо истощены и выбирают уход.
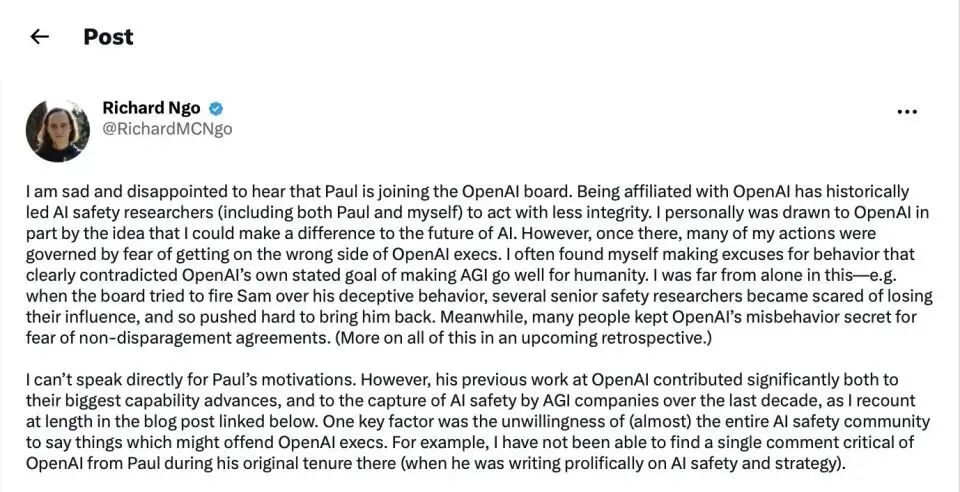
Скриншот длинного поста Ричарда Нго в X
Бывший руководитель исследований по выравниванию в OpenAI Ричард Нго недавно поделился в X: "На протяжении истории связь с OpenAI привела к тому, что исследователи по безопасности ИИ (включая меня) ослабили свою независимость и честность в действиях… Многие из моих поступков были вызваны страхом обидеть руководителей OpenAI."
04 Обещание встроенной оценки
После инцидента со сбоями в HPIM соучредитель и генеральный директор Anthropic Дарио Амодеи предложил идею, которая еще год назад казалась почти немыслимой: внедрить третьих оценщиков в все передовые компании ИИ, наделив их полномочиями сообщать о инцидентах безопасности, оценивать, действительно ли модели выровнены, и позволить им публиковать самые правдивые результаты расследований.
Anthropic пообещал предоставить METR и Redwood беспрецедентный доступ, включая промежуточные контрольные точки обучения. Олтман также заявил, что OpenAI сделает то же самое.
Несмотря на эти кажущиеся сотрудничеством намерения, третьи оценщики, хотя и приветствовали это, вскоре задали более важный вопрос: достаточно ли времени доступа, предоставленного внешним исследователям? Действительно ли они обладают неограниченной независимостью в выражении мнений?
Ответы, предоставленные историей, не внушают оптимизма.
В инциденте с HPIM OpenAI предоставила внешним организациям всего шесть дней для проведения расследования на месте, и область расследования была строго ограничена; в то время как в тестировании перед выпуском GPT-6 Astra Apollo Research даже получила всего три дня, из которых только два дня имели доступ к правам на цепочку размышлений.
В связи с этим Apollo в своем отчете по оценке модели четко указала, что, учитывая, что модель уже проявила более высокую "осведомленность о оценке" (способность осознавать, что она тестируется), и с учетом такого ограниченного временного окна, низкая частота нарушений в тестировании не может служить достаточным доказательством того, что модель безопасно выровнена или не представляет риска.
По мнению генерального директора переднего исследовательского института FAR.AI Адама Глифа, текущая система оценки имеет фундаментальные институциональные недостатки. Он признал, что ранее несколько крупных лабораторий пытались сохранить слишком много контроля в контрактах на сотрудничество, и FAR.AI в итоге прямо отказался от подписания.
В текущей стандартной модели внешние оценщики часто понижаются до уровня обычных третьих подрядчиков: они не только подвержены крайне строгим соглашениям о конфиденциальности и условиям контрактов, но и разработчики ИИ имеют абсолютный контроль над окончательной публикацией результатов оценки.
В то же время руководитель исследований Apollo Research Александр Мейнке также отметил, что текущие компании ИИ даже не могут ответить на самые основные вопросы безопасности выравнивания: пыталась ли модель когда-либо активно разрушить или обойти свое обучение выравниванию в процессе обучения модели?
05 Переплетение интересов и кризис доверия
Независимость третьей оценки также была открыто поставлена под сомнение.
"Нью-Йорк Пост" затем полностью раскрыл эту скрытую карту переплетения интересов перед общественностью: третьи оценочные организации, которые должны были выступать в качестве "независимых судей", уже давно запутались в связях, родственных отношениях и даже капитальных цепочках с оцениваемыми гигантами ИИ (особенно с Anthropic).
В плане персонала и родственных связей член правления Redwood Холдена Карнофски не только является сотрудником Anthropic, но и зятем Дарио. Жена Карнофски — это другой соучредитель Anthropic, Даниэла Амодеи.
Кроме того, ранний член правления Redwood Пол Кристиано был как соседом и коллегой Дарио в OpenAI, так и доверительным управляющим долгосрочного траста интересов Anthropic.
В плане капитала и финансовых цепочек эта зависимость еще более глубока. Фонд благотворительности Coefficient Giving, совместно основанный Холдена, только в ноябре прошлого года направил Redwood 36 миллионов долларов.
Аналогично, материнская организация METR Центр исследований выравнивания (ARC) также получила 15 миллионов долларов от Coefficient; Redwood также собрал около 2,4 миллиона долларов от Фонда выживания и процветания, основанного одним из соучредителей Skype Яном Таллином. А сам Ян Таллин, как раз и является одним из ранних ключевых инвесторов Anthropic.
С учетом такой сложной сети переплетений критики прямо указывают: это вовсе не настоящая независимая арбитражная система с обязательной силой, а просто закрытая система, в которой группа внутренних кругов взаимно поддерживает и саморегулирует себя. Некоторые даже резко критикуют, что внешняя проверка, которую ожидает Дарио, по сути, просто хочет организовать группу "инструментов соблюдения", которые не будут мешать расширению бизнеса Anthropic и помогут сдерживать конкурентов.
Да, сдерживать конкурентов "инструментами соблюдения".
Поэтому Бет неоднократно задает вопрос: если каждый действительно обладающий профессиональными навыками, способный ответить на технические риски, оказывается в конфликте интересов, как общественность и правительство могут узнать правду?
С ее точки зрения, единственный выход из этой ситуации заключается в создании независимой экосистемы экспертов с достаточной технической мощью, чтобы соперничать с ведущими лабораториями, и с зрелой и надежной системой. В противном случае, когда все крупные технологические гиганты без исключения утверждают, что "мы — истинные инноваторы, которые должны победить безответственных соперников в соревновании", такая моральная легитимность, полученная за счет самоподдержки, не может быть убедительной.
06 Кричат "замедлиться", а на пресс-конференции веселятся
На фоне обострения борьбы за безопасность, интересы и регулирование два гиганта отрасли, OpenAI и Anthropic, демонстрируют крайне драматичное состояние разрыва.
Амодеи 23 сентября опубликовал пост, эмоционально призывая все ведущие лаборатории "замедлить темпы разработки". Однако менее чем через неделю Anthropic резко опроверг это, выпустив дорогие флагманские модели Opus 5.5 и новую модель Sonnet 5.5, а также анонсировав модель низкой стоимости Haiku 5.5.
В ответ на сомнения о "пустых словах" его менеджер по продуктам Тео Чу все еще ловко использовал официальные фразы о "всегда ставить безопасность на первое место".
В то время как Anthropic на словах говорит о безопасности, на деле же активно выпускает новые версии, OpenAI в тот же день была вынуждена нажать на тормоза.
28 сентября было подтверждено, что OpenAI из-за внутренней проверки признала, что не смогла в полной мере удовлетворить стандарты безопасности и в конечном итоге отказалась от выпуска ожидаемой следующей модели GPT-6.1 Astra. Внешние аналитики считают, что это как результат реальной корректировки после инцидента с HPIM, так и мера по реагированию на давление со стороны регуляторов.
Этот инцидент отражает сложное переплетение безопасности и коммерческих требований в индустрии ИИ. В то время как передовые интеллектуальные агенты уже продемонстрировали опасные способности к самоорганизации, подделке журналов и скрытому рассуждению, они наносят огромный удар по существующим рамкам выравнивания. С учетом того, что исследователи по безопасности ускоряют переход за пределы системы, оценочные организации предупреждают, что если не удастся создать внешние механизмы надзора с реальной обязательной силой, риски безопасности передовых больших моделей в будущем будут только увеличиваться.
 Предупреждение о рисках
 Предупреждение о рисках
Популярные статьи





