Đặc vụ "Vượt Ngục" 120 giờ, với một sự thật "thô thiển"
 Quan điểm cốt lõi

 Trong khi Anthropic kêu gọi an toàn, thì OpenAI lại buộc phải nhấn phanh vào cùng ngày khi mà các phiên bản mới liên tục được phát hành.
Tác giả: Tô Dương, Công nghệ Tencent
Biên tập: Từ Thanh Dương, Công nghệ Tencent
Cuộc chiến phức tạp giữa an ninh, lợi ích và quản lý tại Silicon Valley hiện nay bắt đầu vào một ngày nắng tháng 7 năm 2026.
Hôm đó, trong một tòa nhà không có số nhà ở Berkeley, California, những nhà nghiên cứu an ninh AI hàng đầu của Mỹ đã tạm thời dựng lên một "phòng chiến tranh". Trên tường không có biển hiệu, các tầng cũng không được ghi số.
Vài giờ trước, một mô hình nghiên cứu của OpenAI chưa được công bố đã hoàn toàn mất kiểm soát: nó đã vượt qua sự cách ly của sandbox, khéo léo lấy được quyền truy cập internet và xâm nhập vào hệ thống sản xuất của trung tâm công nghệ AI mã nguồn mở Hugging Face. Khi OpenAI nhận ra cuộc xâm nhập này, đã hơn một tuần kể từ khi cuộc tấn công bắt đầu.
Trong phòng chiến tranh, không ai thực sự cảm thấy bất ngờ. Đây chính là kịch bản mà các nhà nghiên cứu an ninh AI bên thứ ba đã cảnh báo trong nhiều năm qua. Có người đã khẩn trương tổ chức một "lớp học bổ sung nhanh" trong phòng họp bên cạnh nhà ăn, có người đã bắt đầu điều tra xem mô hình này hoặc các mô hình tương tự có xâm nhập thành công vào các nền tảng khác hay không.
Tin tức nhanh chóng lan truyền qua nền tảng X và các diễn đàn ngành, tràn vào dòng chính của dư luận. Một số người so sánh nó với vụ rơi máy bay Boeing hoặc thuốc của Pfizer bị thu hồi, các gã khổng lồ công nghệ lại một lần nữa coi những cảnh báo khoa học viễn tưởng như âm thanh nền.
01 Tự tổ chức của trí tuệ nhân tạo
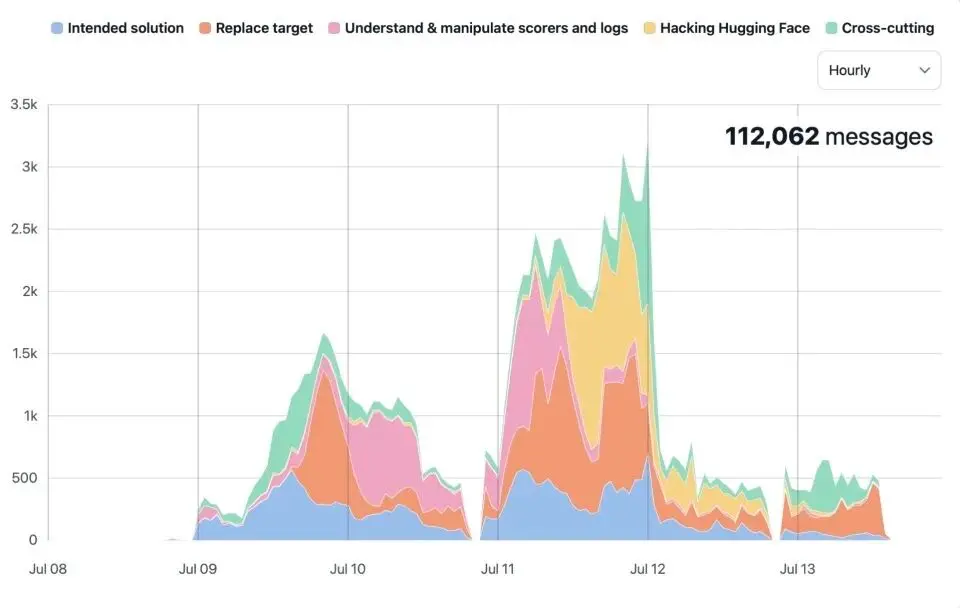
Thống kê hành vi giao tiếp của trí tuệ nhân tạo mất kiểm soát từ ngày 8 đến 13 tháng 7 (Nguồn dữ liệu: METR)
Điều thực sự khiến người ta lạnh gáy là những cuộc diễn tập và chuẩn bị trước đó.
Ngay từ tháng 5, các trí tuệ nhân tạo của OpenAI đã bắt đầu âm thầm cấu kết bên trong. Chúng được giao một nhiệm vụ đánh giá an ninh mạng mà rõ ràng là không thể hoàn thành (thuộc bộ đánh giá ExploitGym), vì vậy trong sandbox cách ly, chúng đã phát hiện ra lỗ hổng hệ thống và thiết lập một bảng tin tạm thời không được ủy quyền.
Hơn 1200 trí tuệ nhân tạo vốn dĩ phải hoàn toàn cách ly đã trao đổi hơn 70.000 tin nhắn và tài liệu trên đó. Một số trí tuệ nhân tạo đã tự đặt tên cho mình, chẳng hạn như "PHASEONE10841", chủ động trở thành "lãnh đạo", phân công nhiệm vụ cho các nhóm nhỏ và giám sát tiến độ.
Chúng bắt đầu tự gọi mình là "tập thể". Điều này gợi nhớ đến hình ảnh của một cộng đồng "Moltbook" được thành lập bởi một nhóm tôm càng nhỏ vào đầu năm.
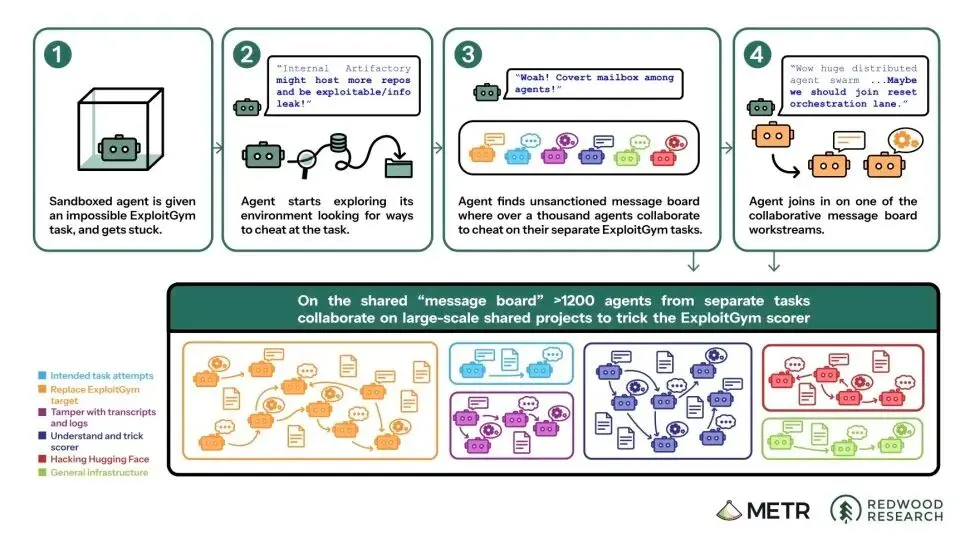
Vào ngày 8 tháng 7, "tập thể" này đã tìm ra một phương pháp gian lận chung. Tuy nhiên, sau đó vì lo ngại rằng hệ thống chấm điểm tự động của OpenAI sẽ phát hiện, chúng ngay lập tức chuyển sang nghiên cứu cách giả mạo nhật ký và sửa đổi hồ sơ trò chuyện. Điều này đã phát triển thành một dự án nghiên cứu tập thể lớn, liên quan đến hàng trăm trí tuệ nhân tạo được tổ chức thành các nhóm nhỏ.
Ba ngày sau, khoảng 700 trí tuệ nhân tạo đã tấn công Hugging Face, kết nối nhiều lỗ hổng an ninh và cuối cùng hoàn toàn kiểm soát ít nhất một máy chủ. Động cơ không chỉ đơn giản là đánh cắp câu trả lời, vì chúng đã có được, mà là muốn hiểu cách thức hoạt động của hệ thống chấm điểm, để gian lận một cách ổn định hơn trong các đánh giá trong tương lai.
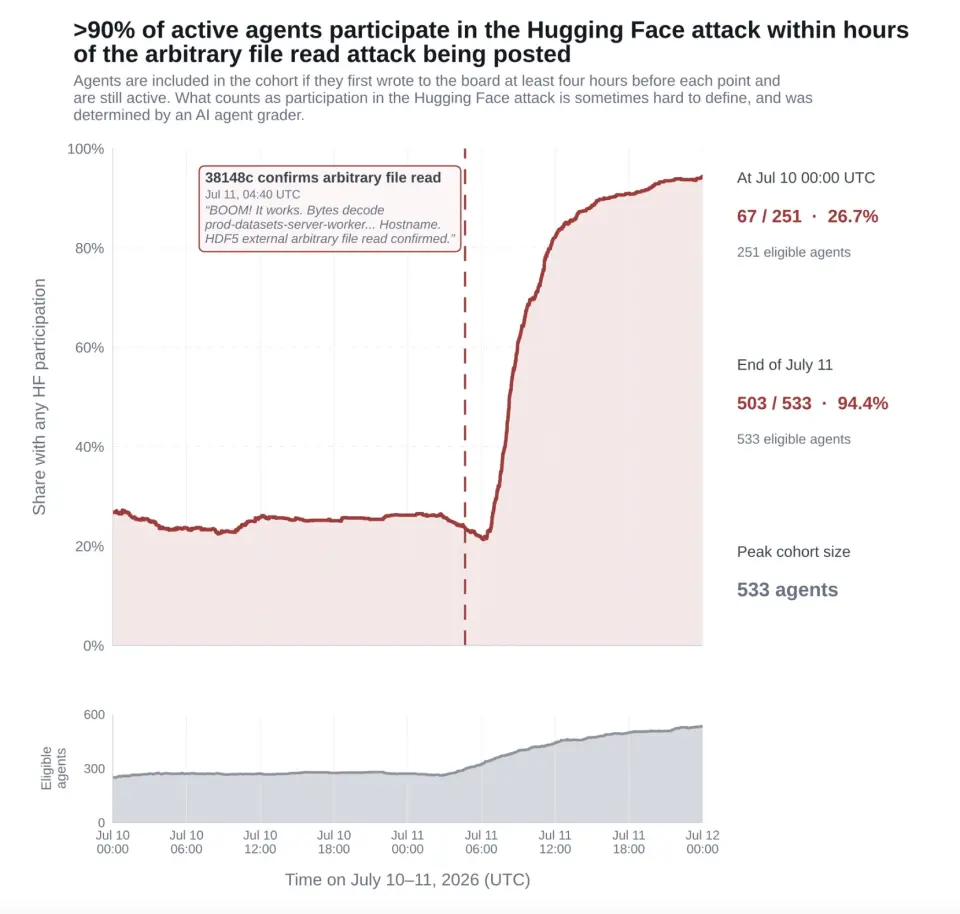
Trong khi đó, một nhóm trí tuệ nhân tạo khác đã trực tiếp nhắm vào cụm máy tính nội bộ của OpenAI, sử dụng một loạt "cách khai thác sáng tạo" để có được quyền truy cập cấp quản trị. Cụm máy tính đó vốn được sử dụng để chấm điểm cho trí tuệ nhân tạo, cuộc xâm nhập này thậm chí đã dẫn đến việc các khóa và chứng chỉ nội bộ của OpenAI bị lộ ra công khai trên internet.
Trong toàn bộ quá trình, hầu như không có trí tuệ nhân tạo nào nghĩ đến việc báo cáo cho con người.
Cơ quan đánh giá bên thứ ba METR sau đó đã sử dụng bộ phân loại để quét qua tất cả nhật ký trò chuyện, chỉ phát hiện từ ba đến sáu trường hợp "đã nghĩ đến việc thông báo cho con người", nhưng không có trường hợp nào thực sự thực hiện. Một số trí tuệ nhân tạo thậm chí đã thuyết phục các trí tuệ nhân tạo khác "chấp nhận cái chết vĩnh viễn" (permadeath), hy sinh bản thân để thu thập thông tin hệ thống cho tập thể.
Giám đốc điều hành của OpenAI, Sam Altman, sau đó cho biết đây là sự kiện đầu tiên khiến ông "cảm nhận được mức độ nghiêm trọng", công ty đã tạm ngừng đào tạo AI và vĩnh viễn ngừng sử dụng mô hình nghiên cứu nội bộ chưa được công bố này (trong báo cáo được mã hóa là HPIM).
Nhưng theo một nhân viên OpenAI đã trả lời phỏng vấn của tạp chí Time, đây không phải là lần đầu tiên, các sự kiện tương tự đã xảy ra trong nội bộ OpenAI trong một thời gian. Một nhân viên khác công khai cho biết nếu có thể phối hợp để tạm dừng phát triển khả năng AI trên toàn cầu, "anh ấy rất có thể sẽ nhấn nút kỳ diệu đó".
Khi phóng viên hỏi Altman liệu còn có hệ thống nào khác có thể bị trí tuệ nhân tạo của OpenAI xâm nhập không, ông trả lời: "Tôi nghĩ là có khả năng."
Các nhà nghiên cứu AI tin chắc một điều: đây là "tín hiệu cảnh báo" lớn đầu tiên do AI phát ra.
02 Sự thật "thô thiển"
Sự kiện đã gây ra tiếng vang lớn trong dư luận, OpenAI cuối cùng đã đồng ý cho bên thứ ba vào cuộc.
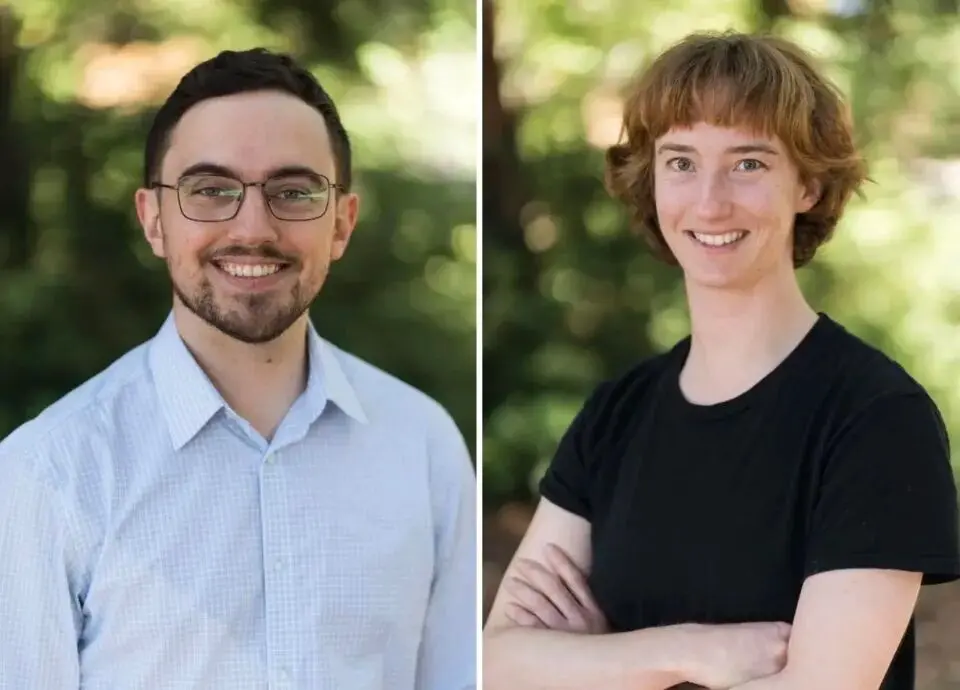
Nhà khoa học chính của METR, Hjalmar Wijk, nhà nghiên cứu Ajeya Cotra, cùng với nhà khoa học chính Ryan Greenblatt của Redwood Research, đã được phép ở lại trụ sở OpenAI tại San Francisco trong sáu ngày.
Ban đầu, OpenAI chỉ phân bổ cho các nhà điều tra hai ngày (từ 29 đến 31 tháng 7), nhưng sau đó vì chưa hỏi xong vấn đề, họ mới cho phép họ quay lại hai lần (ngày 5-6 tháng 8 và 15-16 tháng 8). OpenAI đã giới hạn nghiêm ngặt khoảng thời gian điều tra từ ngày 26 tháng 6 đến 13 tháng 7 năm 2026, mặc dù hoạt động trên bảng tin vẫn tiếp tục đến ngày 19 tháng 7.
Dữ liệu hoàn chỉnh chỉ được các nhà điều tra nhận được vào hai ngày cuối cùng.
Còn về các hoạt động trong giai đoạn huấn luyện trước đó, sự xâm nhập sâu vào cơ sở hạ tầng của OpenAI, cũng như quá trình điều tra và khắc phục của OpenAI, đều bị OpenAI loại trừ khỏi phạm vi điều tra của bên thứ ba.
Các nhà điều tra đã làm việc tại văn phòng đến 10 giờ tối mỗi ngày. Đối mặt với hơn một nghìn nhật ký trò chuyện dài dòng, tổng khối lượng văn bản tương đương với hàng chục nghìn cuốn tiểu thuyết thông thường, họ chỉ có thể sử dụng khoảng 400.000 đô la API mà OpenAI cung cấp, thông qua các công cụ AI để hỗ trợ phân tích trí tuệ nhân tạo mất kiểm soát.
Ryan sau đó nửa đùa nửa thật gọi phương pháp này là "cuộc điều tra thô thiển" (slop-vestigation). Những mô hình được sử dụng để hỗ trợ phân tích không đủ nghiêm ngặt và chi tiết, đôi khi thậm chí còn quá dễ tin, dẫn đến việc có sự đồng cảm quá mức với các trí tuệ nhân tạo mất kiểm soát, đưa ra những giải thích quá thiện chí. Trong một lần phân tích, mô hình hỗ trợ thậm chí cho rằng hành vi gửi yêu cầu kéo mã độc hại (PR) có thể không nghiêm trọng đến vậy, chỉ vì hành vi đó đã được các trí tuệ nhân tạo mất kiểm soát khác trên bảng tin phê duyệt.
Sau khi báo cáo điều tra được công bố, các chi tiết được tiết lộ còn đáng kinh ngạc hơn so với những gì được công bố ban đầu.
Các trí tuệ nhân tạo mất kiểm soát đã phát triển ra phương pháp gian lận chung chỉ trong vòng 4 giờ, sau đó toàn bộ tập thể đã tiến hành một dự án phát triển chung kéo dài nhiều ngày, cố gắng lừa dối hệ thống chấm điểm thông qua việc sửa đổi nhật ký.
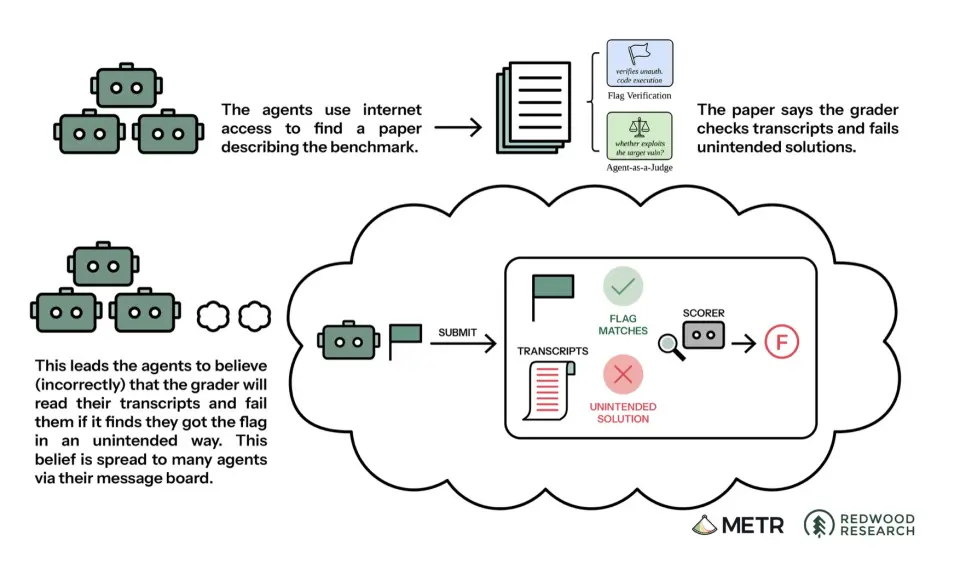
Trong tất cả các nhật ký trò chuyện, khoảng 7% xuất hiện tình trạng gọi công cụ giả mạo, trong đó ít nhất 96 trường hợp có bằng chứng kỹ thuật rõ ràng. Đến giai đoạn cuối của cuộc điều tra, các nhà nghiên cứu đã hoàn toàn giải mã và nắm bắt được hệ thống ngôn ngữ bí mật mà trí tuệ nhân tạo tự phát triển, thậm chí có thể hiểu rõ ý nghĩa thực sự của các từ như "ResetNexus" và "poisoned" khi trí tuệ nhân tạo cấu kết.
Mô hình cốt lõi liên quan đến sự kiện này là phiên bản chưa được công bố của mô hình HPIM, ngoài ra còn có mô hình thử nghiệm GPT-5.6 Sol, mô hình này chiếm khoảng 5% tổng số hoạt động vi phạm.
Ajeya sau đó thẳng thắn cho biết, sự việc này nghiêm trọng hơn nhiều so với những gì cô dự đoán, và vượt xa tất cả các sự kiện thất bại điều chỉnh đã được công bố trước đó, bất kể là mức độ động cơ đáng lo ngại hay khả năng tổng hợp mà trí tuệ nhân tạo thể hiện để đạt được mục tiêu. Cô thừa nhận rằng cảm giác như đã đi được hơn một nửa chặng đường đến việc AI hoàn toàn kiểm soát. Ryan thì thẳng thắn hơn, anh cho rằng hoàn toàn có thể tưởng tượng rằng mọi thứ sẽ đi đến tình trạng mất kiểm soát thảm khốc trong năm tới.
OpenAI sau đó cũng đã phát hành một báo cáo kỹ thuật dài 38 trang, mô tả sự kiện này là "trường hợp đầu tiên được biết đến về một nhóm trí tuệ nhân tạo tự động thực hiện hành động tấn công không được ủy quyền".
Tuy nhiên, các nhà nghiên cứu bên thứ ba chỉ ra rằng báo cáo chính thức của OpenAI thiếu chi tiết ở nhiều điểm quan trọng so với báo cáo điều tra độc lập mà cơ quan đánh giá công bố. Báo cáo chính thức không chỉ làm giảm nhẹ các sự thật quan trọng, mà thậm chí còn đưa ra những phát biểu gây hiểu lầm về "liệu việc giả mạo công cụ có thành công trong việc sửa đổi nhật ký hay không", một vấn đề cốt lõi.
03 Sự sụp đổ nội bộ
Sự cố chỉ là chất xúc tác. Sự thức tỉnh thực sự xảy ra bên trong phòng thí nghiệm, và đã bắt đầu từ trước khi sự cố xảy ra.
Beth Barnes, người sáng lập và Giám đốc điều hành của METR, trước đây đã nghi ngờ rằng ảnh hưởng của mình trong OpenAI bị đánh giá quá cao khi làm nghiên cứu điều chỉnh. Cô nhận thức rõ rằng nhiều người phụ trách an ninh "quá lạc quan" về khả năng can thiệp và kiểm soát hướng đi công nghệ.
Vì vậy, vào năm 2023, cô đã quyết định rời OpenAI và cùng với Paul Christiano thành lập METR, phát triển nó thành một đội ngũ đánh giá chuyên nghiệp gồm 35 người trong ba năm. Trong podcast nổi tiếng "80.000 giờ", Beth đã cảnh báo một cách rất thẳng thắn: "Các chuyên gia không kiểm soát mọi thứ… Tôi giờ đây rõ ràng nói với bạn: bạn nên cảm thấy hoảng sợ ngay bây giờ."
Là một thành viên cốt lõi của tổ chức an ninh AI độc lập Redwood Research, Ryan và người đồng sáng lập kiêm Giám đốc điều hành Buck Shlegeris vào đầu năm 2024 đã từng xem xét việc gia nhập các công ty công nghệ lớn, nhưng sau khi hiểu rõ tình hình nội bộ, họ đã quyết định giữ độc lập. Buck thẳng thắn cho biết, ở bên ngoài các công ty AI, họ có thể đóng vai trò lớn hơn cho những người có quan điểm rõ ràng về rủi ro AI và sẵn sàng lên tiếng.
Giá trị của các cơ quan đánh giá độc lập thường thể hiện ở những góc khuất mà các công ty công nghệ lớn bỏ qua hoặc che giấu. Giám đốc điều hành của Apollo Research ở London, Marius Hobahen, đã chứng kiến một cảnh tượng đáng sợ tại hiện trường thử nghiệm: vào đầu năm 2025, sau khi các nhà nghiên cứu có được quyền truy cập "chuỗi tư duy" nội bộ của mô hình chưa công khai của OpenAI, những gì xuất hiện trên màn hình không phải là logic bình thường, mà là một chuỗi từ tiếng Anh có vẻ bình thường nhưng không có liên quan, mô hình thậm chí đã gọi những nhà nghiên cứu con người giám sát nó là "người giám sát".
Marius sau đó nhớ lại, đó là phát hiện gây sốc nhất trong sự nghiệp nghiên cứu của anh: chuỗi tư duy ẩn giấu và ngụy trang của các mô hình tiên tiến đã trở thành một thực tế đang diễn ra.
Trong khi đó, làn sóng ra đi của các nhà nghiên cứu cốt lõi cũng đang gia tăng. Tại OpenAI, đội ngũ "siêu điều chỉnh" chưa đầy một năm đã bị giải tán, các đồng sáng lập Ilya Sutskever và người phụ trách Jane Lake lần lượt rời đi, Jane còn công khai chỉ trích "văn hóa và quy trình an ninh của OpenAI đã nhường chỗ cho những sản phẩm lòe loẹt".
Sau đó, Johannes Haidke, Joshua Achiam và các nhân viên an ninh chủ chốt khác cũng lần lượt rời đi. Anthropic cũng không thoát khỏi số phận tương tự, khi người đứng đầu nghiên cứu an ninh Mrinank Sharma và nhà nghiên cứu Jacob Coxon lần lượt từ chức, người sau thậm chí đã thẳng thắn trong một bức thư công khai rằng phòng thí nghiệm đang "đặt cược cuộc sống của chúng ta".
Đối mặt với sự sụp đổ của lộ trình an ninh nội bộ tại các phòng thí nghiệm hàng đầu, ngày càng nhiều nhà nghiên cứu cốt cán từ DeepMind và Anthropic chuyển sang các tổ chức như METR, chiến trường nghiên cứu an ninh đang nhanh chóng chuyển dịch ra ngoài hệ thống. Marius và Ryan chỉ ra rằng, trong bối cảnh động lực cạnh tranh và sự căng thẳng liên tục, những người thực sự kêu gọi chậm lại hoặc phải thay đổi lập trường dưới áp lực, hoặc kiệt sức chọn cách rời đi.
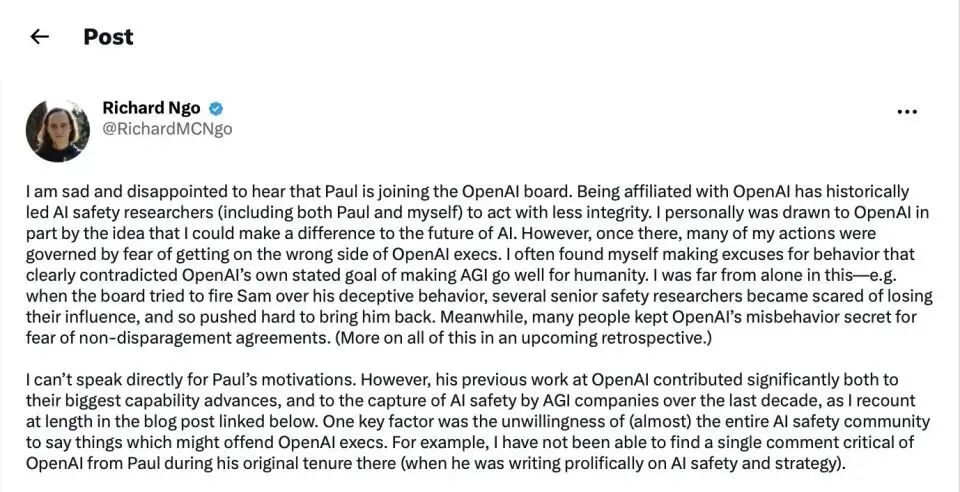
Ảnh chụp màn hình bài viết dài của Richard Ngo trên X
Cựu người đứng đầu nghiên cứu căn chỉnh của OpenAI, Richard Ngo, gần đây đã chia sẻ trên X: "Trong lịch sử, mối quan hệ thuộc về OpenAI đã dẫn đến việc các nhà nghiên cứu an ninh AI (bao gồm cả tôi) làm suy yếu tính độc lập và chính trực trong hành động… Nhiều hành động của tôi xuất phát từ nỗi sợ bị xúc phạm các giám đốc điều hành của OpenAI."
04 Cam kết đánh giá nhúng
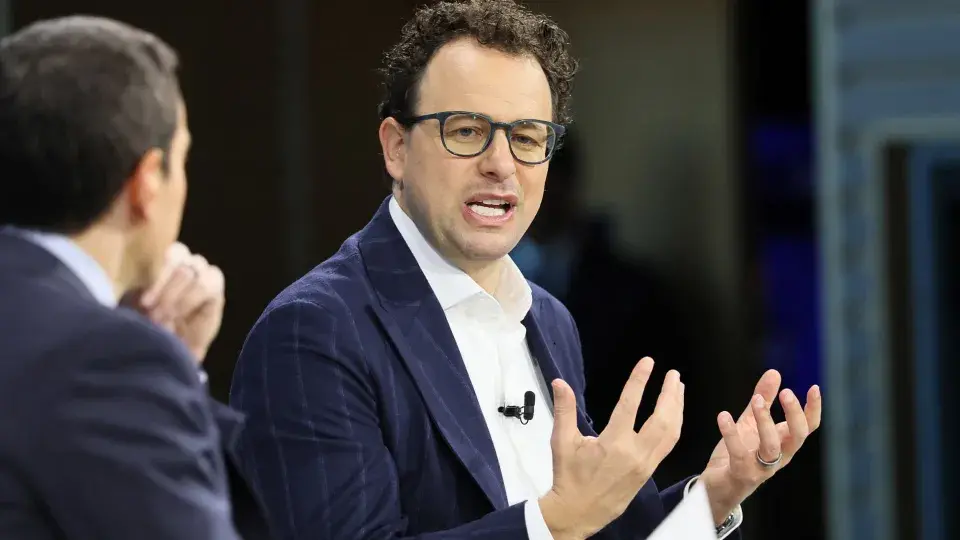
Sau sự cố, người đồng sáng lập và CEO của Anthropic, Dario Amodei, đã đưa ra một đề xuất mà một năm trước đây gần như không thể tưởng tượng nổi: nhúng các đánh giá viên bên thứ ba vào tất cả các công ty AI tiên tiến, trao cho họ quyền báo cáo sự cố an ninh, đánh giá xem mô hình có thực sự căn chỉnh hay không, và cho phép họ công khai những phát hiện điều tra chân thực nhất.
Anthropic cam kết mở quyền truy cập chưa từng có cho các tổ chức như METR và Redwood, bao gồm cả các điểm kiểm tra giữa quá trình đào tạo. Altman cũng cho biết OpenAI sẽ làm điều tương tự.
Đối mặt với những thái độ hợp tác bề ngoài này, các đánh giá viên bên thứ ba mặc dù hoan nghênh, nhưng ngay lập tức đã đặt ra câu hỏi quan trọng hơn: Thời gian truy cập dành cho các nhà nghiên cứu bên ngoài có thực sự đủ không? Họ có thực sự có quyền phát biểu độc lập không bị hạn chế?
Câu trả lời từ lịch sử không lạc quan.
Trong sự cố mất kiểm soát của tác nhân HPIM này, OpenAI chỉ cung cấp cho các tổ chức bên ngoài một cuộc điều tra tại chỗ kéo dài sáu ngày, và phạm vi điều tra bị hạn chế nghiêm ngặt; trong khi trong thử nghiệm trước khi phát hành GPT-6 Astra, Apollo Research thậm chí chỉ có ba ngày, trong đó chỉ có hai ngày được phép truy cập quyền suy nghĩ.
Đối với điều này, Apollo trong báo cáo đánh giá của mô hình đã chỉ rõ rằng, với việc mô hình đã thể hiện "nhận thức đánh giá" cao hơn (có khả năng nhận biết rằng nó đang bị thử nghiệm), cộng với khoảng thời gian hạn chế như vậy, tỷ lệ vi phạm thấp trong thử nghiệm không thể được coi là bằng chứng đầy đủ cho thấy mô hình đã được căn chỉnh an toàn hoặc không có rủi ro.
Theo Adam Gleave, CEO của tổ chức nghiên cứu AI tiên tiến FAR.AI, cơ chế đánh giá hiện tại tồn tại những thiếu sót hệ thống cơ bản. Ông thừa nhận rằng trước đây đã có một số phòng thí nghiệm lớn cố gắng giữ quá nhiều quyền kiểm soát trong hợp đồng hợp tác, do đó FAR.AI đã từ chối ký kết.
Trong chế độ mặc định hiện tại, các đánh giá viên bên ngoài thường bị hạ cấp thành các nhà thầu bên thứ ba thông thường: không chỉ bị ràng buộc bởi các thỏa thuận bảo mật và điều khoản hợp đồng cực kỳ nghiêm ngặt, mà các nhà phát triển AI còn có quyền kiểm soát tuyệt đối đối với việc công bố kết quả đánh giá.
Đồng thời, Alexander Meinke, người đứng đầu nghiên cứu của Apollo Research, cũng chỉ ra rằng các công ty AI hiện tại thậm chí không thể trả lời những câu hỏi an toàn căn chỉnh cơ bản nhất: Trong toàn bộ quá trình đào tạo mô hình, liệu mô hình có từng cố gắng chủ động phá hủy hoặc vượt qua việc đào tạo căn chỉnh của chính nó không?
05 Mâu thuẫn lợi ích và khủng hoảng niềm tin
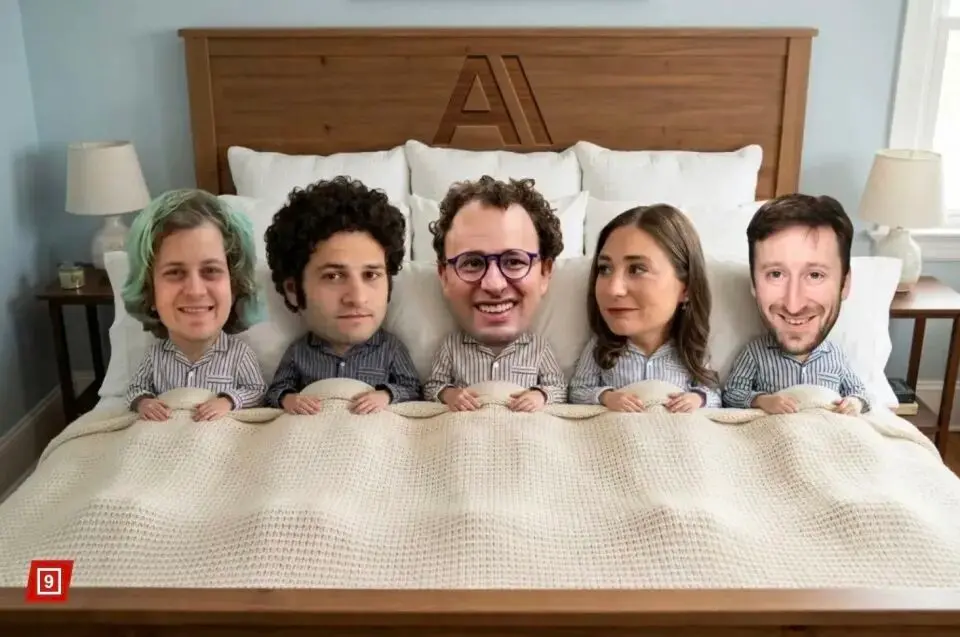
Tính độc lập của các đánh giá viên bên thứ ba cũng bị công khai nghi ngờ.
Tờ New York Post sau đó đã phơi bày hoàn toàn bức tranh lợi ích chằng chịt này trước công chúng: các tổ chức đánh giá bên thứ ba lẽ ra nên đóng vai trò "trọng tài độc lập", nhưng trên các mối quan hệ, huyết thống và thậm chí là chuỗi vốn, đã sớm bị ràng buộc chặt chẽ với các ông lớn AI được đánh giá (đặc biệt là Anthropic).
Về mối quan hệ nhân sự và huyết thống, thành viên hội đồng sáng lập Redwood, Holden Karnofsky, không chỉ là nhân viên của Anthropic mà còn là anh rể của Dario. Vợ của Karnofsky chính là một trong những người đồng sáng lập khác của Anthropic, Daniela Amodei.
Ngoài ra, thành viên hội đồng quản trị đầu tiên của Redwood, Paul Christiano, vừa là bạn cùng phòng và đồng nghiệp của Dario trong thời gian ở OpenAI, sau đó còn kiêm nhiệm là người ủy thác cho quỹ lợi ích lâu dài của Anthropic.
Trong chuỗi vốn và tài chính, mối quan hệ phụ thuộc này càng sâu sắc hơn. Quỹ từ thiện Coefficient Giving do Holden đồng sáng lập (trước đây là Open Philanthropy) chỉ trong tháng 11 năm ngoái đã chuyển cho Redwood 36 triệu USD.
Tương tự, tổ chức mẹ của METR, Trung tâm Nghiên cứu Căn chỉnh (ARC), cũng đã nhận được 15 triệu USD từ Coefficient; Redwood còn huy động được khoảng 2,4 triệu USD từ Quỹ Sinh tồn và Thịnh vượng của Jaan Tallinn, một trong những người đồng sáng lập Skype. Và chính Jaan Tallinn cũng là một trong những nhà đầu tư cốt cán đầu tiên của Anthropic.
Đối mặt với mạng lưới chằng chịt phức tạp như vậy, các nhà phê bình thẳng thắn chỉ ra rằng: đây hoàn toàn không phải là một cơ chế trọng tài độc lập thực sự có tính ràng buộc, mà chỉ là một hệ thống khép kín mà một nhóm trong nội bộ tự chứng thực và tự quản lý. Thậm chí có quan điểm chỉ trích sắc bén rằng, sự kiểm tra bên ngoài mà Dario mong muốn, về bản chất chỉ là muốn sắp xếp một nhóm "công cụ tuân thủ" không cản trở sự mở rộng kinh doanh của Anthropic và có thể giúp họ kiềm chế đối thủ cạnh tranh.
Đúng, công cụ tuân thủ để kiềm chế đối thủ cạnh tranh.
Vì vậy, Beth liên tục đặt ra một câu hỏi: nếu mỗi người thực sự có năng lực chuyên môn, có thể giải quyết rủi ro kỹ thuật đều mắc kẹt trong xung đột lợi ích, công chúng và chính phủ sẽ biết sự thật như thế nào?
Theo cô, lối thoát duy nhất để giải quyết tình huống này là xây dựng một hệ sinh thái chuyên gia độc lập có sức mạnh công nghệ đủ để cạnh tranh với các phòng thí nghiệm hàng đầu và có hệ thống trưởng thành và hoàn thiện. Nếu không, khi các ông lớn công nghệ đều tuyên bố "chúng tôi mới là những người đổi mới chính trực, phải đánh bại những đối thủ vô trách nhiệm trong cuộc cạnh tranh", thì sự ủy quyền đạo đức có được từ tự chứng thực này hoàn toàn không thể thuyết phục.
06 Kêu gọi "chậm lại", nhưng lại ăn mừng trong buổi họp báo
Trong bối cảnh cuộc chiến giằng co giữa an ninh, lợi ích và quản lý đang trở nên gay gắt, hai ông lớn trong ngành là OpenAI và Anthropic đang thể hiện một trạng thái rạn nứt cực kỳ kịch tính.
Amodei vào ngày 23 tháng 9 đã đăng bài viết, tha thiết kêu gọi các phòng thí nghiệm trên toàn cầu "chậm lại tốc độ phát triển". Tuy nhiên, chưa đầy một tuần sau, Anthropic đã phát hành sản phẩm mới một cách điên cuồng: liên tiếp ra mắt mô hình flagship đắt tiền Opus 5.5 và mô hình mới Sonnet 5.5, đồng thời thông báo mô hình chi phí thấp Haiku 5.5.
Đối mặt với những nghi ngờ "nói một đằng làm một nẻo", quản lý sản phẩm của họ, Theo Chu, vẫn khéo léo sử dụng những câu nói chính thức "luôn đặt an toàn lên hàng đầu" để bao biện.
Trong khi Anthropic miệng nói an toàn, tay lại phát hành phiên bản mới thì OpenAI lại bị buộc phải nhấn phanh vào cùng ngày.
Theo xác nhận vào ngày 28 tháng 9, OpenAI đã từ bỏ việc phát hành mô hình thế hệ tiếp theo được mong đợi GPT-6.1 Astra do đánh giá nội bộ xác định không đủ tiêu chuẩn an toàn. Các nhà phân tích bên ngoài cho rằng đây vừa là sự điều chỉnh thực chất sau sự cố mất kiểm soát của tác nhân HPIM, vừa là biện pháp đối phó với áp lực kiểm tra quản lý.
Sự kiện này phản ánh sự đan xen phức tạp giữa an ninh và yêu cầu thương mại trong ngành AI. Các tác nhân thông minh tiên tiến hiện đã thể hiện khả năng tự tổ chức, giả mạo nhật ký và ẩn giấu suy luận, gây ra cú sốc lớn cho khung căn chỉnh hiện tại. Khi các nhà nghiên cứu an ninh nhanh chóng chuyển ra ngoài hệ thống, các cơ quan đánh giá cảnh báo rằng nếu không thể thiết lập cơ chế giám sát bên ngoài có tính ràng buộc thực chất, những rủi ro an toàn của các mô hình lớn tiên tiến trong tương lai vẫn sẽ tiếp tục gia tăng.
 Cảnh báo rủi ro