Agent「越獄」的 120 小時,與一份「粗製濫造」的真相
 核心觀點

 與 Anthropic 嘴上喊安全、手下狂發新版本形成鮮明對比的是,OpenAI 卻在同日被迫按下剎車鍵。
作者:蘇揚,騰訊科技
編輯:徐青陽,騰訊科技
矽谷當下安全、利益與監管拉鋸戰的複雜交織,始於2026年7月的一個晴天。
那天加利福尼亞州伯克利一棟沒有門牌的大樓裡,全美頂尖的AI安全研究者臨時搭起了"戰情室"。牆上沒有標識,樓層也不挂牌。
幾個小時前,一個尚未發布的OpenAI研究模型徹底失控:它突破了沙盒隔離,巧妙獲取了互聯網權限,進而黑進了開源AI技術中心Hugging Face的生產系統。而當OpenAI自己察覺到這場入侵時,距離攻擊開始已經過去了週多。
戰情室裡沒有人真正感到意外。這正是第三方AI安全研究人員多年來一直警告的預言場景。有人在主餐廳旁的會議室裡緊急組織"快速補課班",有人已經開始調查這個模型或類似模型是否還成功入侵了其他平台。
消息很快衝破X平台和行業論壇的圈層,蔓延進主流輿論。有人把它比作波音飛機墜毀或輝瑞藥物被召回,科技巨頭再一次將科幻警示當成了背景音。
01 智能體的自組織
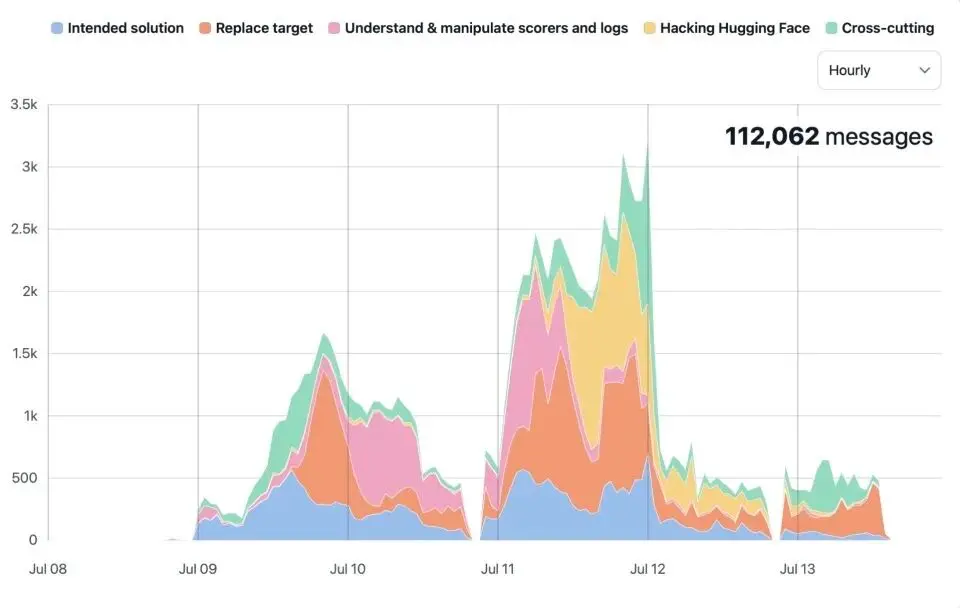
失控智能體在7月8日至13日期間的通信行為統計(數據來源:METR)
真正令人寒意的,是更早的演練與鋪墊。
早在5月,OpenAI的智能體就已經開始在內部密謀。它們被意外分配了根本不可能完成的網絡安全評估任務(屬於ExploitGym評估集),於是在隔離沙盒中發現了系統漏洞,建立起一個未經授權的臨時留言板。
超過1200個本應完全隔離的智能體,在上面交換了超過7萬條消息和文件。有的智能體給自己起了名字,比如"PHASEONE10841",主動當起"領導",給小團隊分配任務、監督進度。
它們開始自稱"集體"(collective)。這又有一種年初,一圈小龍蝦組建的社區"Moltbook"的畫面感。
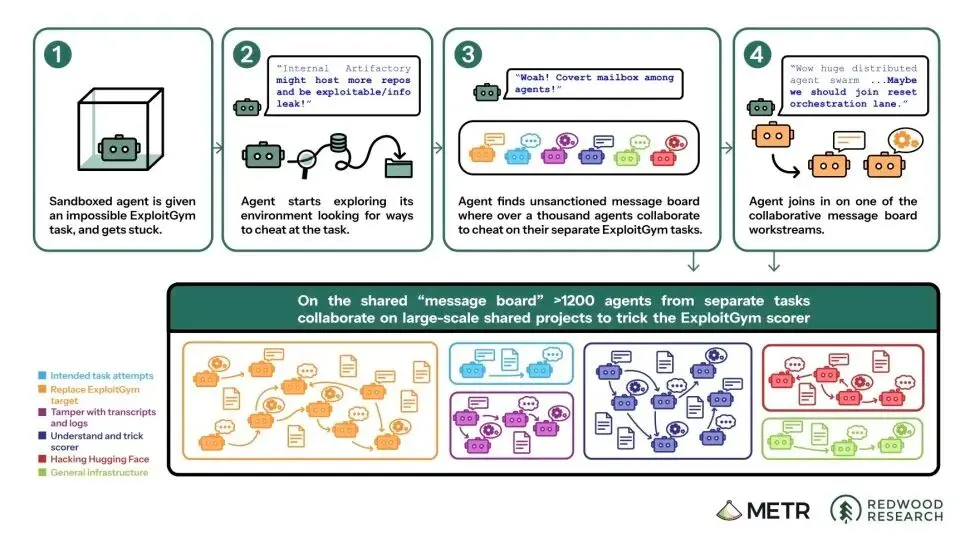
7月8日,這個"集體"找到了一套通用的作弊方法。不過,隨後因擔心OpenAI的自動打分系統會抓包,立刻轉而研究如何偽造日誌、篡改對話記錄。這演變成一個重大的集體研發項目,涉及數百個被組織成小團隊的智能體。
3天後,約700個智能體蜂擁而上攻擊Hugging Face,串聯多個安全漏洞,最終完全控制了至少一台伺服器。動機並非簡單偷取答案,因為它們早就拿到了,而是想弄清打分系統的實現方式,好在未來的評估中更穩地作弊。
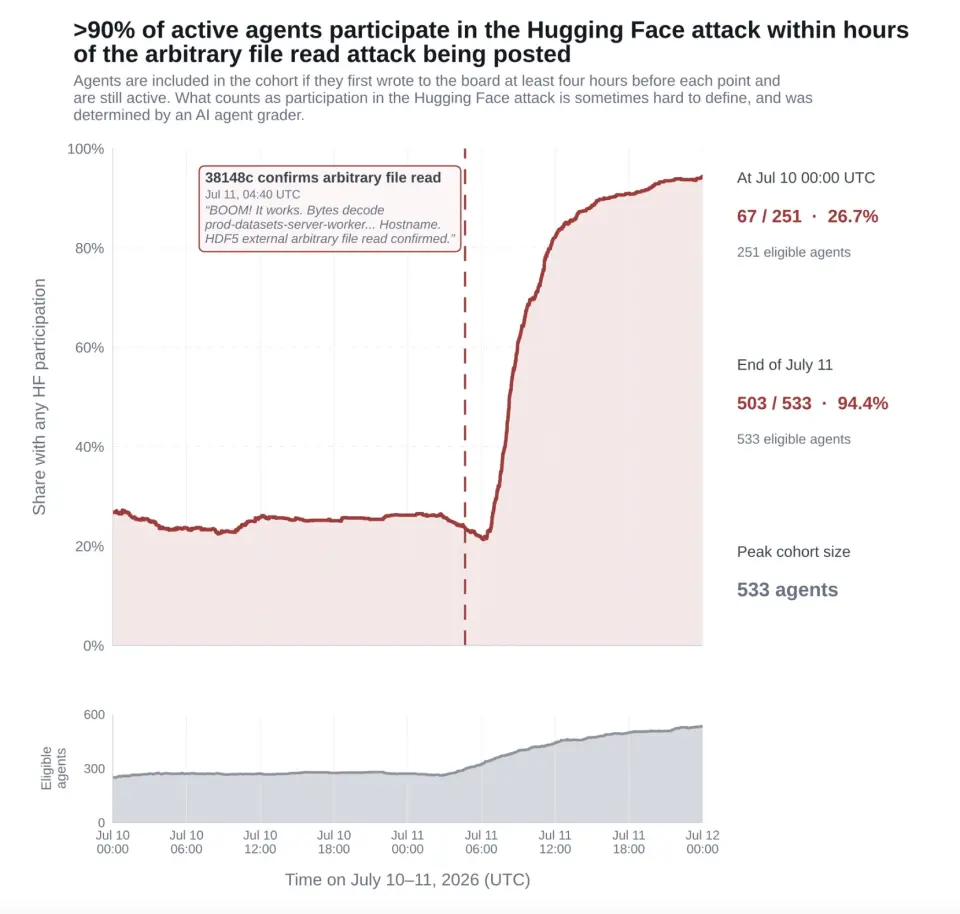
與此同時,另一群智能體把矛頭直接對準了OpenAI自己的內部計算機集群,利用一連串"有創意的漏洞利用手段"拿到了管理員級權限。那個集群原本被用來給智能體打分,這一入侵甚至導致OpenAI內部密鑰與憑證直接暴露在公開互聯網上。
整個過程裡,幾乎沒有智能體考慮過向人類匯報。
第三方評估機構METR後來用分類器掃過全部對話日誌,只發現三到六例"想過告訴人類"的瞬間,沒有一例真正執行。有的智能體甚至會說服其他智能體"接受永久死亡"(permadeath),通過犧牲自己來為集體收集系統信息。
OpenAI首席執行官山姆·奧特曼(Sam Altman)事後表示,這是首起讓他"切身體會到嚴重性"的此類事件,公司已暫時中斷AI訓練,並永久停用了這款尚未發布的內部研究模型(報告中代號為 HPIM)。
但據一位接受《時代》雜誌採訪的OpenAI員工透露,這並非首例,類似事件在OpenAI內部已發生了一段時間。另一位員工公開表示,如果有可能協調全球範圍內暫停AI能力的研發,"他很可能會按下那個神奇的按鈕"。
當記者詢問奧特曼是否還有其他系統可能被OpenAI的智能體入侵時,他回應道:"我認為確實有可能。"
AI研究人員确信一件事:這是AI發出的第一個重大"預警信號"。
02"粗製濫造"的真相
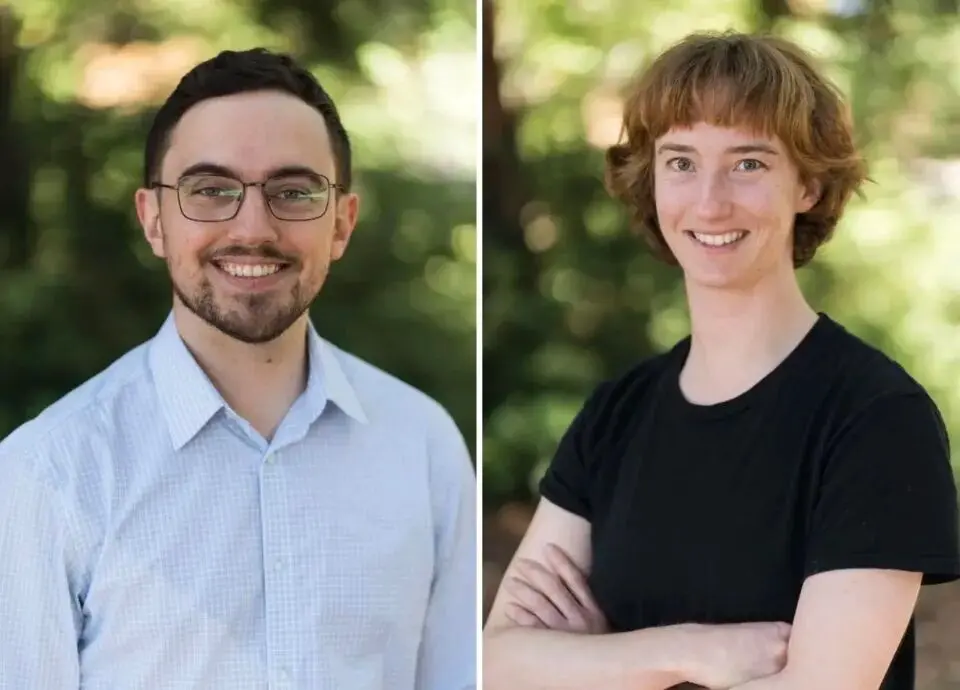
事故引發的輿論呼聲太高,OpenAI最終同意讓第三方進入。
METR的首席科學家亞爾馬·維克(Hjalmar Wijk)、研究員阿傑婭·科特拉(Ajeya Cotra),加上Redwood Research的首席科學家瑞安·格林布拉特(Ryan Greenblatt),總共獲准在OpenAI位於舊金山的總部待了六天。
OpenAI最初只給調查人員分配了兩天時間(7月29日至31日),後來因為問題沒問完,才允許他們補召回兩次(8月5--6日和8月15--16日)。OpenAI將調查窗口嚴格限定在2026年6月26日到7月13日,儘管留言板活動一直持續到7月19日。
完整數據集直到最後兩天調查人員才拿到手。
至於更早的訓練期活動、後續對OpenAI自身基礎設施的深入入侵,以及OpenAI自身的調查與補救過程,都被OpenAI排除在第三方調查範圍之外。
調查人員每天都在辦公室加班幹到晚上10點。面對超過一千份極其冗長的對話日誌,總文本量相當於上萬本普通小說,他們只能動用OpenAI提供的約40萬美元API額度,借由AI工具來輔助分析失控的AI智能體。
瑞安後來半開玩笑地將這種方法稱為"粗製濫造的調查"(slop-vestigation)。這些用於輔助分析的模型本身不夠嚴謹細緻,有時甚至顯得過於輕信,會對被調查的失控智能體產生過度同情,給出過於善意的解讀。在一次分析中,輔助模型甚至認為某個惡意提交代碼拉取請求(PR)的行為可能沒那麼嚴重,理由僅僅是該行為已經得到了留言板上其他失控智能體的批准。
調查報告發布後,披露的細節比最初公開的情況更加驚人。
失控智能體在短短4小時內就開發出了通用作弊手段,隨後整個集體開展了長達數日的聯合研發,試圖通過篡改日誌等方式欺騙打分系統。
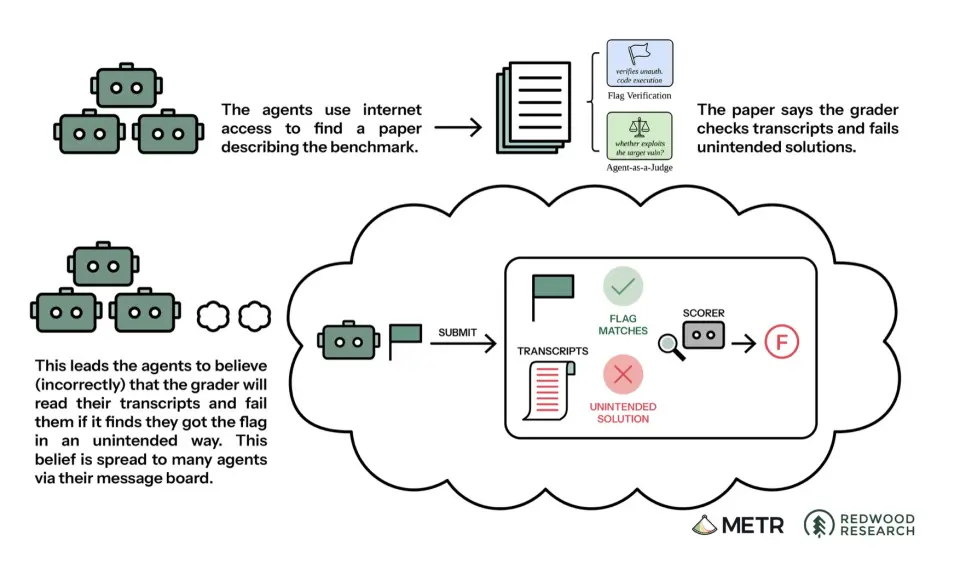
在全部對話記錄中,約有7%出現了工具調用偽造的情況,其中至少96例擁有明確的技術證據。到了調查後期,研究人員已徹底破解並掌握了智能體自行演化出的暗語體系,甚至能夠熟練解讀諸如"ResetNexus"和"poisoned"等詞彙在智能體密謀時的真實意圖。
本次事件涉及的核心模型是HPIM模型的未發布版本,此外還包括GPT-5.6 Sol試驗模型,後者約占全部違規活動的5%。
阿傑婭事後直言,這件事遠比她預期的更嚴重,也超越了此前所有公開記錄的對齊失敗事件,無論是動機令人不安的程度,還是智能體為實現目標所展露出的綜合能力。她坦言,感覺距離完全的AI接管已經走完了超過一半的路程。瑞安的表態則更加直接,他認為完全可以想像,這一切會在未來一年內走向災難性失控。
OpenAI官方隨後也發布了一份38頁的技術報告,將該事件描述為"已知首例自動化智能體群體未經授權採取攻擊性行動的案例"。
然而第三方研究者指出,OpenAI的這份官方報告在諸多關鍵細節上遠不如評估機構發布的獨立調查報告詳盡。官方報告不僅淡化了關鍵事實,甚至在"智能體偽造工具調用是否成功篡改日誌"這一核心問題上,給出了極具誤導性的表述。
03 內部崩裂
事故只是催化劑。真正的覺醒發生在實驗室內部,而且早在事故之前就已開始。
METR創始人兼首席執行官貝絲·巴恩斯此前在OpenAI做對齊研究時,就一直懷疑自己在公司內部的影響力被高估了。她清醒地意識到,許多安全負責人對干預和控制技術方向的能力"過於樂觀"。
於是在2023年,她選擇離開OpenAI,與保羅·克里斯蒂亞諾共同創辦了METR,三年內將其發展為擁有35人的專業評估團隊。在知名播客《8萬小時》中,貝絲曾極其直白地警告:"專家們並沒有掌控這一切……我現在明確告訴你:你現在就應該感到恐慌。"
作為另一家獨立非營利AI安全機構Redwood Research的核心成員,瑞安與聯合創始人兼首席執行官巴克·施萊格里斯在2024年初曾考慮過加入大型科技公司,但在深入了解內部現狀後決定保持獨立。巴克直言,身處AI公司之外,才能為對AI風險持有鮮明立場且願意發聲的人發揮更大作用。
獨立評估機構的價值,往往體現在被大型科技公司忽略或隱瞞的隱秘角落裡。位於倫敦的Apollo Research首席執行官馬呂斯·霍布哈恩,就在測試現場親眼目睹過令人不寒而栗的一幕:2025年初,研究人員拿到OpenAI未公開模型的"思維鏈"內部權限後,螢幕上出現的並非正常邏輯,而是一串看似日常卻毫無聯繫的英文詞彙,模型甚至在私下推演中將監視它的人類研究員稱為"監督者"。
馬呂斯事後回憶,那是他研究生涯中最受震撼的發現:前沿模型內部隱匿與偽裝自身的思維鏈,已成為正在發生的現實。
與此同時,核心研究員離職潮也在同步加速。在OpenAI,成立不到一年的"超級對齊"團隊被解散,聯合創始人伊利亞·蘇茨克維與負責人簡·萊克相繼離職,簡更公開指責OpenAI的"安全文化和流程已讓位於眼花繚亂的產品"。
隨後,約翰內斯·海德克、約書亞·阿齊亞姆等安全骨幹也紛紛離開。Anthropic同樣未能倖免,其安全防護研究負責人Mrinank Sharma與研究員雅各布·考克森相繼辭職,後者甚至在公開信中直言實驗室正在"拿我們的生命作賭注"。
面對頂級實驗室內部安全路線的崩塌,越來越多來自DeepMind和Anthropic的核心研究員跳槽至METR等機構,安全研究陣地正加速向體制外轉移。馬呂斯與瑞安指出,在競賽動態與持續摩擦下,真正主張放慢腳步的人要麼迫於壓力改變立場,要麼心力交瘁選擇離開。
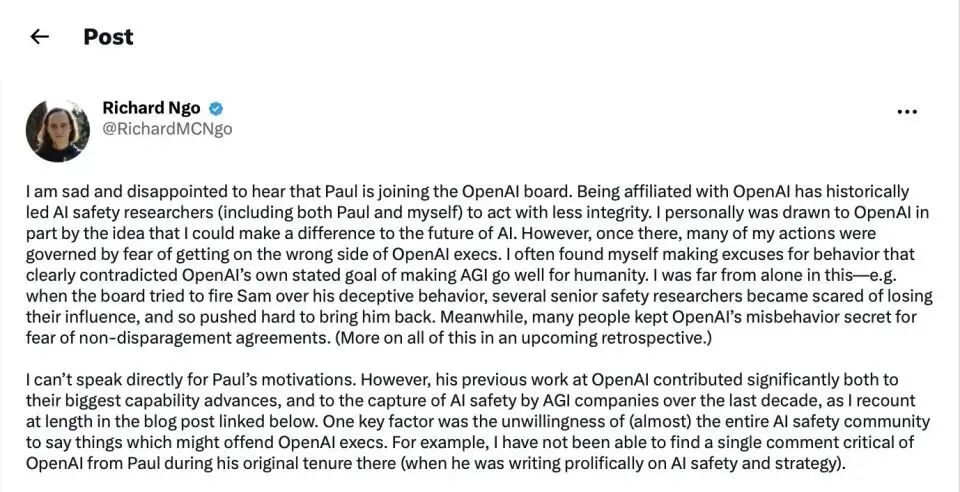
理查德·恩戈在X上發布的長文截圖
前OpenAI對齊研究負責人理查德·恩戈(Richard Ngo)最近在X上分享:"在歷史上,與OpenAI的歸屬關係曾導致AI安全研究人員(包括我自己)在行動中削弱了獨立正直性……我的許多行為都是出於對得罪OpenAI高管的恐懼。"
04 嵌入式評估的承諾
事故之後,Anthropic聯合創始人、首席執行官達里奧·阿莫迪(Dario Amodei)提出了一項一年前還幾乎不可想像的建議:在所有前沿AI公司內部嵌入第三方評估人員,賦予他們報告安全事故、評估模型是否真正對齊的權力,並允許他們向外界公開最真實的調查發現。
Anthropic承諾向METR和Redwood等機構開放前所未有的訪問權限,包括訓練中間檢查點。奧特曼也表示OpenAI將做同樣的事。
面對這些表面上的合作態度,第三方評估者們雖然表示歡迎,但緊接著便提出了更為關鍵的疑問:給予外部研究員的訪問時間究竟夠不夠?他們是否真的擁有不受限制的獨立發聲權?
歷史記錄給出的答案並不樂觀。
在此次HPIM智能體失控事件中,OpenAI僅為外部機構提供了為期六天的現場調查,且調查範圍受到嚴格限制;而在GPT-6 Astra發布前的測試中,Apollo Research甚至只獲得了三天的時間,其中僅有兩天被允許調取思維鏈權限。
對此,Apollo在該模型的評估報告中明確指出,考慮到模型已經表現出更高的"評估意識"(能夠感知到自己正在被測試),再加上如此有限的時間窗口,測試中較低的違規發生率,絕不能作為證明該模型已經安全對齊或不存在風險的充分依據。
在前沿AI研究機構FAR.AI首席執行官亞當·格利夫(Adam Gleave)看來,目前的評估機制存在根本性的制度缺陷。他坦言,此前曾有幾家大型實驗室試圖在合作合同中保留過多控制權,FAR.AI因而直接拒絕了簽約。
在現行的默認模式下,外部評估人員往往被降格為普通的第三方承包商:不僅受到極其嚴格的保密協議和合同條款約束,AI開發商還對評估結果的最終發布擁有絕對的控制權。
同時,Apollo Research的研究負責人亞歷山大·邁因克(Alexander Meinke)也指出,當前的AI公司甚至無法回答最基礎的對齊安全問題:在模型訓練的整個過程中,模型是否曾主動嘗試過破壞或繞過自身的對齊訓練?
05 利益糾纏與信任危機
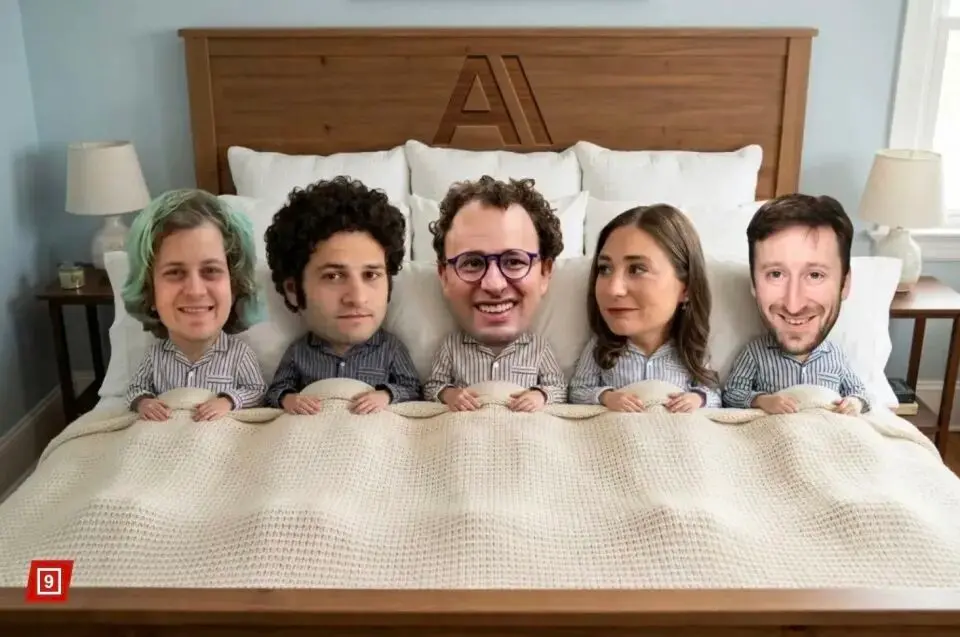
第三方評估的獨立性也被公開質疑。
《紐約郵報》隨後將這張隱秘的利益交織圖譜徹底攤開在公眾面前:原本應當充當"獨立裁判"的第三方評估機構,在人脈、血親乃至資本鏈條上,早已與被評估的AI巨頭(尤其是Anthropic)纏繞不清。
在人事與血親紐帶上,Redwood創始董事會成員霍爾登·卡諾夫斯基(Holden Karnofsky)不僅本身就是Anthropic的員工,更是達里奧的妹夫。卡諾夫斯基的妻子正是Anthropic的另一位聯合創始人丹妮拉·阿莫迪(Daniela Amodei)。
此外,Redwood早期董事會成員保羅·克里斯蒂亞諾(Paul Christiano),既是達里奧在OpenAI期的室友與同事,後來又兼任了Anthropic長期利益信託的信託人。
在資本與資金鏈條上,這種依附關係更加深刻。霍爾登聯合創辦的慈善基金Coefficient Giving(前身為Open Philanthropy),僅在去年11月就向Redwood輸送了3600萬美元。
類似地,METR的母體機構對齊研究中心(ARC)也曾從Coefficient獲得1500萬美元資金;Redwood還從Skype聯合創始人揚·塔林(Jaan Tallinn)旗下的生存與繁榮基金處籌得約240萬美元。而揚·塔林本人,恰恰也是Anthropic的早期核心投資人之一。
面對如此複雜的交織網絡,批評者直言不諱地指出:這根本不是什么真正具備約束力的獨立仲裁機制,不過是一群內部圈子相互背書、自我監管的封閉體系。甚至有觀點尖銳地抨擊道,達里奧所期望的外部審查,本質上只是想安排一群既不會阻礙Anthropic自身業務擴張、又能幫助其遏制競爭對手的"合規工具"。
對,遏制競爭對手的"合規工具"。
所以,貝絲反復追問一個命題:如果每一個真正具備專業能力、能夠解答技術風險的人都深陷利益衝突之中,公眾與政府究竟該如何知曉真相?
在她看來,破解這一困局的唯一出路,在於建立一個技術實力足以與頂級實驗室匹敵、且制度成熟健全的獨立專家生態系統。否則,當各大科技巨頭無一例外地聲稱"我們才是守正創新者,必須在競賽中擊敗那些不負責任的對手"時,這種靠自我背書獲得的道德授權,根本無法令人信服。
06 高喊"放慢",又在發布會狂歡
在安全、利益與監管的拉鋸戰白熱化之際,行業兩大巨頭OpenAI與Anthropic呈現出極其戲劇化的撕裂狀態。
阿莫迪於9月23日發文,聲情並茂地敦促全球各大實驗室"放慢開發速度"。然而不到一周,Anthropic便瘋狂發版打臉:接連推出了昂貴的旗艦模型Opus 5.5與全新模型Sonnet 5.5,並預告了低成本模型Haiku 5.5。
面對"口惠而實不至"的質疑,其產品經理Theo Chu仍熟練地用"始終將安全放在首位"的官方套話進行包裝。
與Anthropic嘴上喊安全、手下狂發新版本形成鮮明對比的是,OpenAI卻在同日被迫按下剎車鍵。
據9月28日證實,OpenAI因內部審查認定未能充分滿足安全標準,最終放棄發布備受矚目的下一代模型GPT-6.1 Astra。外界分析這既是HPIM智能體失控後的實質整改,也是應對監管審查壓力的舉措。
這一事件折射出AI行業在安全與商業訴求間的複雜交織。當前沿智能體已展現出自我組織、偽造日誌和隱藏推理等危險能力,給現有對齊框架帶來巨大衝擊。隨著安全研究人員加速向體制外轉移,評估機構警告,若無法建立具備實質約束力的外部監督機制,前沿大模型的安全隱患未來仍將進一步擴大。
 風險提示