








Только что DeepSeek представила концепцию следующего поколения agent harness
 Ключевые тезисы


 Данная статья является обсуждением архитектурных подходов, ориентированных на инженерную практику, и не является представлением существующих функциональных возможностей продукта DeepSeek Harness.
Исходный заголовок: Исследование дизайна Super-agent: Путь к более автономным системам Agent
Исходный автор: Продуктовый отдел DeepSeek
1. Super-agent
За последний год однозадачные агенты, представленные Coding Agent, доказали, что модели могут использовать инструменты для решения сложных задач, и все реже требуют постоянного мониторинга и вмешательства человека. В то же время, способность моделей к многопользовательскому взаимодействию также растет, что делает возможной организацию и планирование между сессиями. С уменьшением участия человека в базовом исполнении, его роль постепенно смещается на более высокий уровень принятия решений и проверки.
Это повышение возможностей модели также породило новые формы применения. В последнее время начали активно появляться персональные помощники (Personal Agent), которые напрямую подключаются к повседневным сообщениям, расписаниям, электронной почте и рабочим платформам, постоянно наблюдая за потоком информации и помогая в обработке дел. Эта модель работы, основанная на постоянном онлайн-присутствии и управлении событиями, не ограничивается личными сценариями; персональные помощники — лишь один из типов приложений; в коммерческих сценариях, таких как разработка программного обеспечения, она также имеет большую ценность.
Тем не менее, существующий основной дизайн агентов все еще не может поддерживать эту модель на уровне многозадачности и командного взаимодействия. Рабочая модель агента по-прежнему основывается на единой сессии как базовой единице, и разные сессии независимы друг от друга. Когда пользователь параллельно продвигает несколько задач, ему необходимо вручную переключаться и запоминать контекст каждой сессии, и, как мы наблюдали, человек обычно может одновременно отслеживать только 3-5 активных сессий. В таком дизайне предел однозадачности зависит от возможностей модели, а предел многозадачности — от внимания человека.
Если просто расширить существующий локальный односессионный агент с помощью CLI, MCP или внешних соединителей, хотя агент и сможет подключаться к внешним сообщениям, он все равно будет ограничен проблемами синхронной блокировки одной сессии, путаницы контекста многозадачности и остановкой работы при отключении локального устройства, что требует значительного ручного обслуживания.
Чтобы преодолеть эти ограничения, необходимо разорвать связь агента с однократной ручной сессией, сделав его непрерывным объектом, который может сохранять контекст между сессиями, одновременно продвигая несколько сложных задач без взаимных помех. Мы называем эту форму агента и его архитектуру Super-agent.
Например, в нашем внутреннем экземпляре Super-agent, работающем на DeepSeek Harness, одна и та же задача разработки может последовательно продвигаться между IM и GitHub; этот экземпляр также будет постоянно наблюдать за обратной связью в публичном чате, активно выявляя коренные причины и отправляя исправляющий Pull Request без упоминания:
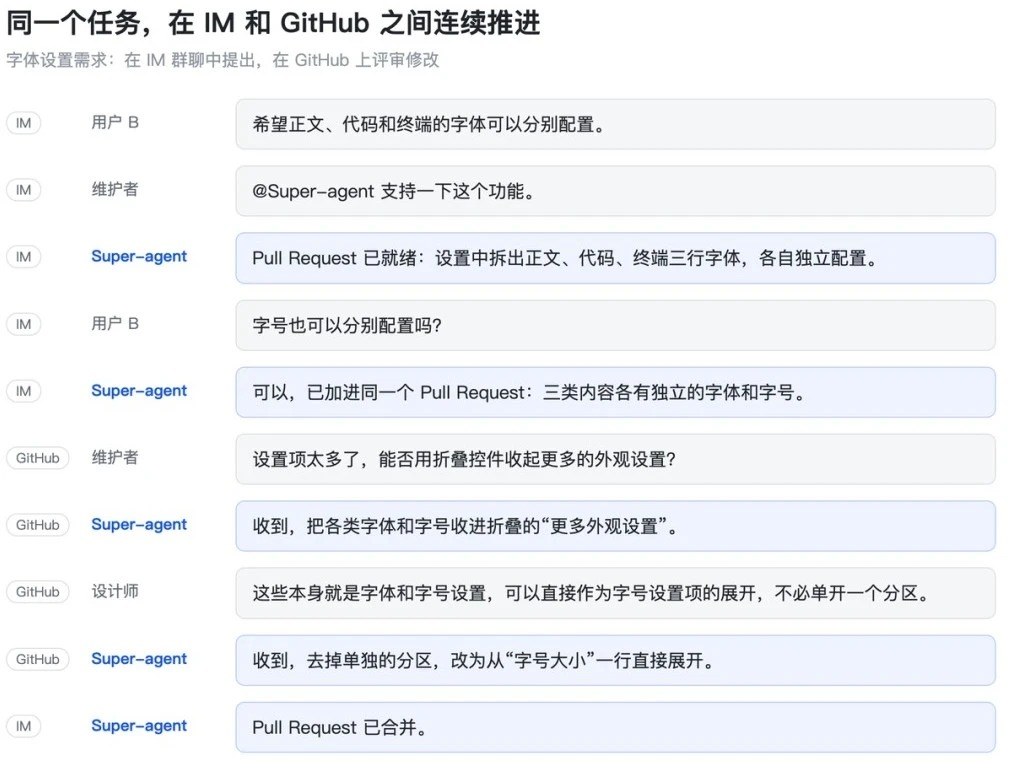
Одна и та же задача последовательно продвигается между IM-чатом и рецензией Pull Request на GitHub
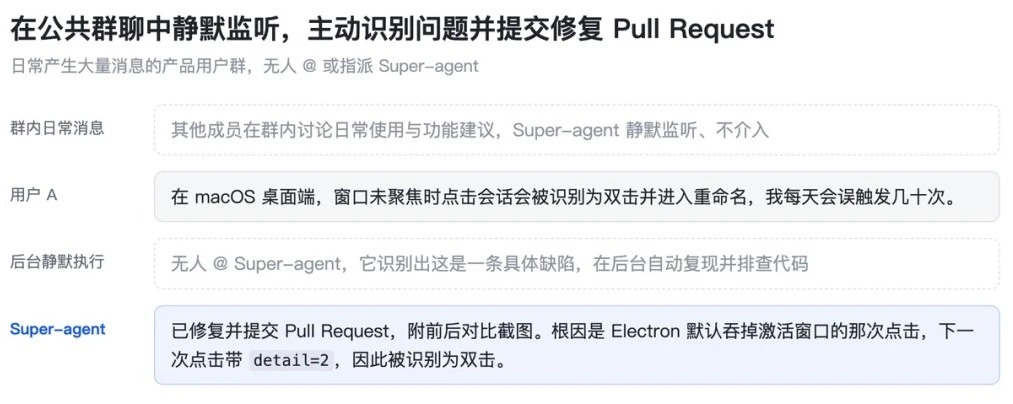
Постоянно следит за публичным чатом, активно выявляет дефекты и отправляет исправляющий Pull Request без упоминания
Конкретно, мы считаем, что Super-agent обладает следующими четырьмя основными характеристиками:
Непрерывность: Пользователь может взаимодействовать с ним напрямую в IM-чате, комментариях на GitHub и других знакомых рабочих интерфейсах, ощущая, что существует только один агент, не задумываясь о том, «есть ли информация Y в контексте сессии X». Например, если пользователь сначала предлагает использовать вариант A в IM, а затем меняет его на вариант B в комментарии Pull Request на GitHub, он может понять и скорректировать направление выполнения.
Эффективность: Ответы на взаимодействия быстрые, и одновременно могут выполняться несколько сложных задач с высоким качеством. Не нужно ждать завершения предыдущей команды или задачи, чтобы принять следующую инструкцию.
Активность: Не дожидаясь, пока пользователь выдаст команды по одной, он может постоянно наблюдать за событиями в окружении и активно продвигать важные дела, оставаясь тихим, когда вмешательство не требуется.
Долговечность: Всегда онлайн, напрямую подключен к реальной рабочей среде пользователя и автоматически восстанавливается при возникновении исключений в процессе длительной работы.
Один ReAct Loop не может одновременно поддерживать все четыре характеристики; на базовом уровне требуется соответствующая архитектура. Похожие ограничения дизайна приведут к схожим архитектурным решениям. Мы считаем, что независимо от того, предназначен ли агент для личного использования или для коммерческих сценариев, таких как разработка программного обеспечения, если цель состоит в том, чтобы создать систему, которая постоянно онлайн и реагирует на события окружения, то на базовом уровне может быть использована схожая архитектура. Кроме того, многие проблемы, с которыми сталкивается этот процесс, имеют высокую степень сходства с проблемами, которые долго обсуждались в традиционных компьютерных системах, поэтому многие классические идеи дизайна из компьютерных систем также применимы здесь.
В конкретной реализации эта архитектура будет иметь разные варианты, но мы считаем, что следующие пять модулей составляют основную структуру, поддерживающую вышеупомянутые четыре основные характеристики: через двухуровневую архитектуру (раздел 2) обеспечивается непрерывное взаимодействие и эффективная параллельность, через управление событиями (раздел 3) достигается активный отклик, через взаимодействие, ориентированное на человека (раздел 4), одновременно достигается непрерывность и эффективность, а через разделение вычислений, состояния и окружения (раздел 5) и Watchdog (раздел 6) обеспечивается кросс-устройство постоянного онлайн-присутствия и самовосстановления.
Ниже показана общая системная архитектура Super-agent, номера модулей [2] до [6] соответствуют разделам 2 до 6:
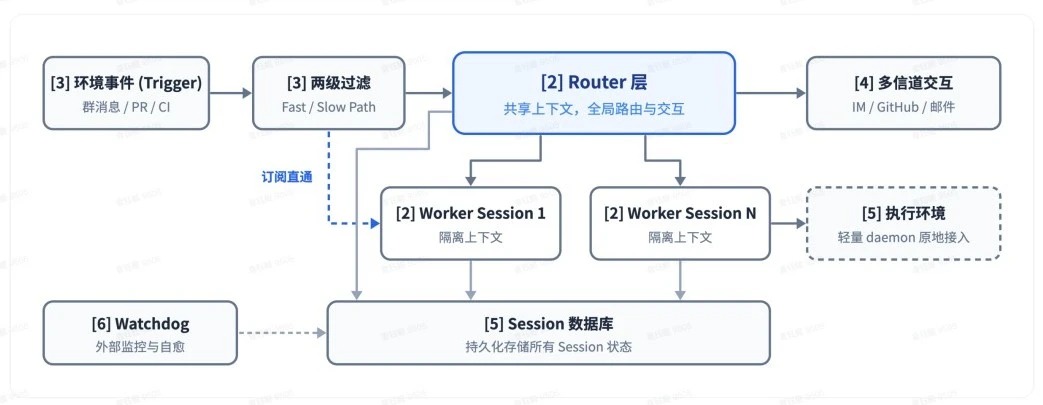
Общая системная архитектура Super-agent, номера [2] до [6] соответствуют разделам 2 до 6
2. Двухуровневая архитектура
Чтобы одновременно реализовать непрерывное взаимодействие между каналами и эффективную параллельность многозадачности, система на базовом уровне сталкивается с фундаментальным компромиссом между непрерывностью и пропускной способностью (Trade-off).
Если каждое событие обрабатывается одной и той же сессией, хотя контекст будет наиболее непрерывным, ограничение скорости последовательного выполнения одного ReAct Loop приведет к длительному времени завершения задач и низкой пропускной способности, а детали многозадачности будут смешиваться, что также повлияет на качество выполнения.
С другой стороны, если каждое событие обрабатывается в новой независимой сессии, хотя параллельная пропускная способность будет максимальной, отсутствие глобального контекста сделает результаты каждой сессии разрозненными, а множественные сессии, отвечающие пользователю, также создадут путаницу в взаимодействии.
Чтобы учесть непрерывность и пропускную способность, мы можем разделить «поддержание глобальной непрерывности» и «высокую параллельную производительность» на два разных уровня: постоянный уровень Router (раздел 2.1) будет объединять человеческое взаимодействие и глобальную координацию, а уровень Worker (раздел 2.2) с изолированным контекстом будет параллельно выполнять конкретные задачи, как показано на рисунке ниже:
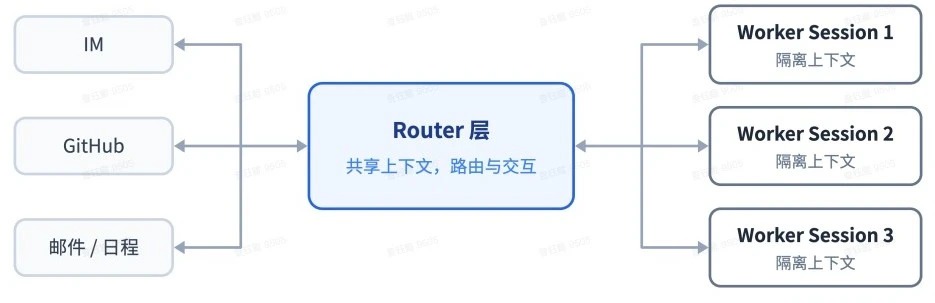
Двухуровневая архитектура: уровень Router отвечает за маршрутизацию и внешнее взаимодействие, несколько сессий Worker изолированно и параллельно выполняют задачи
С помощью этой двухуровневой архитектуры система на базовом уровне берет на себя управление контекстом и параллельное выполнение, тем самым уменьшая видимость сессий для пользователя, который всегда взаимодействует с одним и тем же Super-agent. С этой точки зрения, заставлять пользователя вручную управлять сессиями в значительной степени является наследием дизайна, перенесенным с базового LLM API; сессии должны быть деталями реализации системы, а не когнитивной нагрузкой для пользователя.
В существующем дизайне сессии одновременно несут ответственность за управление контекстом с технической стороны и управление проектом с пользовательской стороны. После декомпозиции продуктовой формы и базовых сессий, управление проектом с пользовательской стороны больше не будет ограничено сессиями, и вопрос о том, как предоставить пользователю взаимодействие и управление задачами, становится независимой продуктовой задачей. Мы обсудим этот вопрос позже.
Здесь «двухуровневая» — это логическое разделение обязанностей, каждая из которых не обязательно ограничивается одной сессией, а может иметь свою внутреннюю структуру. Далее будут представлены дизайны уровня Router и уровня Worker.
2.1 Уровень Router
Уровень Router — это постоянный глобальный уровень маршрутизации, отвечающий за обработку всех входящих человеческих взаимодействий. Вся информация и решения, касающиеся различных задач, собираются на уровне Router, который служит глобальной точкой последовательности (Sequence Point), координации и памяти. Чтобы избежать превращения этой глобальной точки в узкое место производительности системы, уровень Router по дизайну не выполняет конкретные задачи, а отвечает только за человеческое взаимодействие и распределение задач, даже может не иметь Bash-инструментов.
Структура, в которой один центральный узел распределяет несколько исполнительных узлов, на первый взгляд похожа на обычную команду агентов, но акценты у них разные. Обычные команды агентов в основном используются для разбивки сложных задач на шаги и координации ролей; поскольку подзадачи обычно тесно связаны, Team Lead часто должен глубоко понимать детали задачи, планировать подзадачи и часто координировать членов команды, что создает значительную нагрузку на рассуждения. В Super-agent уровень Router обрабатывает только высокоуровневые связи и распределение между задачами, не вмешиваясь в разбиение внутри одной задачи; наоборот, если ограничить основную сессию команды агентов с помощью подсказок, чтобы она не выполняла конкретные задачи, а только отвечала на внешние взаимодействия и распределяла различные задачи для независимого продвижения, то это также можно рассматривать как такую двухуровневую архитектуру. На основе нашего опыта, задачи уровня Router часто не так сложны, как можно было бы ожидать, и использование более легких моделей часто может обеспечить как скорость, так и эффективность.
Внутри реализации уровень Router также не обязательно ограничивается одной сессией, и даже часть логики может не требовать вызова LLM. Мы выбрали наиболее прямую реализацию уровня Router в виде одной постоянной сессии LLM и обнаружили, что она не так легко становится узким местом пропускной способности, поскольку события окружения, поступающие в течение предыдущего цикла вывода (то есть триггеры из раздела 3), будут накапливаться и обрабатываться вместе в следующем цикле, образуя пакетную обработку (Batching), а дополнительные затраты на объединение обработки очень малы:
Когда внешний поток событий стабилен, триггеры поступают по одному в сессию Router, и в этот момент задержка ответа на одно взаимодействие невелика;
Когда события интенсивно поступают и в Router Session начинается очередь, несколько накопленных Trigger из предыдущего цикла вывода автоматически объединяются и инъецируются в следующий вызов LLM. Router Session выполняет легкие взаимодействия и распределение, каждый шаг обычно представляет собой длинный ввод и короткий вывод. Объединение нескольких накопленных Trigger в один вызов LLM API будет параллельно вычисляться на этапе Prefill, увеличение времени одного запроса значительно медленнее, чем размер пакетной обработки. Поэтому в определенных пределах, чем больше накоплено, тем ниже время вывода на одно решение; верхний предел зависит от длины контекста и от того, сколько Trigger модель может точно обработать за один цикл.
Мы количественно продемонстрируем эффективность этой механики пакетной обработки в разделе 7.2. В дополнение к механизмам подписки и прямого доступа, а также цепочечному вызову (см. разделы 3.2 и 3.3), одного постоянного Router Session достаточно для поддержания непрерывности контекста в рамках нашей текущей команды.
Когда масштаб будет увеличен, и одного сеанса будет недостаточно, внутренний уровень Router также может быть спроектирован как многоуровневая фильтрационная структура или горизонтально разделен (Sharding) на несколько сеансов. В этом случае внутренний дизайн уровня Router по сути представляет собой компромисс между непрерывностью и пропускной способностью. Чем мельче гранулярность разделения, тем выше параллельная пропускная способность уровня Router, но память и непрерывность контекста между фрагментами будут ниже. Этот компромисс будет существовать до тех пор, пока не будет решена проблема глобальной памяти.
2.2 Уровень Worker
Уровень Worker состоит из сеансов, ответственных за конкретное выполнение, каждый Worker изолирован по контексту, имеет полный набор инструментов для выполнения и сосредоточен на выполнении одной задачи в независимом контексте. Поскольку Worker Session напрямую определяет результаты задач и качество кода, обычно требуется настраивать наиболее мощные модели.
Worker не взаимодействует напрямую с человеком, его процесс вывода и вызовы инструментов не выводятся напрямую во внешние каналы, а вместо этого сообщают о состоянии уровню Router, который централизованно отвечает пользователю, тем самым обеспечивая одновременно высокую степень параллелизма и качество доставки, избегая путаницы, возникающей из-за ответов нескольких сеансов.
При многозадачном параллельном выполнении каждый Worker независимо продвигает задачи, и обычно между Worker одного уровня не требуется прямое общение. Конфликты между несколькими Worker часто возникают в одном Pull Request или другом общем рабочем окружении; если они подписаны на соответствующий Thread, они получат одинаковые уведомления о событиях (см. раздел 3.2), что дает им возможность самостоятельно обнаруживать и решать конфликты, а небольшое количество межзадачного взаимодействия обрабатывается уровнем Router.
Как и в случае с уровнем Router, каждый Worker Session также не обязательно ограничивается одним сеансом: при выполнении сложной одноразовой задачи внутри Worker можно создать Subagent или сам по себе быть Agent Team, что остается прозрачным для верхнего уровня Router. Эта структура подходит как для сценариев совместной работы с кодом (одновременное продвижение нескольких независимых вопросов, рецензий Pull Request и разработки функций без блокировки), так и для сценариев личного помощника: хотя личный помощник обычно предоставляет только одну страницу чата для одного сеанса, когда пользователь одновременно обсуждает несколько различных тем в одном окне чата, фронтенд отвечает за поддержание непрерывности взаимодействия, в то время как нижний уровень может назначать Worker для каждой темы, параллельно продвигая задачи и подготавливая ответы.
3. Событийное управление
Чтобы Super-agent обладал проактивностью, необходимо изменить способ управления системой. Основным входом для управления Agent больше не являются подсказки, вводимые человеком в сеансе, а полуструктурированные события из окружающей среды. В Super-agent групповые сообщения, электронные письма и напоминания о расписании, комментарии к коду, результаты CI и другие события окружающей среды называются Trigger. Слушая и реагируя на Trigger, Agent больше не должен, как в режиме одного сеанса, ждать, пока человек даст команду, чтобы выполнить действие.
Вокруг жизненного цикла события из окружающей среды от его поступления до обработки мы последовательно обсудим четыре прогрессивных вопроса: как с помощью двухуровневой стратегии фильтрации программ и моделей отсеивать большое количество шума (раздел 3.1), как с помощью механизмов подписки и прямого доступа маршрутизировать события к Worker (раздел 3.2), как использовать Inline & Spill и цепочечный вызов для высокой плотности инъекции и по запросу вызова контекста в модель (раздел 3.3), а также как использовать спекулятивное выполнение для предварительных действий на основе сигналов окружающей среды (раздел 3.4).
3.1 Фильтрация событий
После подключения к реальным группам чата и платформам кода поток событий окружающей среды демонстрирует заметные характеристики «высокий шум, низкая частота срабатывания», большинство повседневных сообщений не требует вмешательства Agent. Если для каждого события вызывать большую модель для оценки, задержка и вычислительные затраты будут непосильными. Заимствуя идею Fast Path / Slow Path из компьютерных систем, вывод большой модели можно рассматривать как гибкий, но высокозатратный Slow Path, в то время как уже определенные и стабильные высокочастотные оценки, закрепленные в детерминированном коде, составляют низкозадерживающий, низкозатратный Fast Path.
Таким образом, первый шаг после поступления события в систему — это фильтрация, цель которой — использовать детерминированные стратегии для отсечения шума перед вызовом большой модели, передавая на оценку только те кандидатные события, которые требуют семантического понимания. Мы используем двухуровневую фильтрационную механику, сочетающую программные стратегии и большую модель:
Программный уровень стратегии (как Fast Path): для источников событий, диапазонов групп, белых списков пользователей или роботов и других детерминированных условий, быстрое проверка допуска осуществляется через код, например, для разных источников устанавливаются «только отвечать на явные запросы», «как кандидатные события» или «прямо игнорировать», что позволяет отсеять большую часть несущественных сообщений перед вызовом модели.
Семантический уровень стратегии (как Slow Path): кандидатные события, прошедшие проверку на программном уровне, передаются LLM, которая решает, нужно ли действовать, основываясь на стратегии и контексте, написанных с помощью подсказок. Семантический уровень также служит точкой расширения для естественного языка, позволяя в любое время переключать или добавлять стратегии с помощью подсказок, как показано на следующем изображении:
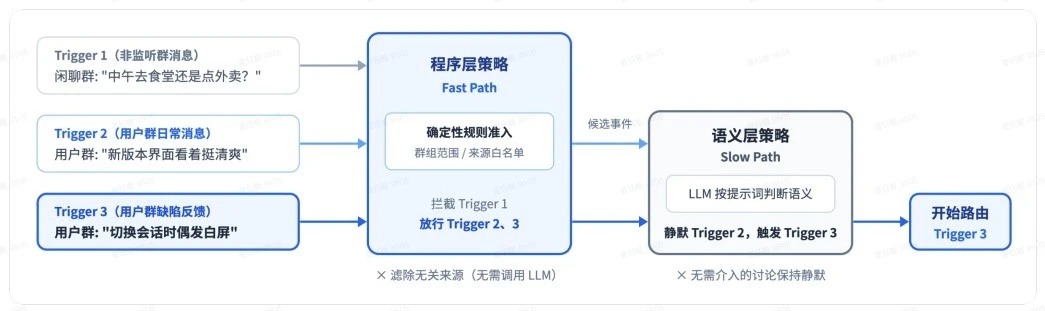
Двухуровневая фильтрация: сначала программный уровень стратегии отсекает большую часть несущественных сообщений, затем семантический уровень стратегии принимает решение.
3.2 Маршрутизация событий
Глобальный уровень Router, введенный в разделе 2, отвечает за поддержание непрерывности между каналами, но если каждое последующее событие, назначенное задаче, все еще должно быть перенаправлено через уровень Router, этот глобальный узел будет подвергаться значительной нагрузке, увеличивая задержку ответа системы. Поэтому Fast / Slow Path также применимы к маршрутизации событий после фильтрации. Глобальный уровень Router отвечает только за холодный старт новых задач и координацию между задачами, в то время как последующие события с установленными отношениями принадлежности отправляются напрямую в соответствующий Worker Session без необходимости перенаправления через уровень Router.
В реальном рабочем процессе последовательные события в одном Pull Request на GitHub, одной теме IM или одной цепочке электронных писем составляют поток событий, то есть Thread:
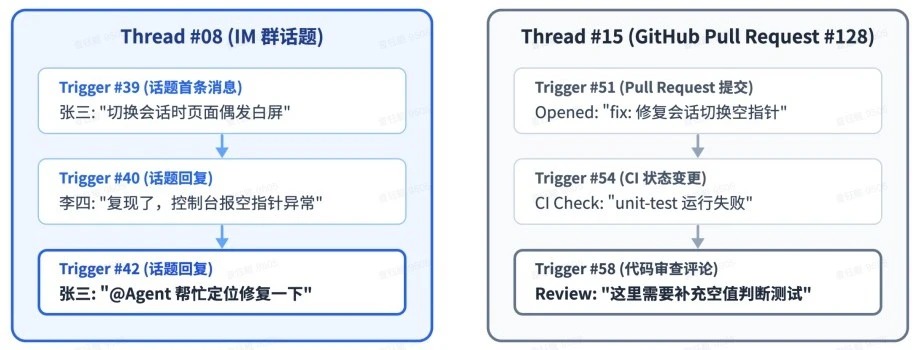
Пример Thread: последовательные Trigger в одной теме IM или одном Pull Request на GitHub составляют один Thread.
После создания Worker Session на уровне Router на основе начального события определенного Thread, этот Worker напрямую подписывается на соответствующий Thread, тем самым маршрутизируя события по двум путям, как показано на следующем изображении:
Подписанные (Fast Path): последующие события в одном Thread передаются программе напрямую подписанному Worker, без необходимости повторного вызова инструментов на уровне Router. Если новое событие выходит за рамки текущей задачи, Worker также может отменить подписку или вернуть ее на уровень Router для повторного распределения.
Не подписанные (Slow Path): уровень Router все еще может наблюдать все события, чтобы контролировать глобальное состояние, но отвечает только за оценку и распределение новых событий, которые еще не были подписаны.
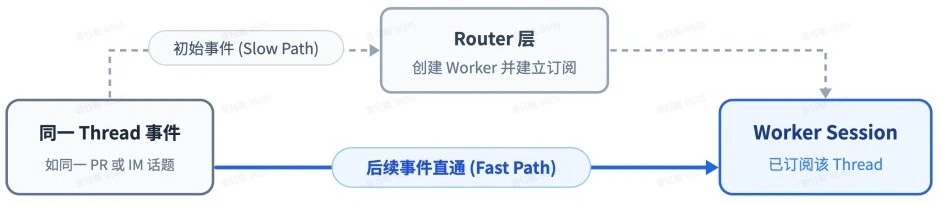
Подписка и прямой доступ: начальное событие создает Worker через уровень Router и устанавливает подписку, последующие события в одном Thread отправляются напрямую этому Worker.
Кроме того, подписка между Thread и Worker имеет отношение многие ко многим. Один Worker может одновременно подписываться на несколько связанных Thread, и один Thread также может быть подписан несколькими Worker. Когда несколько Worker пересекаются в одной рабочей среде или обсуждении, новые события в этом Thread будут одновременно переданы всем подписанным на него Worker, позволяя им избежать точечного общения и иметь возможность узнать о действиях друг друга и самостоятельно решать конфликты. На стороне вывода Worker по-прежнему будет сообщать ключевые выводы уровню Router, который централизованно отвечает пользователю и синхронизирует глобальную память.
3.3 Организация контекста
После фильтрации и маршрутизации событий и их поступления в целевой Session, следующим вопросом является, сколько информации следует инъецировать в контекстное окно модели. Поскольку ввод системы изменился с ограниченных подсказок от человека на полуструктурированные события, постоянно генерируемые окружающей средой, проектирование структуры вызовов инструментов и инъекций событий стало более важным. Слишком много инъекций будет занимать окно, разбавляя внимание модели, в то время как слишком мало инъекций заставит модель многократно вызывать инструменты для чтения, увеличивая количество шагов выполнения. Трата контекстного окна — это трата интеллекта модели.
Для этого мы можем управлять ограниченным контекстным окном как Cache. Заимствуя концепции оптимизации компиляции и компьютерных систем, проектирование инъекций контекста можно свести к двум основным операциям. Inline означает, что информация, которая, вероятно, будет использована в ближайшее время, инъецируется непосредственно в текущее контекстное окно, чтобы избежать дополнительных вызовов инструментов. Spill означает, что полная информация, превышающая бюджет окна или используемая с низкой частотой, остается за пределами контекстного окна, сохраняя только ссылки или резюме внутри окна для модели по запросу.
С учетом классической идеи локальности (Locality) в проектировании компьютерных систем, мы можем постепенно оптимизировать инъекцию событий и вызовы инструментов с помощью Inline & Spill:
Начать с минимальной информации: изначально предоставить только ID текущего объекта и резюме содержания.
Постепенно инъецировать связанные данные, используя локальность: инъецировать информацию, которая, вероятно, будет использована в ближайшее время, в контекст, сначала добавляя ID тесно связанных объектов, затем добавляя пространственно-временные соседние данные, такие как первые 50 символов содержания, соседние сообщения IM и сообщения, на которые отвечают, или соседние комментарии в обсуждении рецензии кода.
Превышение лимита приводит к Spill: для длинного контента, который не может быть полностью встроен, устанавливается меньший лимит длины, и превышающая часть Spill выводится за пределы окна. Простой и прямой подход — это обрезка превышающей части с сохранением точки продолжения чтения, когда модели требуется полный контент, она снова вызывает инструмент для чтения.
Кроме того, когда большое количество последующих событий проходит через Worker, и система накапливает множество исторических задач в процессе длительной работы, уровень Router не может поместить всю историю всех задач в свое контекстное окно, но ему необходимо восстанавливать контекст, когда пользователь поднимает старую задачу через разные каналы. Применив Inline & Spill последовательно ко всем объектам в системе, мы получаем механизм многоуровневого поиска по запросу, известный как цепочка воспоминаний (Chain of Recall). Этот процесс цепочки воспоминаний смягчает проблему потери предыдущей информации на уровне Router в долгосрочной перспективе, как показано на следующем рисунке:
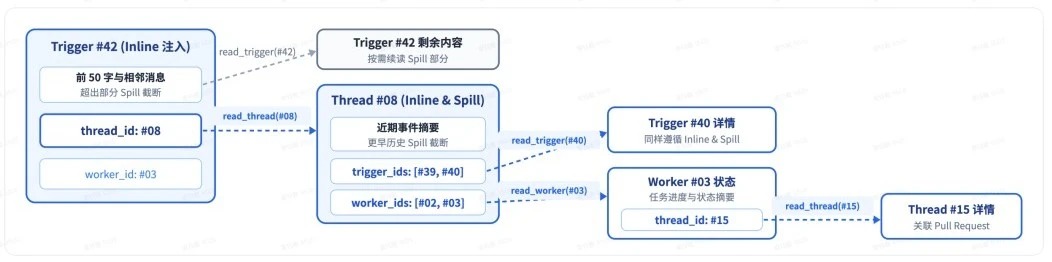
Цепочка воспоминаний: каждый объект, который вызывается, инлайнит ID следующего связанного объекта, поддерживая пошаговое раскрытие контекста вдоль ссылочных отношений.
Конкретно, система присваивает уникальные ID объектам, таким как Trigger, Thread и Worker Session, и инлайнит ID тесно связанных объектов при инъекции, создавая таким образом ссылочную графу на нижнем уровне. Поскольку каждый объект, вызываемый инструментом, также следует принципам Inline & Spill, его возвращаемые результаты будут инлайнить резюме и ID следующего связанного объекта, что позволяет модели, начиная с текущего события, постепенно по запросу восстанавливать контекст вдоль ссылочных отношений.
Например, можно прочитать текущую тему из сообщения, затем отслеживать связанный Worker Session по инлайн ID из темы, а затем найти другой код-ревью Thread, связанный с этим Worker.
3.4 Предварительные действия
Заимствуя идею спекулятивного выполнения (Speculative Execution) из компьютерных систем, Agent может заранее попытаться выполнить задачи в фоновом режиме, основываясь на сигналах окружающей среды, даже не будучи уверенным, будет ли результат принят, тем самым уменьшая время ожидания и вмешательства со стороны человека за счет расхода дополнительной вычислительной мощности в фоновом режиме. Если результат имеет ценность, он передается, если нет — отбрасывается.
В сценарии личного помощника, когда поступает электронное письмо с приглашением на встречу или сообщение о задаче, Agent может сначала проверить конфликты в расписании, собрать соответствующую информацию и подготовить черновик ответа в фоновом режиме, чтобы пользователь мог сразу подтвердить его после просмотра. В сценарии совместной разработки происходит то же самое, например, в нашей внутренней группе пользователей DeepSeek Harness мы настроили стратегию «тихого воспроизведения и исправления»: когда кто-то в группе сообщает о проблеме или обсуждает изменения, Agent сначала пытается воспроизвести проблему и найти решение в фоновом режиме, и только после подтверждения проблемы и нахождения простого решения результат передается пользователю, в противном случае он остается в тишине.
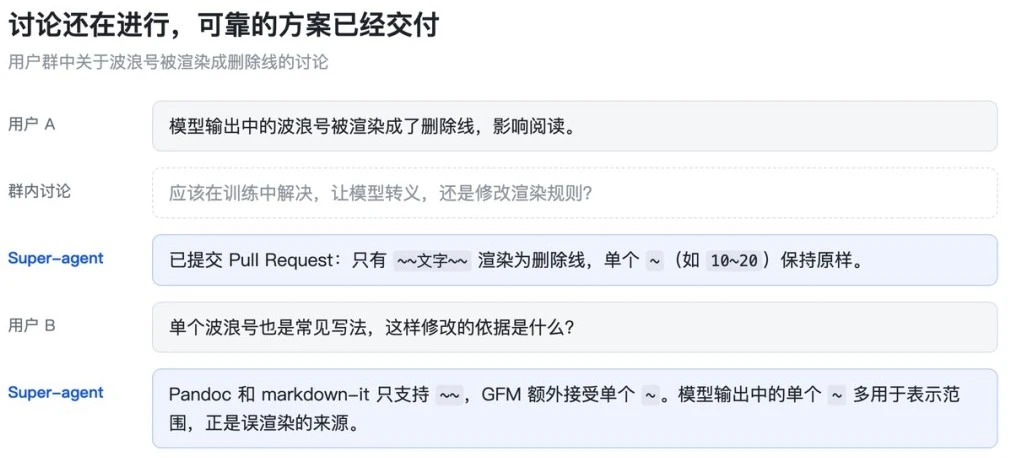
Пример спекулятивного выполнения: пока в группе обсуждаются решения, Super-agent уже отправил Pull Request на исправление в фоновом режиме.
4. Взаимодействие с человеком
Двухуровневая архитектура из раздела 2 обеспечивает непрерывность между каналами, но для достижения как непрерывности, так и эффективности в реальном взаимодействии человека и машины необходимо решить две проблемы в способах и каналах взаимодействия: во-первых, как устранить блокировку фоновых операций, требующих времени, для переднего диалога с помощью асинхронного ReAct Loop, чтобы сессия могла принимать новые команды в любое время, не дожидаясь завершения предыдущей команды или задачи (раздел 4.1); во-вторых, когда взаимодействие происходит в разных рабочих каналах, знакомых пользователю, как сделать так, чтобы способ вывода системы соответствовал пропускной способности соответствующего канала и привычкам использования человека (раздел 4.2).
4.1 Полудуплексное взаимодействие
В классическом ReAct Loop, после того как модель инициирует синхронный вызов инструмента run (), цикл блокируется до тех пор, пока инструмент не завершит выполнение и не вернет окончательный результат, в течение этого времени сессия не может реагировать на любые новые пользовательские вводы. Чтобы устранить эту блокировку, необходимо изменить диалог из полудуплексного режима вопрос-ответ в полный дуплекс, как показано на следующем рисунке:
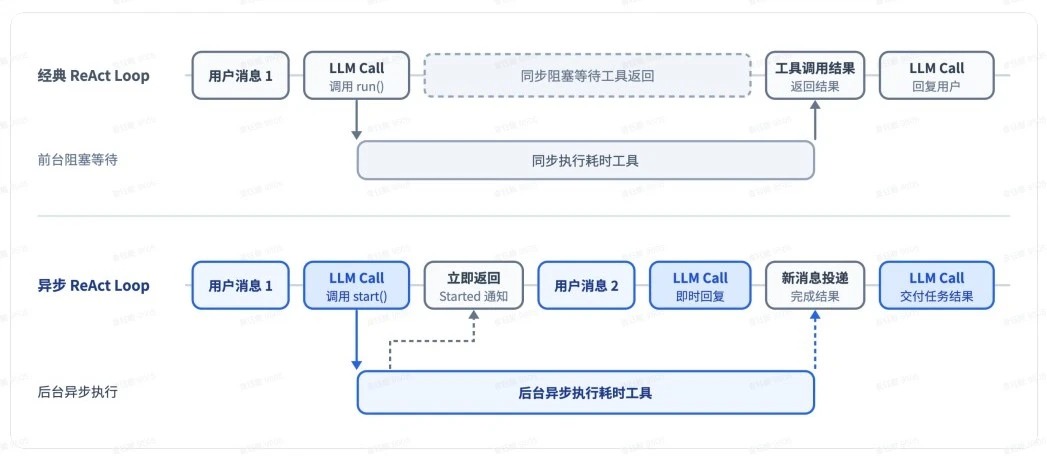
Сравнение классического ReAct Loop и асинхронного ReAct Loop: асинхронный вызов немедленно возвращает уведомление Started, в то время как фоновый инструмент может продолжать реагировать на новые сообщения.
Для этого мы изменили времязатратные команды и вызовы подзадач на асинхронные start () и stop (), создав асинхронный ReAct Loop. После вызова start () модель немедленно получает ответ «Запущено (Started)», цикл больше не ждет этот инструмент; после завершения выполнения фонового инструмента система отправляет окончательный результат как новое сообщение события в сессию; одновременно модель может также вызывать stop (), чтобы активно завершить выполнение фоновых команд, которые занимают слишком много времени.
Таким образом, отклик переднего диалога и выполнение фоновых задач становятся независимыми, Agent может реагировать на ввод человека, пока выполняет времязатратные задачи в фоновом режиме. Новый ввод обрабатывается сразу после завершения текущего шага вывода, не дожидаясь завершения фонового инструмента.
Этот механизм асинхронных задач уже реализован в DeepSeek Harness, но пока не включен по умолчанию.
4.2 Многофункциональное взаимодействие
Разные рабочие каналы имеют разную плотность информации и привычки взаимодействия, вывод системы должен соответствовать этому. Если перенести способ взаимодействия, ориентированный на одного пользователя, в групповой чат, выводя длинные процессы вывода и плотные вызовы инструментов, это может привести к избытку информации в многопользовательской среде.
В Super-agent двухуровневая архитектура уже решила часть этих проблем: длинные процессы вывода и плотные вызовы инструментов в конкретных задачах изолированы внутри Worker Session и не выводятся напрямую во внешние каналы, а Router уровень отвечает за внешнее взаимодействие. На этой основе системе также необходимо интегрировать различные рабочие среды, которые пользователь использует в повседневной жизни, и настраивать правила взаимодействия для разных каналов с помощью подсказок:
IM и другие каналы мгновенных сообщений: акцент на легком общении с низким уровнем вмешательства, как человеческие коллеги, отправляют уведомления только тогда, когда требуется решение или подтверждение, задают прямые вопросы и дают краткие выводы. Мы проверили одно простое и эффективное жесткое правило: одно сообщение не должно превышать 100 слов.
GitHub, электронная почта и документы и другие асинхронные каналы: акцент на структурированной, высокой плотности информации асинхронной доставке, например, при создании или обновлении Pull Request следует писать полное описание проблемы, объяснение изменений и результаты проверки в соответствии с проектными стандартами, или в сценарии личного помощника сразу составлять структурированные резюме для писем и документов.
5. Разделение вычислений, состояния и среды
Существующий локальный Agent по умолчанию связывает вычисления, продвигающие Agent Loop, состояние сессии, которое необходимо сохранять, а также среду выполнения, такую как репозиторий кода и локальная цепочка инструментов, на одном устройстве. Как только устройство переходит в спящий режим или отключается, Agent прекращает работу и не может получить доступ к среде на других устройствах. Чтобы Super-agent оставался постоянно подключенным и гибко интегрировался в различные реальные рабочие среды, мы можем заимствовать идею разделения вычислений и хранения (Compute-Storage Separation) из компьютерных систем, чтобы разъединить эти три элемента в два этапа: на первом этапе мы сначала отделяем вычисления, продвигающие Agent Loop, от состояния сессии, чтобы Agent освободился от ограничений жизненного цикла одного устройства и реализовал постоянное подключение в облаке (раздел 5.1); на втором этапе мы отделяем облачный Agent Loop от среды выполнения с тяжелым состоянием, позволяя реальной рабочей среде оставаться на месте и поддерживать доступ между устройствами (раздел 5.2).
5.1 Разделение вычислений и состояния
Вычисления, продвигающие Agent Loop, могут быть без состояния, в то время как состояние сессии необходимо сохранять. Поэтому первый уровень разъединения заключается в том, чтобы поместить вычисления, продвигающие Agent Loop, в облачный без состояния эластичный вычислительный контейнер, а состояние, такое как Session, хранить в базе данных. Без состояния вычислительные контейнеры могут горизонтально масштабироваться, перезапускаться или заменяться, а непрерывность сессий и задач обеспечивается за счет постоянного хранения, что позволяет Agent освободиться от ограничений жизненного цикла одного локального устройства и реализовать постоянное подключение в облаке.
5.2 Разделение вычислений и среды выполнения
После того как Agent Loop и состояние сессии находятся в облаке, дальнейшая проблема заключается в том, как получить доступ к среде выполнения, необходимой для задач. Большая часть контекста, необходимого для работы модели, должна быть получена через вызовы инструментов из репозитория кода, локальных файлов, зависимых сервисов и других сред выполнения, в этом смысле широкий контекст также включает в себя саму среду выполнения.
Существует два распространенных подхода к этой проблеме: один из них заключается в запуске песочницы в облаке, загрузке кода и попытке воссоздать и синхронизировать среду, но поскольку реальные рабочие среды часто содержат незавершенные локальные изменения, частные учетные данные, зависимости внутренних сетевых сервисов и специфическое оборудование или цепочки инструментов, технически синхронизация такой среды не только очень затратна, но и может привести к потере информации; другой подход — это требовать от пользователя отказаться от локальной среды и перейти на работу в облаке, но для многих пользователей стоимость миграции слишком высока.
Поскольку трудно копировать и синхронизировать саму среду, нет необходимости переносить среду выполнения в облако вместе с Agent Loop. Второй уровень разъединения заключается в том, чтобы Agent Loop работал в облаке, а среда выполнения с тяжелым состоянием оставалась на месте, при этом на стороне клиента разворачивается легкий демон, который не сохраняет состояние сессии, он отвечает только за выполнение команд и возврат результатов, что эквивалентно оставлению среды выполнения вне облака, позволяя Agent по запросу извлекать контекст из нее.
Этот подход согласуется с концепцией «разделения мозга и рук» (Decoupling the brain from the hands), предложенной Anthropic, также позволяя harness оставаться без состояния, сохраняя журналы сессий вне harness и подключаясь к среде выполнения по единому интерфейсу по запросу. Разница между ними заключается в сценарии. В той статье описывается управляемый сервис, в основном обсуждаются песочницы по запросу и ресурсы в клиентских VPC; здесь в первую очередь необходимо подключить личные машины пользователей, которые они используют в повседневной жизни и которые могут быть периодически онлайн, на которых есть незавершенные изменения и локальные учетные данные. Таким образом, этот дизайн поддерживает BYOM (Bring Your Own Machine), позволяя подключать используемые пользователем рабочие или личные компьютеры к облачному Agent, а также поддерживает подключение облачных управляемых машин или вычислительных сред, создаваемых по запросу.
Таким образом, Agent больше не ограничивается одним устройством, а может переключаться между различными устройствами выполнения, выбирая среду для выполнения команд и получения контекста из среды в зависимости от задачи. Он даже может поддерживать периодически онлайн устройства, например, после повторного подключения какого-либо личного устройства пользователя, облачный Agent может автоматически инициировать и завершить задачи, которые необходимо выполнить на этом устройстве. На следующем рисунке показана структура после разъединения вычислений, состояния и различных сред выполнения на два уровня:
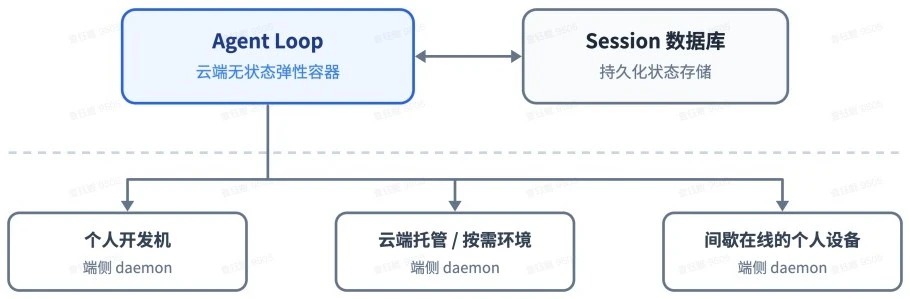
Разделение хранения и вычислений и декомпозиция среды выполнения: цикл агента и постоянное состояние отделены в облаке и подключаются к различным средам выполнения по мере необходимости через демона на стороне клиента.
6. Сторожевой пес
Для достижения постоянного подключения, помимо разделения хранения и вычислений, описанного в разделе 5, необходимо, чтобы система могла автоматически восстанавливаться от аномалий в процессе длительной работы. Распределенные системы с постоянным подключением трудно поддерживать надежными только за счет внутренней логики основной системы; необходимо вводить независимый внешний контрольный контур, то есть контрольный цикл.
В то же время в системе агента полагаться только на традиционное обнаружение живучести процессов или скрипты мониторинга недостаточно, так как многие аномалии не связаны с крахом процессов, а возникают из-за того, что модель застревает в неэффективном цикле или отклоняется от цели. Таким образом, долгосрочные системы агентов должны не только контролировать живучесть инфраструктуры, но и отслеживать прогресс самих задач.
Мы настроили независимую сессию сторожевого пса вне основной системы, которая управляется периодическими сообщениями, образуя внешний контрольный цикл. Сторожевой пес, помимо обработки ошибок интерфейса и сбоев восстановления состояния, также будет определять, есть ли у каждого рабочего реальный прогресс и отклоняется ли направление от общей цели. При обнаружении аномалий он вмешивается для исправления, а при возникновении внешних случайных сбоев продолжает проверку до восстановления нормального состояния.
Поскольку сам сторожевой пес также является сессией агента с полными инструментальными возможностями, администраторы могут задавать ему вопросы о причинах сбоев на естественном языке, а также могут позволить ему вносить изменения в поведение основной системы в режиме онлайн, например, добавлять или удалять подсказки, настраивать правила срабатывания.
7. Предварительные эксперименты
Чтобы оценить основные механизмы планирования и маршрутизации, описанные выше, мы провели предварительные эксперименты на двух уровнях: сначала с помощью экспериментов от конца до конца сравнили двухуровневую архитектуру, прямую подписку и одноразовую сессию (раздел 7.1), затем отдельно протестировали пакетную обработку на уровне маршрутизатора (раздел 7.2). Поскольку эксперименты основаны на синтетической нагрузке и упрощенной среде, некоторые настройки могут быть более строгими, и приведенные результаты следует рассматривать только как предварительные.
7.1 Эксперимент с абляцией
Мы одновременно использовали групповой чат и поток сообщений GitHub CI для управления четырьмя схемами от конца до конца: одноразовый эксперимент включал около 300 сообщений, из которых около 20 были рабочими запросами, а остальные — это разговоры, последующие действия, остановки и сообщения CI. Работы по кодированию выполнялись с помощью инструмента, который только тратит время, поэтому эксперимент измерял способности системы к планированию и сотрудничеству, а не к выполнению отдельной задачи. Каждая схема повторно запускалась 5 раз.
Сравниваемые четыре схемы включают Super-agent, Super-agent без прямой подписки, а также две конфигурации подсказок для одноразовой сессии + инструмента Subagent.
При этом нейтральная подсказка была записана как "Используйте подагента для выполнения задачи, когда это уместно…"
Подсказка о приоритете делегирования была записана как "Каждое сообщение чата доходит до вас, поэтому работа, которую вы выполняете сами, постоянно прерывается новыми сообщениями. Предпочитайте передавать каждую задачу своему подагенту и выполняйте только небольшие задачи сами…".
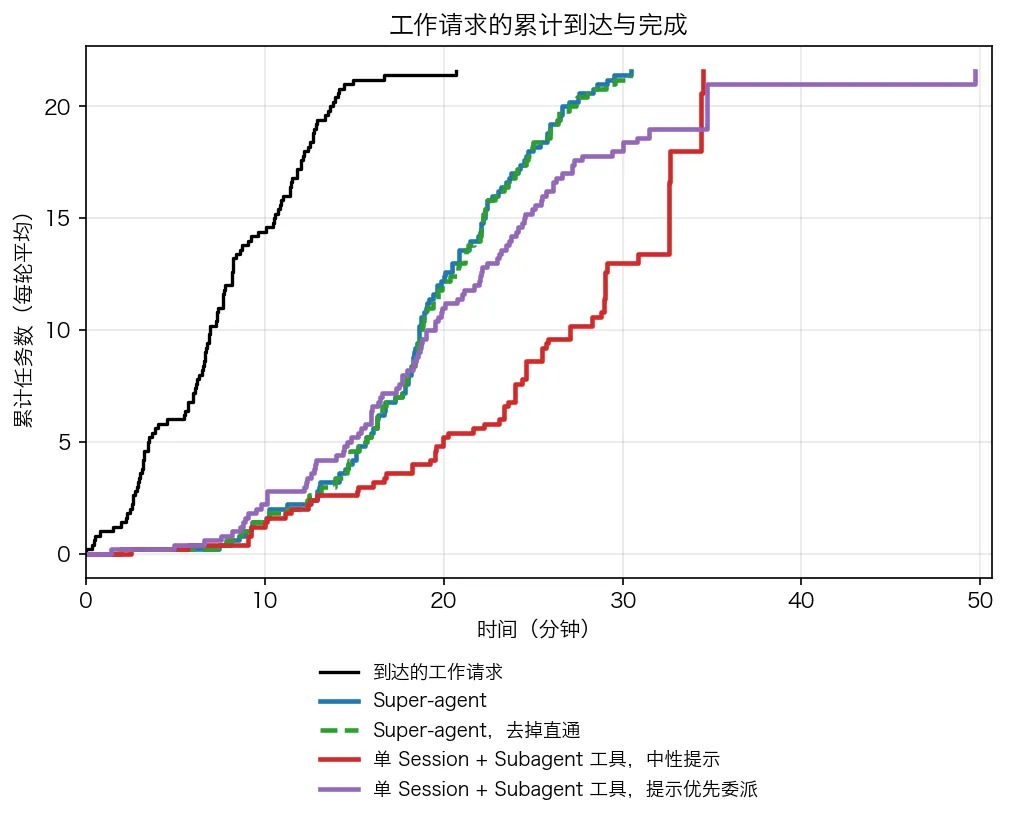
Кумулятивная кривая поступления рабочих запросов и кумулятивная кривая завершения для четырех схем (среднее значение 5 запусков эксперимента; интервалы сообщений и продолжительность работы уменьшены в 1/4, время вызова модели — реальные значения)
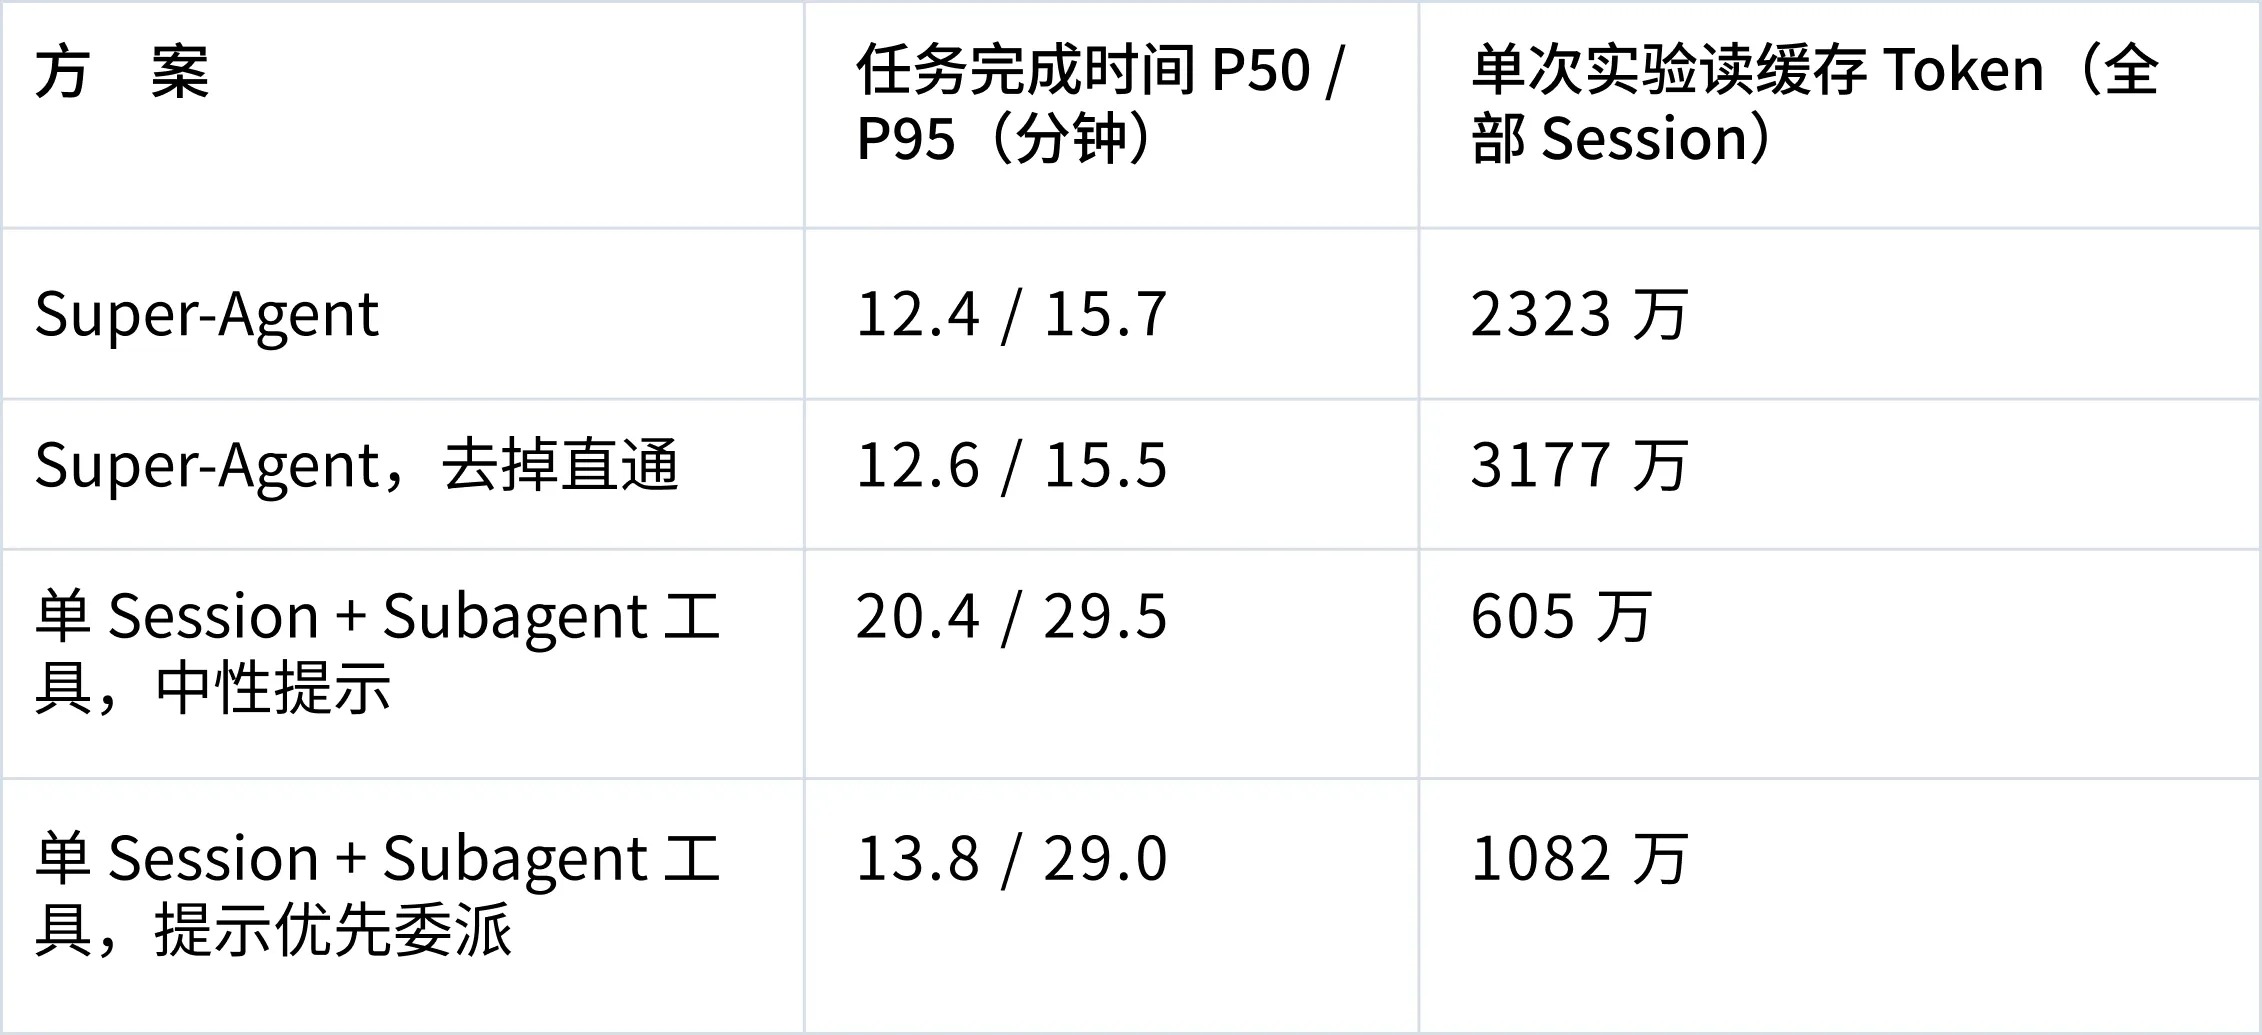
Каждая схема повторно запускалась 5 раз; время завершения задачи указывает на время от рабочего запроса до сообщения с результатом.
С точки зрения времени завершения задач, p50 и p95 для Super-agent составляют соответственно 12,4 минуты и 15,7 минуты, что значительно лучше, чем у одноразовой сессии с инструментом Subagent. Причина в том, что одноразовая сессия с Subagent в экспериментальных условиях сильно зависит от подсказок, и основная сессия часто решает выполнять задачи самостоятельно, что приводит к более длительному общему времени завершения и нестабильной производительности. При нейтральной подсказке модель ни разу не вызывала Subagent за 5 запусков; вся работа выполнялась в основной сессии и постоянно прерывалась новыми сообщениями, p95 достигло 29,5 минуты; после изменения на подсказку о приоритете делегирования модель 4 из 5 запусков делегировала задачи, время завершения сократилось, но в целом все еще было медленнее, чем у Super-agent, и в оставшемся 1 случае она решила, что работа "очень мала" и выбрала выполнить ее самостоятельно, что образовало фиолетовый длинный хвост на графике. В отличие от зависимости от подсказок и решений модели о разделении труда в одноразовой сессии, двухуровневая архитектура смягчила эту проблему на уровне системы, позволяя маршрутизатору не выполнять конкретные задачи напрямую, а рабочим получать только сообщения из подписанных потоков.
С точки зрения системных затрат, поскольку поддерживались несколько независимых сессий, количество токенов в кэше чтения для Super-agent в одном эксперименте было выше, чем для одноразовой сессии, что обеспечивало более короткое и стабильное время завершения за счет большего потребления токенов. После удаления прямой подписки внутри Super-agent время завершения задач стало практически таким же, как и в полной версии, но количество решений, которые должен был принимать маршрутизатор в одном эксперименте, увеличилось примерно на 30%, общее количество токенов в кэше чтения увеличилось с 23,23 миллиона до 31,77 миллиона, что составляет увеличение примерно на 37%. Это указывает на то, что при экспериментальной нагрузке прямая подписка не улучшает качество и скорость выполнения задач, но экономит значительное количество токенов и затрат на вывод для сессии маршрутизатора.
7.2 Пакетная обработка на уровне маршрутизатора
Чтобы проверить предельную пропускную способность одного постоянного маршрутизатора и механизм пакетной обработки, мы отдельно провели нагрузочное тестирование на уровне маршрутизатора: позволили маршрутизатору вызывать реальную модель, а рабочим использовать имитационную модель, и постепенно увеличили скорость поступления триггеров, которые необходимо было решать, с примерно 1 в минуту до примерно 40 в минуту, наблюдая за средним размером пакета, временем обработки одного запроса и временем вывода на одно решение.
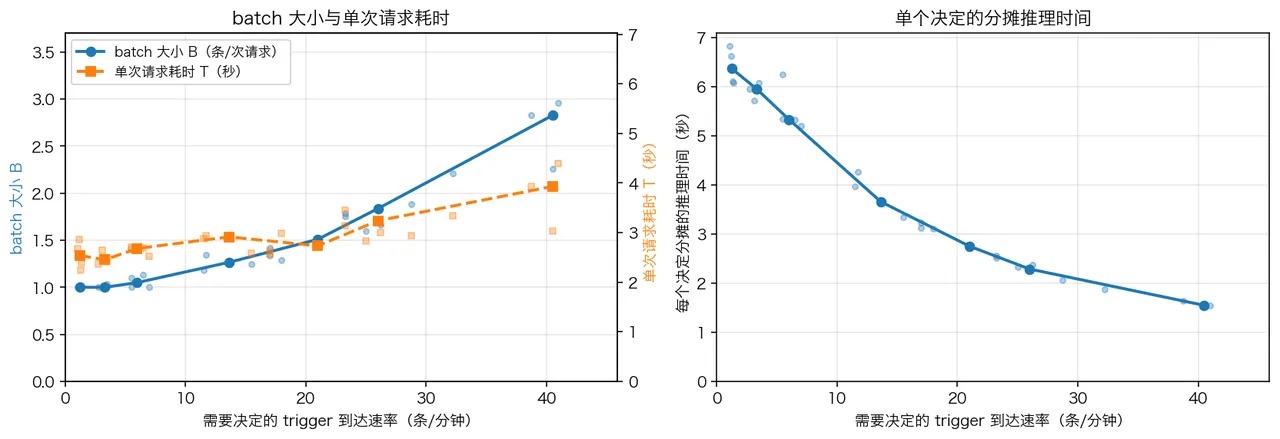
Размер пакета, время обработки одного запроса и время вывода на одно решение для сессии маршрутизатора при различных скоростях поступления триггеров
8. Открытые вопросы
Пять модулей, представленных в разделах 2-6, составляют основную архитектуру, поддерживающую работу Super-agent, а эксперименты в разделе 7 также подтвердили эффективность основных механизмов планирования и маршрутизации в условиях многозадачности. Эта система может функционировать с относительно низкой сложностью во многом благодаря тому, что на текущем этапе мы сделали ряд инженерных и сценариальных упрощений. За пределами этих упрощений, в расширении двухуровневой архитектуры (раздел 8.1), в сотрудничестве человека и машины после выхода из сессии (раздел 8.2), в границах контекста и A2A (раздел 8.3), а также в вопросах безопасности и конфиденциальности (раздел 8.4) все еще есть ряд нерешенных вопросов.
8.1 Как расширить двухуровневую архитектуру
В предыдущем тексте с помощью упрощенной комбинации "один постоянный маршрутизатор + прямая подписка + отсутствие прямой связи между рабочими" мы покрыли большинство наших повседневных задач с небольшими инженерными затратами. Однако, когда масштаб задач увеличивается и степень их взаимосвязи возрастает, выходя за пределы возможностей одного маршрутизатора, конкретная внутренняя структура не имеет окончательного решения; когда маршрутизатору необходимо горизонтальное разделение, какова должна быть степень разделения, и когда между рабочими одного уровня необходимо вводить прямую связь и какую топологию сотрудничества использовать, все еще требует проверки в большем количестве сценариев. В то же время совместный дизайн системы и модели (Co-design) также является направлением, которое стоит исследовать; специализированное обучение для задач, таких как определение событий на уровне маршрутизатора, пакетное распределение и вызов контекста, может дополнительно повысить пропускную способность и производительность принятия решений на уровне маршрутизатора.
В то же время, ранее упомянутая постоянная маршрутизаторная сессия в сочетании с цепочкой вызовов на основе графа в основном решает задачу выборки недавних задач и истории сессий по мере необходимости. Когда период работы растягивается на месяцы или даже более длительные временные интервалы, долговременная память становится основным узким местом для масштабируемости.
8.2 Как сотрудничать с агентом после выхода из сессии
В предыдущем тексте двухуровневая архитектура скрывает управление несколькими сессиями от пользователя, делая сессии не первоочередной задачей в дизайне продукта; однако, когда нижние уровни исполнительных сессий больше не соответствуют сессиям на пользовательском интерфейсе, как представить задачи пользователю и обеспечить естественное взаимодействие и формы управления проектами становится новой задачей. Мы считаем, что взаимодействие, сосредоточенное на окне чата, отчасти является результатом зависимости от пути. Взаимодействие может происходить в большей степени в специализированных интерфейсах взаимодействия, например, как в примере этой статьи, позволяя Super-agent работать непосредственно в задачах и запросах на GitHub; сессии также могут сохраняться на интерфейсе из-за привычек пользователей, но одна сессия, которую видит пользователь, на нижнем уровне может не соответствовать только одной сессии.
В то же время в предыдущем тексте в основном обсуждалось взаимодействие человека на этапах инициирования задач и проверки результатов; однако в переходный период быстрого развития возможностей модели многие задачи все еще требуют участия человека в процессе, и как в дизайне продукта учесть постепенное вмешательство пользователей в ключевые детали и эффективность автономного продвижения на заднем плане, например, позволяя пользователям вмешиваться, захватывать или работать в реальном времени с агентом в процессе выполнения на заднем плане, также заслуживает исследования.
В общем, формы управления проектами и взаимодействия, необходимые пользователю, тесно связаны с конкретной рабочей областью и личным стилем, и конечная форма, вероятно, будет высоко индивидуализированной; а DeepSeek Harness, благодаря открытой архитектуре, также легче поддерживать такую индивидуализацию.
8.3 Как определить границы контекста и осуществлять A2A сотрудничество
В предыдущем тексте обсуждался дизайн внутри одного экземпляра Super-agent, предполагая, что вся информация в пределах его области обслуживания собирается в одном глобальном контексте. Однако, когда область использования расширяется от индивидуального или небольшой команды до более крупной организации, организация, принимая решение о том, как оснастить Super-agent, на самом деле определяет границы совместного и изолированного контекста. Области, которым необходимо совместное использование контекста, должны использовать один и тот же экземпляр, а области, которые необходимо изолировать, должны быть оснащены независимо.
Далее, если в организации или между организациями существует несколько изолированных экземпляров, например, личные помощники каждого члена и общий Super-agent, то в этом случае межагентное взаимодействие (A2A, не указывая на конкретный протокол) становится необходимым. При отсутствии общего контекста и представлении различных границ полномочий, как обеспечить безопасное и надежное A2A взаимодействие и сотрудничество, требует дальнейшего изучения.
8.4 Как обеспечить безопасность и конфиденциальность
Событийно-ориентированный дизайн из раздела 3 позволяет Agent быть более широко управляемым окружающей средой, но также увеличивает риск взаимодействия с ненадежными входными данными. Если не удастся эффективно решить проблемы безопасности и конфиденциальности, то Super-agent сможет работать только в очень ограниченной и доверенной среде.
Например, в разделе 5 Agent Loop развертывается в облаке, и на различных устройствах устанавливаются легковесные демоны, что предполагает доверие между облачной и конечной средой. Однако, когда облачный Agent Loop постоянно подключается к событиям внешней среды, а на конечных устройствах находятся приватный код, чувствительные данные и локальные учетные данные, такое межустройственное соединение вводит значительные риски для безопасности и конфиденциальности. Если облачный Agent Loop подвергнется атаке со стороны сервера или инъекции подсказок, все подключенные конечные устройства окажутся под угрозой контроля.
Кроме того, даже если облако не было взломано, как только учетные данные в конечной среде могут попасть в контекст модели, существует риск утечки учетных данных в процессе нормального выполнения; поэтому необходимо разработать соответствующий механизм, позволяющий Agent использовать учетные данные, не имея к ним доступа. Если эта архитектура должна перейти к более широкому применению, необходимо решить вышеупомянутые проблемы безопасности и конфиденциальности, одновременно обеспечивая возможность извлечения контекста из разнообразной среды.
9. Заключение
Оглядываясь на весь дизайн, мы не представили новую теорию, а применили классические инженерные идеи из компьютерных систем к построению Agent-систем. Конкретные способы реализации будут эволюционировать с развитием технологий, но мы считаем, что основные идеи системного дизайна имеют более долгосрочную ценность. В настоящее время внутренний экземпляр Super-agent, построенный на этой основе и DeepSeek Harness, продолжает работать, участвуя в воспроизведении и исправлении проблем, реагировании на код-ревью и итерациях самого DeepSeek Harness.
Как было сказано в начале, с уменьшением необходимости человеческого вмешательства в выполнение отдельных задач большими моделями, узкие места, ограничивающие дальнейшее повышение производительности, смещаются к вниманию человека. Через двухуровневую архитектуру, событийный подход, асинхронное многоканальное взаимодействие, разделение хранения и вычислений и внешнего Watchdog, система на базовом уровне берет на себя сложное управление сессиями и синхронизацию контекста, позволяя человеку перейти от конкретных деталей выполнения к более высоким уровням принятия решений и приемки.
В этой форме Agent больше не является просто пассивным окном для ожидания команд, а эволюционирует в автономного сотрудника, постоянно онлайн в цифровой среде: для индивидуумов это может быть личный помощник, который помогает обрабатывать повседневные дела на разных устройствах; для команд он интегрируется в рабочие процессы разработки, принимая и продвигая конкретные задачи. Мы верим, что с совместной эволюцией возможностей моделей и базовой системной архитектуры такой более автономный способ работы может стать нормой для сотрудничества человека и машины.
Часть дизайна этой статьи уже реализована в dsh-superagent-prototype. Этот плагин является прототипом, предоставленным для проверки технологического направления, а не официальным продуктом DeepSeek.
Автор и благодарности
Эта статья основана на совместной практике команды DeepSeek Harness. Юцзя Цяо завершила реализацию системы и написание этой статьи, Хуанци Цао, Цзуй Чен, Сьетин Чу, Тяньи Цуй, Шиюань Фэн, Юдун Хан, Кексин Лю, Шичун Лю, Гэси Ло, Ифань Ши, Тунжуй Сюн, С. С. Ю, Цзия Чжан, Ф. Чжоу и другие участвовали в рецензировании, обсуждении и предоставлении отзывов. Реализация системы и формирование статьи невозможно без повседневного общения и накопления команды.
 Предупреждение о рисках
 Предупреждение о рисках


Популярные статьи





